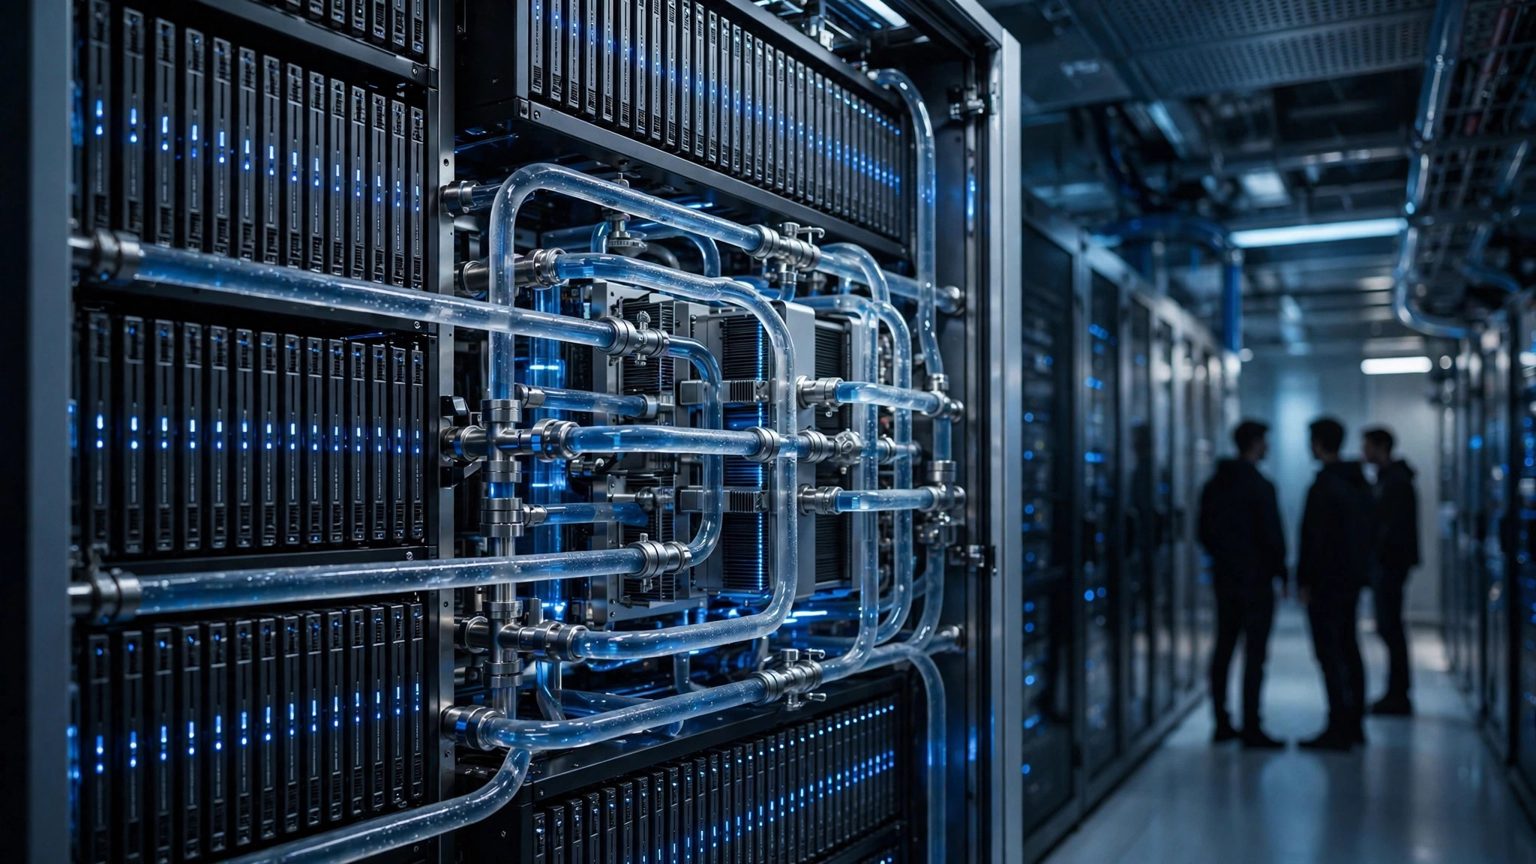
AMD Helion 在 2026 年 10 月 12 日由 AMD 官方新闻稿正式发布:这是一套面向智能体 AI 的机架级开放蓝图,基于开放计算项目(OCP)的规格设计,主打的不是又一款 GPU 服务器,而是让客户按智能体负载自由搭配 CPU 核心密度、性能和功耗,相关配置计划 2026 年 11 月起与生态伙伴一起上市。
两种典型配置:纯 CPU 跑执行,混搭版管推理
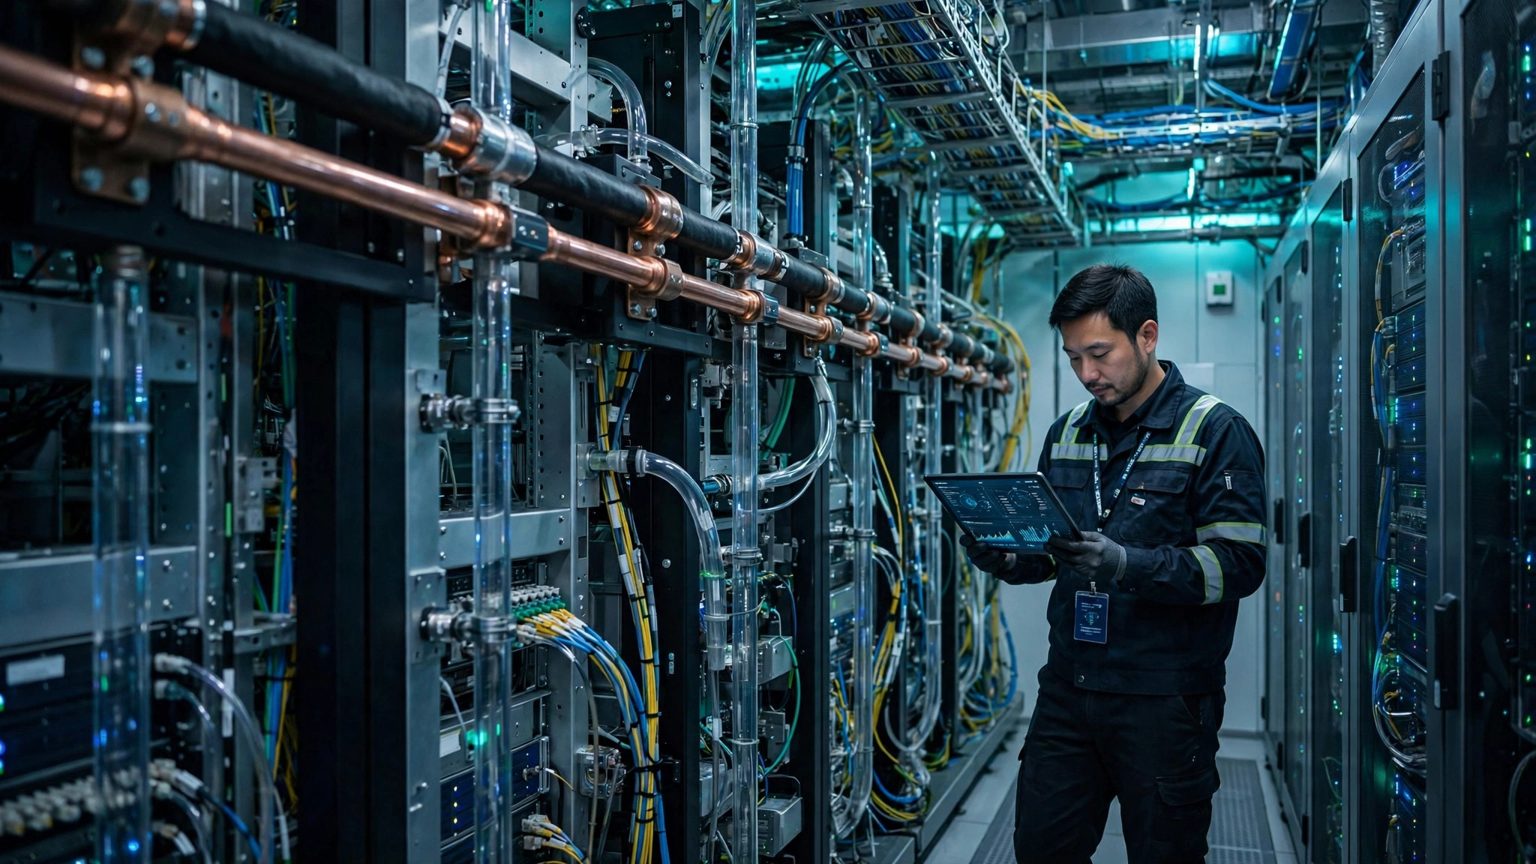
Helion 给了两个参考形态。一种是纯 CPU 机架,采用第六代 AMD EPYC 处理器,最高可扩展至 32,768 个 CPU 核心,面向超大规模客户:智能体的代码执行、工具调用和任务调度放在这台机架上,模型推理则连接外部独立的推理基础设施。另一种是一体化机架,把 EPYC CPU 节点、Instinct MI350P GPU 节点和通用计算放在同一平台上,面向企业客户一次配齐。蓝图还内置了一个 token 路由器,负责把智能体的模型调用分发到前沿模型或开源模型上。机架支持液冷和风冷两种版本,AMD 计划把 Helion 规格贡献给 OCP 社区。
为什么智能体需要单独一种机架
AMD 在发布中强调,智能体负载不是单一负载:个人助手、企业应用、代码执行和复杂工作流的算力需求各不相同。传统 AI 机架按 GPU 推理吞吐设计,而智能体大量时间花在执行代码、调用工具和等待外部服务上,这些环节吃的是 CPU 和调度效率,不是显卡。Helion 的思路是把执行层和推理层拆开配比,客户不必为了跑智能体先买一整柜 GPU。这也是它选择开放蓝图而非整机独占的原因:思科、戴尔、HPE、联想、超微等伙伴都已表态支持,靠生态铺开比自己卖整机更快。
对采购方的实际意义
对正在规划智能体落地的团队,Helion 提供了一个新的比价基准:先区分自己的负载里执行和推理各占多少,再决定 CPU 与 GPU 的配比,避免按峰值推理需求过度采购 GPU。需要注意的是,目前公布的是参考蓝图和伙伴计划,具体整机价格、交付形态要等 11 月伙伴产品落地后才清楚;已有 AMD Helios 机架的客户如何衔接,也要看各厂商的方案。