Transformer 是 2017 年 Google 在论文《Attention Is All You Need》中提出的一种神经网络架构,也是今天几乎所有大语言模型的底层骨架——GPT、Claude、Gemini、Llama、DeepSeek 这些名字你都听过,它们内部跑的都是 Transformer,或者它的变体。它的核心突破可以用一句话概括:不再让机器一个词一个词地顺序读书,而是让它一眼看到整句话,自己判断每个词该关注哪里。
要理解为什么这事重要,先想想"银行"这个词。"我在银行门口等你"和"我去银行存了笔钱",同一个词意思完全不同。机器要怎么知道"银行"在这里指什么?只能看它周围的词。Transformer 做的就是这件事:让句子里的每个词都去"打量"其他词,搞清楚自己在当前语境下的真实含义。这种能力,就是大模型理解上下文的根基。
自注意力:每个词都在给自己找语境
看这句话:"小猫坐在垫子上,因为它很柔软。"人一眼就知道"它"指的是垫子。但对机器来说,"它"可以是小猫,也可以是垫子,怎么选?
Transformer 的处理方式是给每个词发三张"名片":查询(Query,我想找什么样的信息)、键(Key,我是什么样的词)、值(Value,我实际携带的内容)。然后让"它"的查询去和全句每个词的键做匹配,算出亲疏远近:和"垫子"的匹配度高,和"小猫"的匹配度低。最后按这个亲疏程度,把各词的值加权混合——"它"的向量里就混入了大量"垫子"的信息,机器于是"知道"了它指代谁。
这个过程叫自注意力(Self-Attention)。更妙的是"多头":模型会同时派出好几组查询,有的盯语法关系,有的盯指代关系,有的盯情感色彩,多个视角的结果拼在一起,就是对这句话相当完整的理解。
编码器和解码器:同一架构,两种活法
最初的 Transformer 像一条翻译流水线:编码器负责"读懂"输入,解码器负责"写出"输出。后来人们发现可以拆开用,于是分出两条路线。
只用编码器的代表是 BERT 一家:它们擅长理解——文本分类、情感分析、搜索排序,把文字变成向量表示后做判断,但不擅长长篇生成。只用解码器的代表是 GPT 一家:它们擅长生成——一个词一个词往外续写,聊天、写作、代码都靠它。今天你用的聊天大模型,清一色是解码器路线。
和 RNN、CNN 比,它赢在哪
Transformer 之前,主流是 RNN(循环神经网络)和 CNN(卷积神经网络)。RNN 的问题是必须一个词一个词顺序读:读到第 100 个词时,第 1 个词的信息已经传丢得差不多了,而且这种串行方式没法并行训练,数据再多也吃不下。CNN 擅长抓局部特征,但句子开头和结尾的远距离关系,它看不见。
Transformer 的解法是让任意两个词之间都"一步直达",没有信息传递的链条损耗;同时整个句子可以一次性并行计算。这两个特性加在一起,意味着它能吃下互联网级别的海量文本,而且模型越大效果越好——这正是大模型"大力出奇迹"的技术前提。
三个常见误解
误解一:Transformer 就是大模型。不是。Transformer 是架构,是骨架;模型是训练出来的具体成品。同一个骨架,参数规模、训练数据、调优方法不同,做出来的模型能力天差地别。把架构和模型混为一谈,就像把"砖混结构"和"一栋楼"混为一谈。
误解二:用了 Transformer 就一定聪明。不是。架构只是起点,数据质量、训练方法和对齐调优至少同等重要。一个用劣质数据训练的 Transformer 模型,照样满口胡话。架构决定上限的形状,训练决定能不能摸到上限。
误解三:Transformer 是终点。不是。它是 2017 年的设计,计算量随序列长度平方增长——这就是为什么上下文窗口有上限、长文本又贵又慢。Mamba、RWKV 这些新架构在长序列效率上各有优势,混合专家(MoE)则是在 Transformer 骨架上做扩展。今天它是主流,不代表十年后还是。
它用在哪:远不止聊天机器人
大语言模型是最出名的应用,但 Transformer 早已跨界:视觉领域的 ViT 把图片切成小块当"词"来处理;多模态模型用同一套机制对齐文字、图像和声音;扩散生图模型里也有注意力模块在协调画面各部分的关系;语音识别、代码生成,乃至预测蛋白质结构的 AlphaFold2,核心里都有注意力的影子。可以说,哪里需要处理"序列中元素之间的关系",哪里就有 Transformer 的变体。
普通人最该记住的三件事
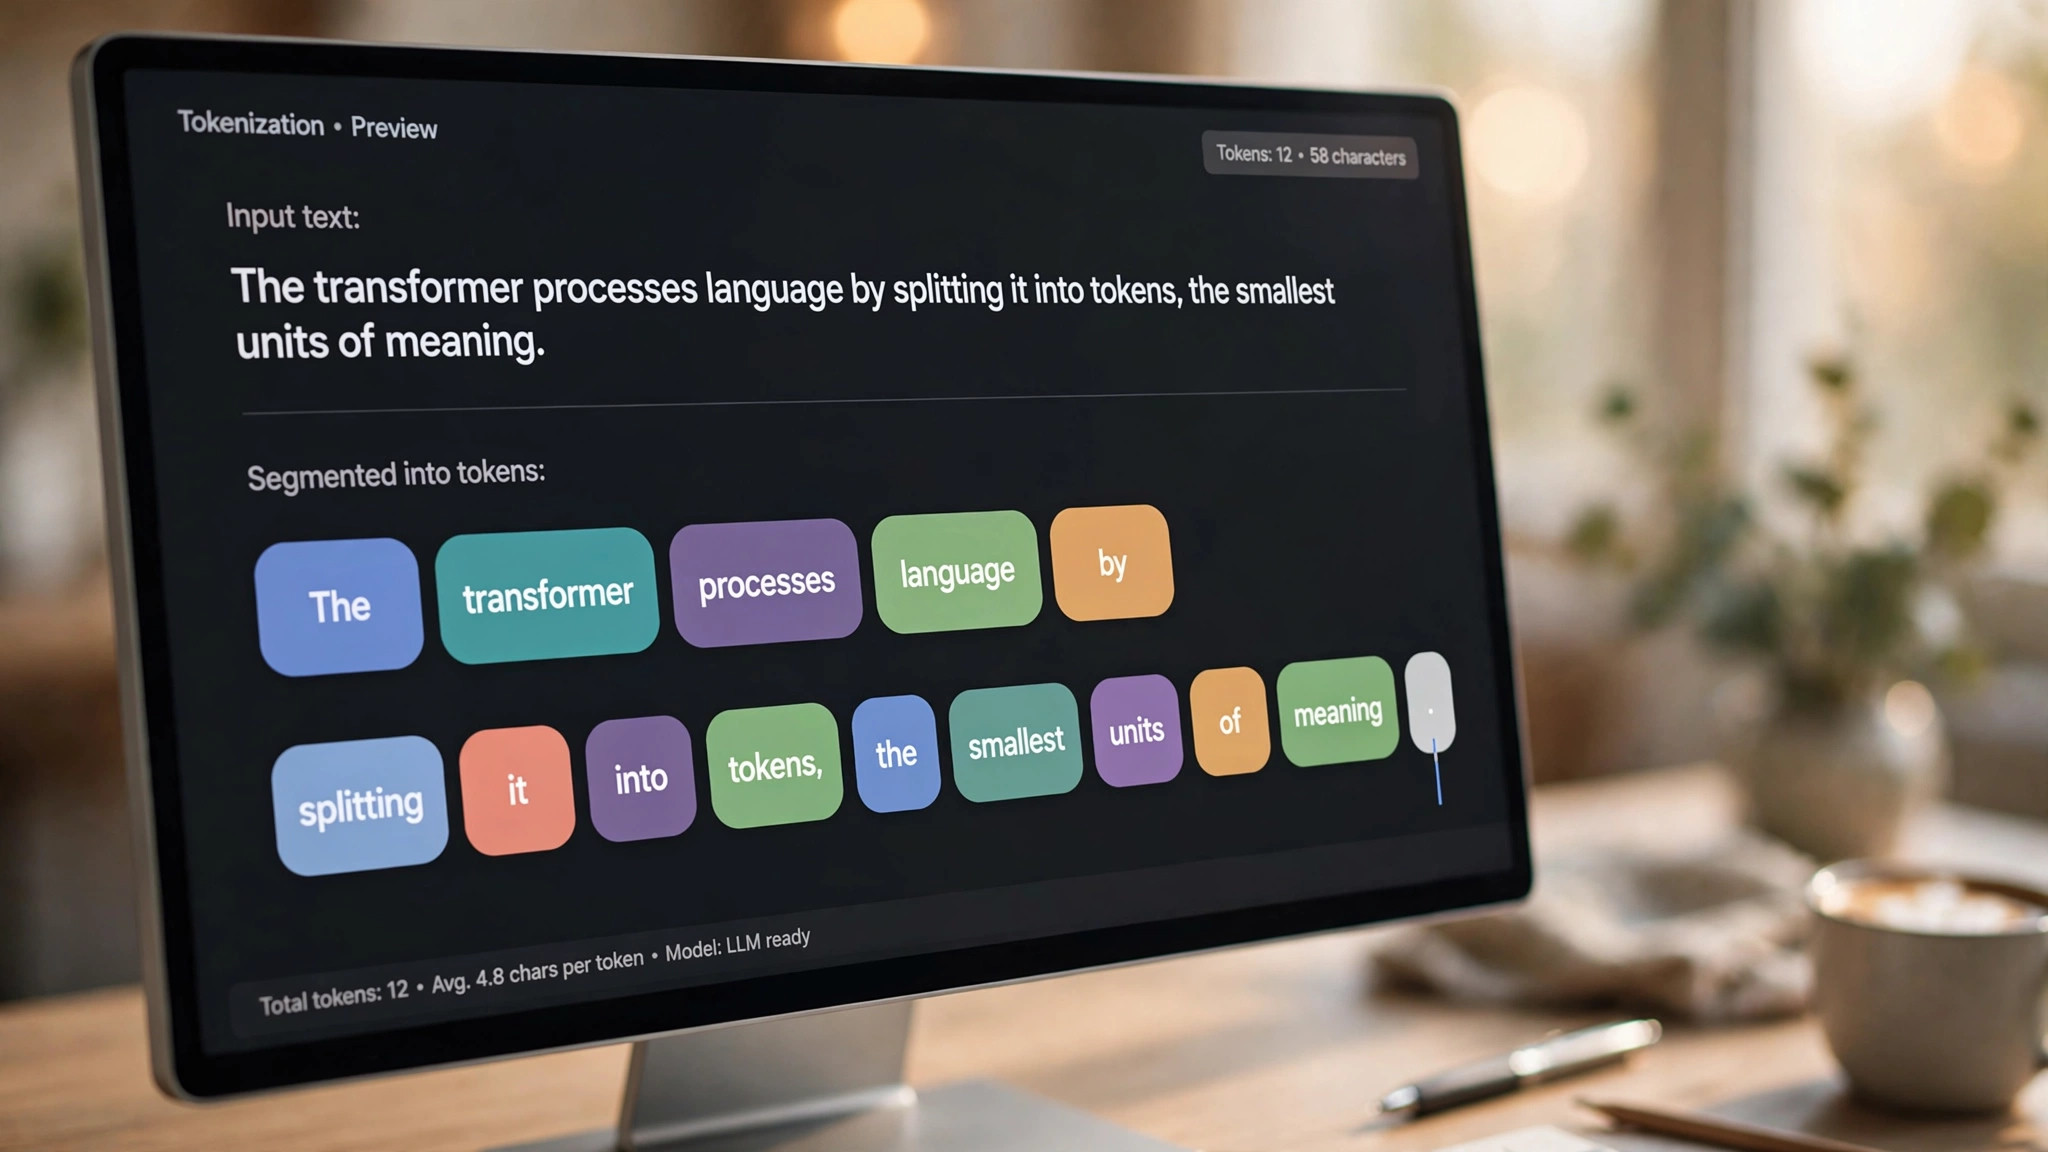
第一,大模型是"续写"机器。它一次生成一个词,每个词都是根据前文概率最高的延续,不是在"思考"对错。这解释了它为什么文笔流畅,却可能一本正经地编造事实。
第二,上下文窗口是它的"工作记忆"。窗口之外的信息它看不见,窗口越大推理越慢越贵。给它超长文档时,关键信息放前面、结构清晰,比一股脑全塞进去更有效。
第三,它擅长的是语言模式,不是事实核查。架构本身不保证真实性,重要信息——尤其是数字、日期、人名——养成自己再核实一遍的习惯。
把这三条记住,你对大模型的理解就已经超过了大多数只把它当"更聪明的搜索引擎"的人。