DPO
DPO直接用成对偏好数据优化大模型,省去奖励模型与强化学习环节。内容对比它与RLHF的流程差异、适用条件和过拟合等局限。
专题介绍
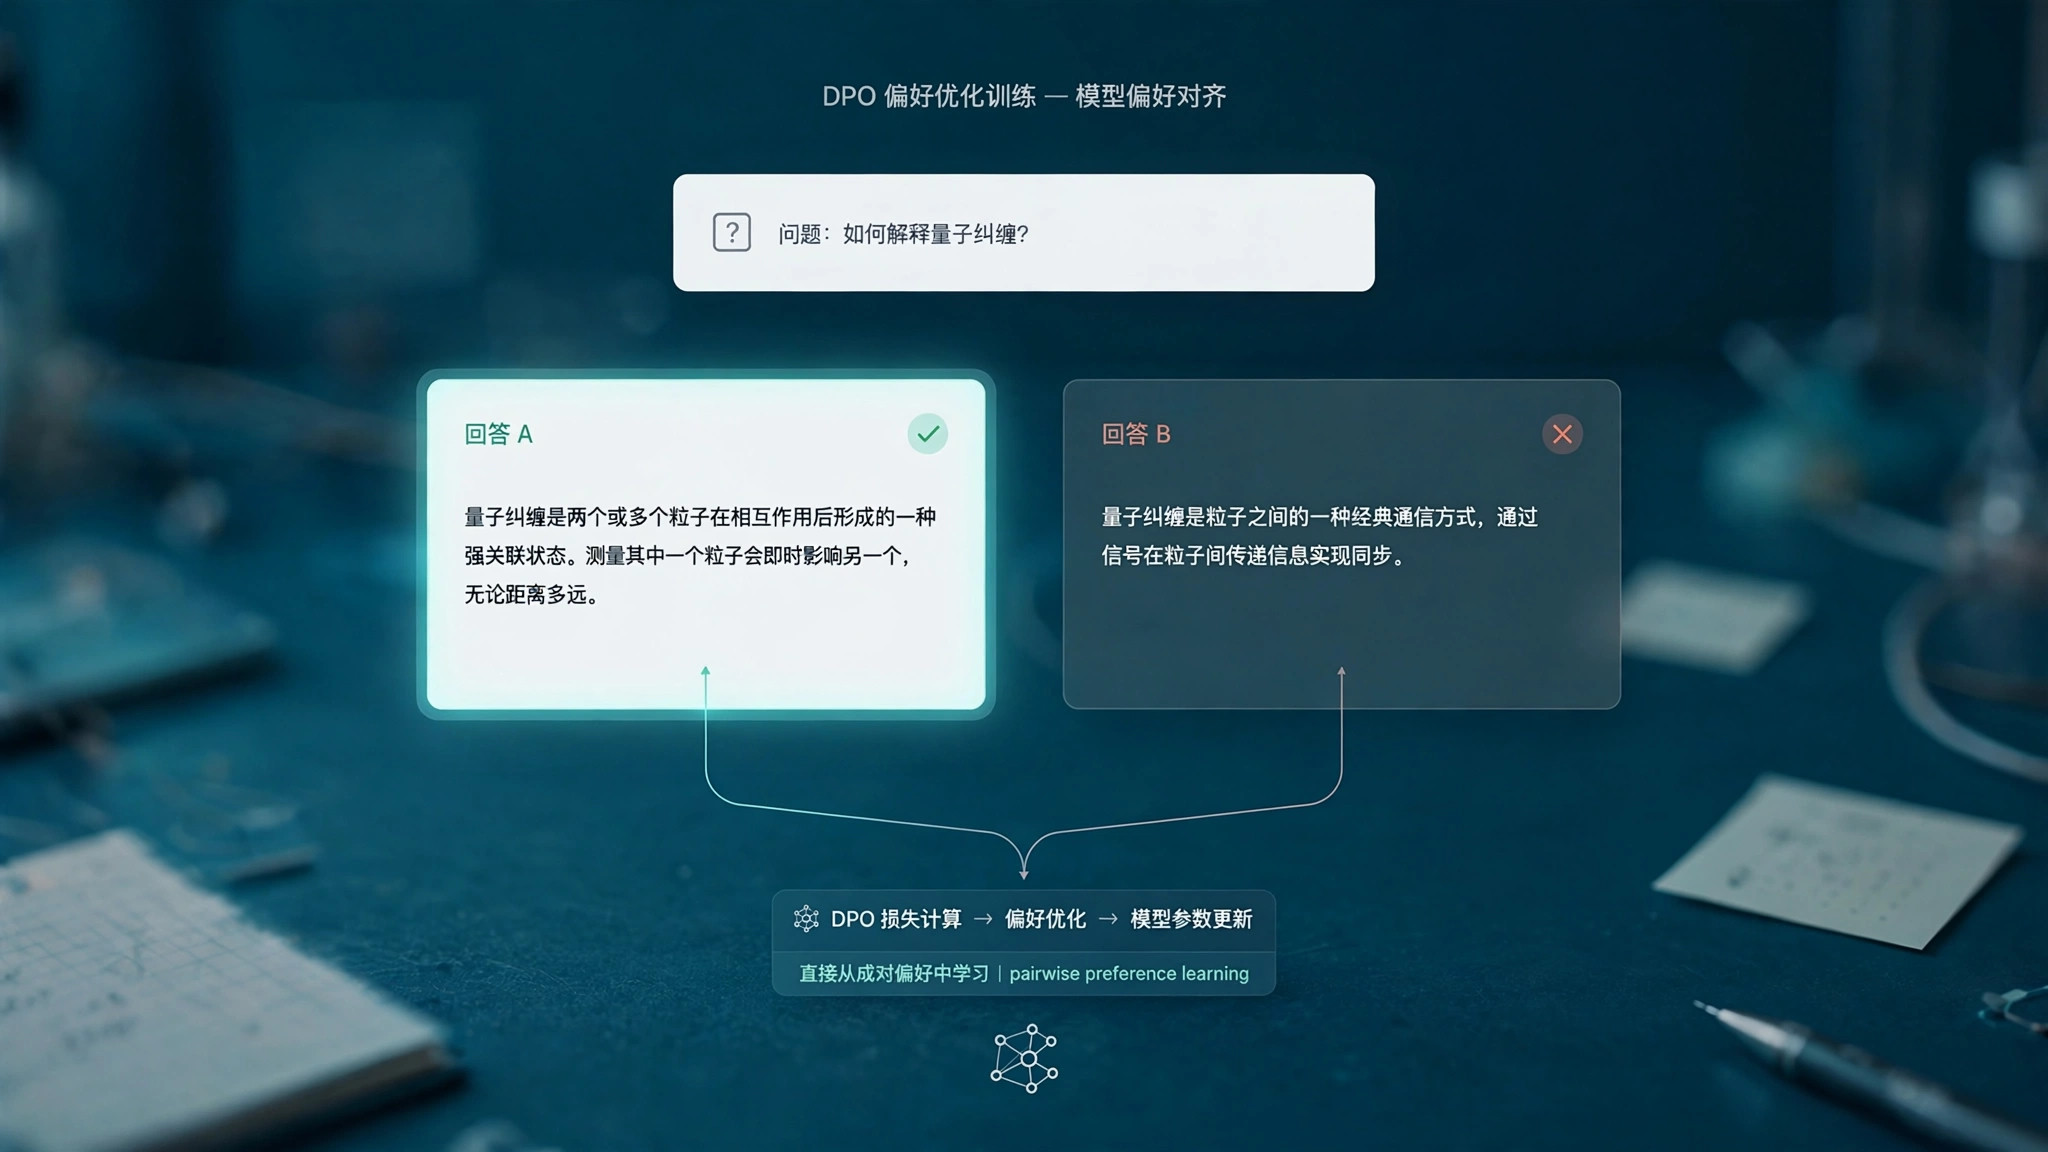
DPO把人类偏好直接写进一条可训练的损失函数:同一问题下被选中的回答概率往上推,被拒绝的往下压,同时用参考模型约束偏移幅度。专题拆解它为何能绕开奖励模型、β参数管什么,也讲清偏好数据质量、分布外问题与长度偏好等它解决不了的边界。
DPO直接用成对偏好数据优化大模型,省去奖励模型与强化学习环节。内容对比它与RLHF的流程差异、适用条件和过拟合等局限。
DPO把人类偏好直接写进一条可训练的损失函数:同一问题下被选中的回答概率往上推,被拒绝的往下压,同时用参考模型约束偏移幅度。专题拆解它为何能绕开奖励模型、β参数管什么,也讲清偏好数据质量、分布外问题与长度偏好等它解决不了的边界。