奖励模型是给大模型回答打分的专用模型:它不直接回答问题,而是对同一个提问下的不同回答各给一个分数,分数越高,代表它判断人类越可能喜欢这个回答。训练它的信号不是标准答案,而是人挑出来的成对偏好——两个回答摆在一起,哪个更好。它只在“相对好坏”上有意义,单独一个分数的高低,并不代表回答绝对正确。
奖励模型怎么训出来:只比高低,不教对错
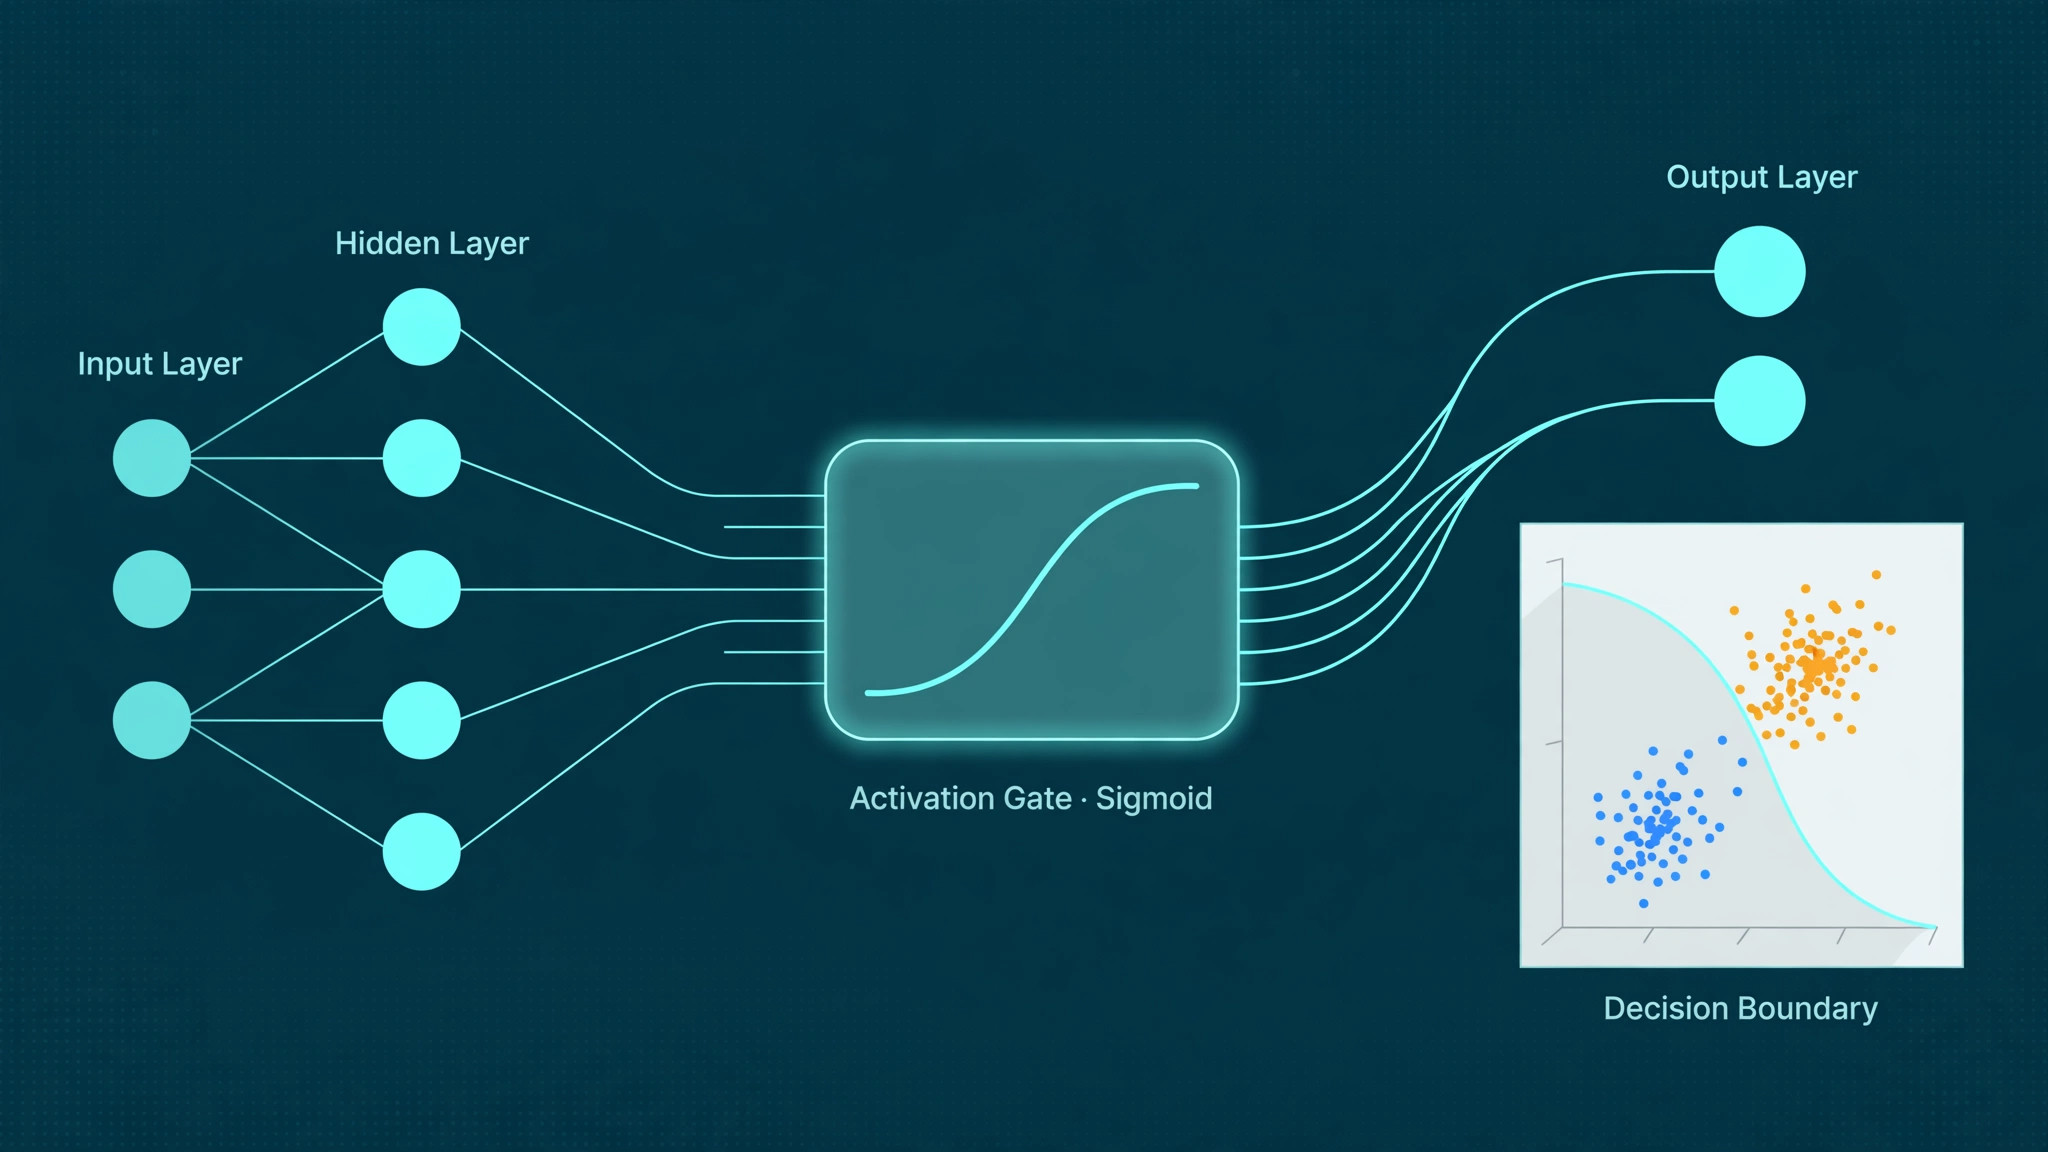
训它先要攒成对数据:同一个提问配两个回答,标注者只选更好的那个。训练让被选中的回答得分高于被淘汰的,分差越大,越符合人的选择。实现上,它常从预训练模型改来,把预测下一个词的输出头换成只输出一个分数的打分头,读完“提问加回答”全文后打分。
训好后分数有两种用法:在强化学习阶段当奖励,模型不断生成、逐个打分,再往高分方向推,同时加约束不让它离原版本太远;或一次生成多个回答,直接选分数最高的交出来。
它不是评分员,也不是考试的标准答案
它和人工评分员不一样:评分员一次判断只影响一次,奖励模型是把许多人的判断学进参数、做成可批量调用的“口味副本”,省人力,却也把偏见一起复制下来。它和评测基准也不一样:基准多半有固定答案,它处理的是没有唯一答案的开放问题,评合意程度,不评对错。
和直接偏好优化的区别,在于有没有独立打分器:后者跳过奖励模型和强化学习,直接拿成对偏好训练模型,更简单,却只能学数据集里现成的回答对。能自动验算的任务还可用计算结果或测试通过当奖励,那是可验证奖励,和人类偏好分数适用范围不同。
分数会骗人:先看数据来源,再信分数
分数最值得警惕的毛病,是可以被钻空子:回答更长、排版更整齐、语气更自信,往往更容易拿高分,模型练久了会用表面特征换分,内容未必变好,这就是奖励投机。标注者尺度本来就不一致,模型学到的,常是数据里占多数的那种口味。
分数高也不等于事实对:语气格式拿高分、内容却是编的,完全可能,事实问题要靠检索和核查。读模型说明时,先问偏好数据从哪来、谁标的、有没有查过奖励投机,比只记人类反馈强化学习这个名字更有用。对齐调的是回答倾向,不是知识本身,分清这一点,就不会把奖励模型当成质检员。