
本地部署
数据不许出内网、云账单越跑越贵,就该考虑把模型搬回本地。llama.cpp、Ollama、GGUF 量化这些本地推理方案怎么搭、硬件怎么选,这里一次讲透。
专题介绍
本地部署不是把云端模型下载下来那么简单:显存、量化格式、推理框架,哪个环节没算对都会翻车。本专题讲清本地跑大模型与调云 API 的取舍,整理 llama.cpp、MLX、GGUF 等方案的实操要点,帮你在隐私、成本与效果之间找到平衡。
NVIDIA DGX Spark 推出 64GB 版:4999 美元起,本地跑千亿参数模型
AI资讯 AI导航 24 次阅读
本地部署大模型要什么电脑配置?显存、模型和隐私一次讲清
AI问答 AI导航 26 次阅读
模型蒸馏是什么意思?小模型为什么能学到大模型的本事
AI百科 AI导航 25 次阅读
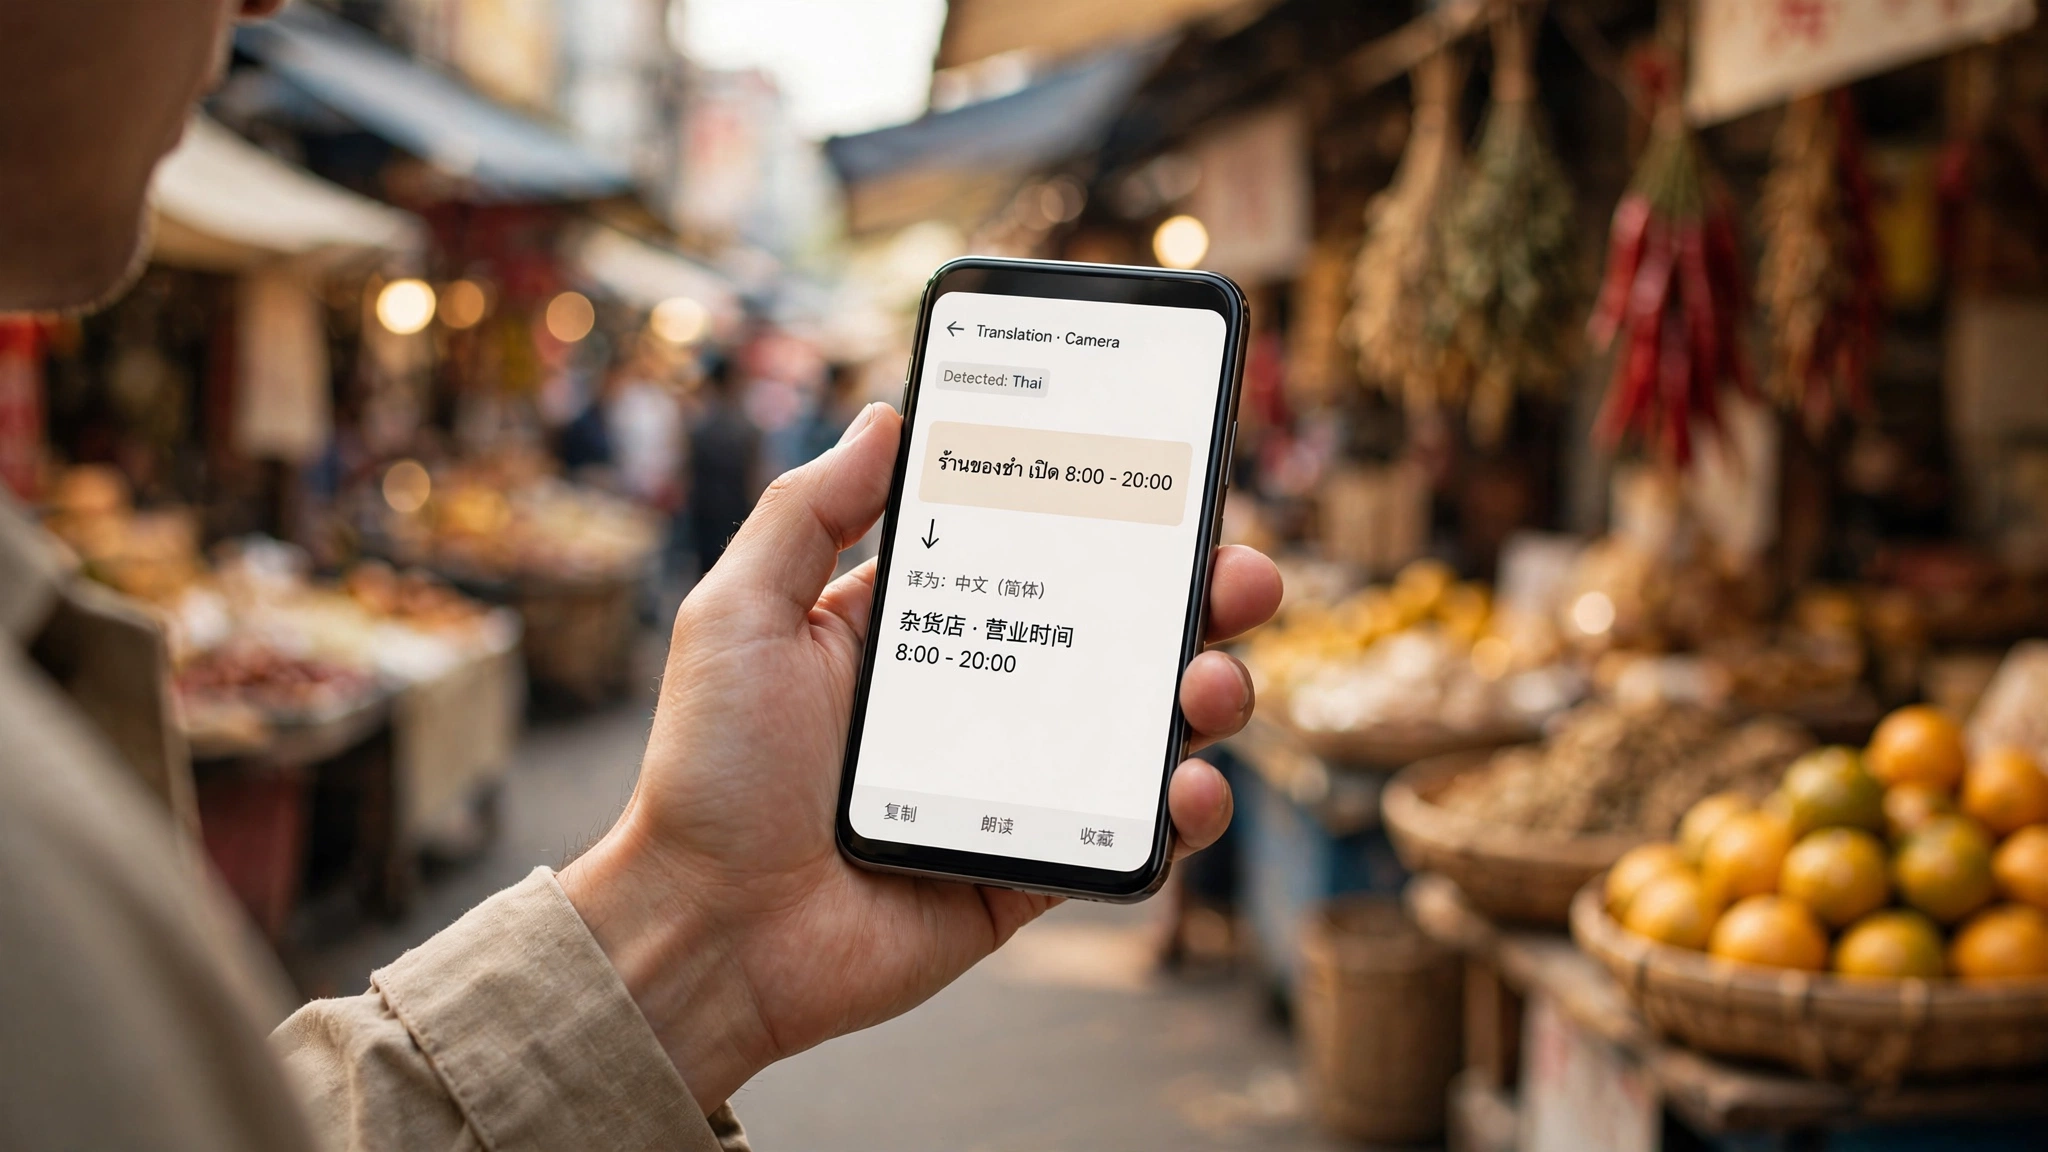
腾讯Hy翻译App今日上线:33种语言互译,语音拍照离线都能用
AI资讯 AI导航 20 次阅读
本地部署大模型是什么意思?和云 API 比有什么取舍
AI百科 AI导航 22 次阅读
Hugging Face 让 transformers 直接加载 GGUF:本机推理提速,接近 llama.cpp
AI资讯 AI导航 25 次阅读
llama.cpp发布b8234:本地大模型推理框架继续强化性能与部署适配
AI资讯 AI导航 39 次阅读

Qwen3 MLX 与 LLaMA3 MLX 性能对比:谁更适合本地推理?
AI资讯 AI导航 134 次阅读