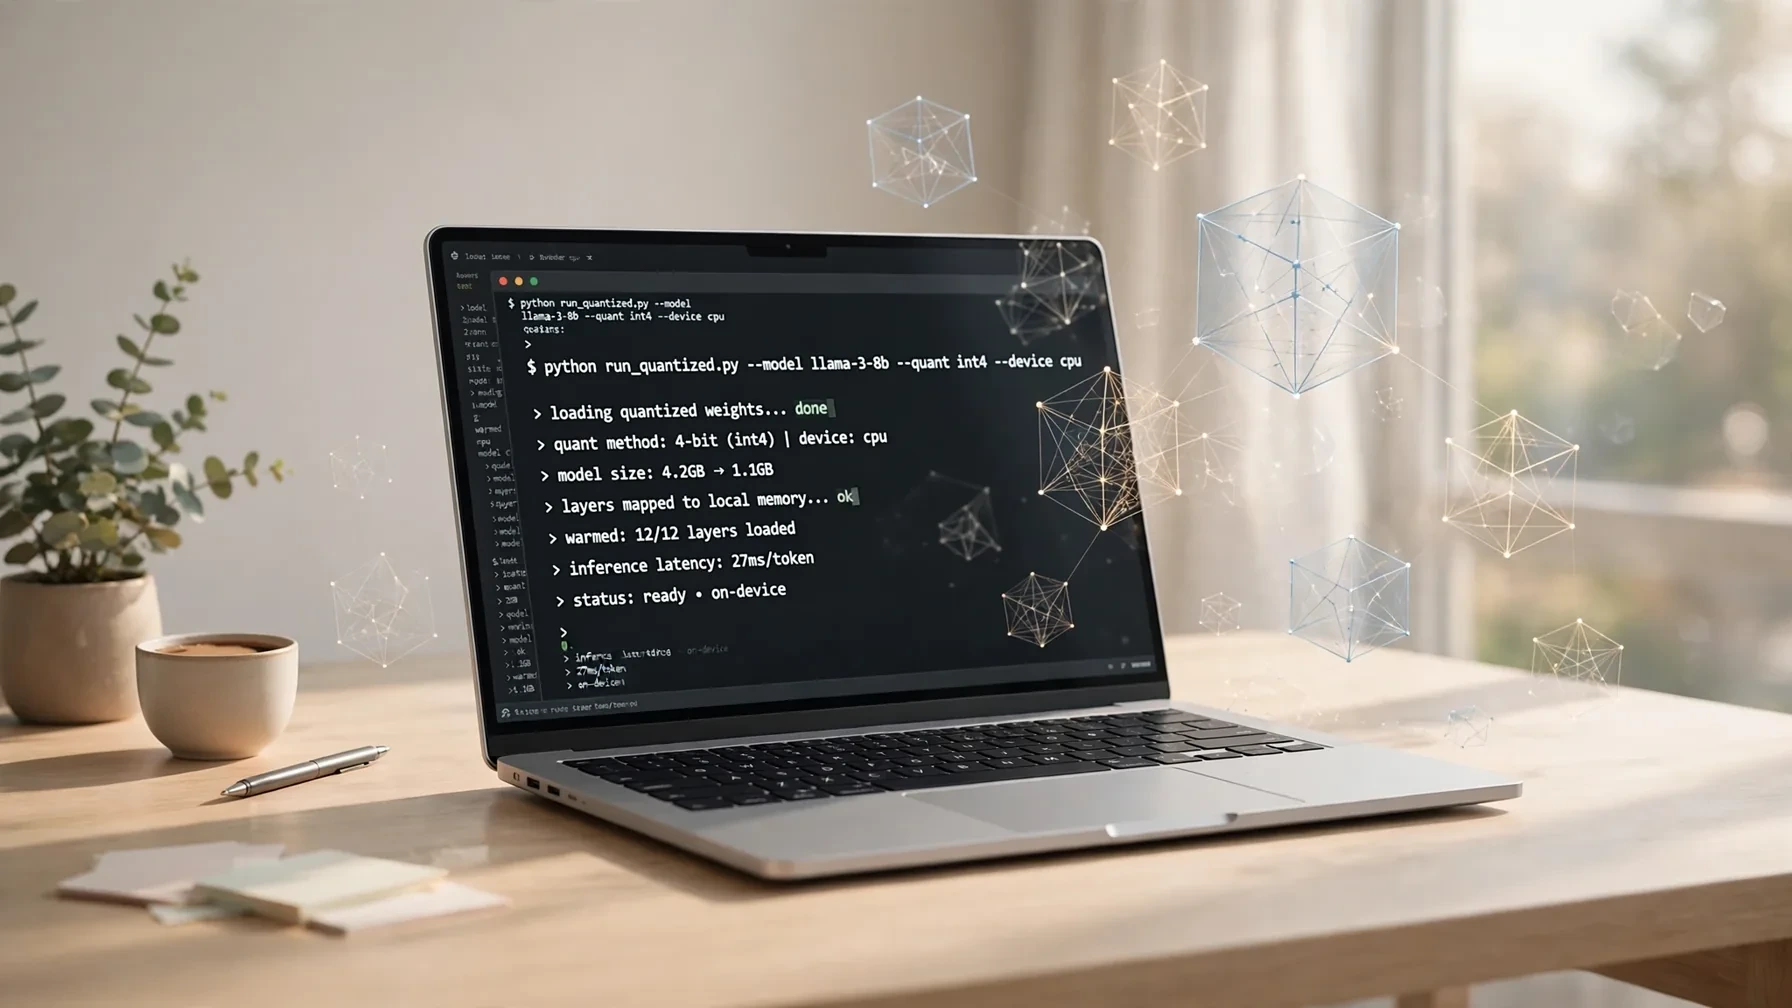
模型量化
把模型权重从高精度换成低精度存储与计算,在尽量保住效果的前提下压小显存占用、加快推理速度,讲清 INT8、INT4、GGUF 与 AWQ 的取舍。
专题介绍
权重该用几比特存、哪些层最怕精度损失、校准数据怎么选,以及量化之后的速度和效果该怎么验,是理解模型量化绕不开的四件事。相关内容会把 GPTQ、AWQ、GGUF 这类常见方案放在本地部署和推理优化的真实约束下比较,帮你判断一个模型该不该量化、量化到哪一档,而不是只看文件小了多少。
把模型权重从高精度换成低精度存储与计算,在尽量保住效果的前提下压小显存占用、加快推理速度,讲清 INT8、INT4、GGUF 与 AWQ 的取舍。
权重该用几比特存、哪些层最怕精度损失、校准数据怎么选,以及量化之后的速度和效果该怎么验,是理解模型量化绕不开的四件事。相关内容会把 GPTQ、AWQ、GGUF 这类常见方案放在本地部署和推理优化的真实约束下比较,帮你判断一个模型该不该量化、量化到哪一档,而不是只看文件小了多少。