
强化学习
围绕强化学习如何训练大模型与智能体展开,涵盖奖励设计、训练范式、开源框架与效果评估,帮助读者判断这类方法的适用边界。
专题介绍
强化学习通过奖励与惩罚信号引导模型在试错中改进策略,是大模型后训练与智能体能力提升的重要方法。内容涵盖奖励建模、策略优化、智能体强化学习框架、训练数据与公开评测,也讨论奖励投机、训练不稳定等常见问题及其适用条件。
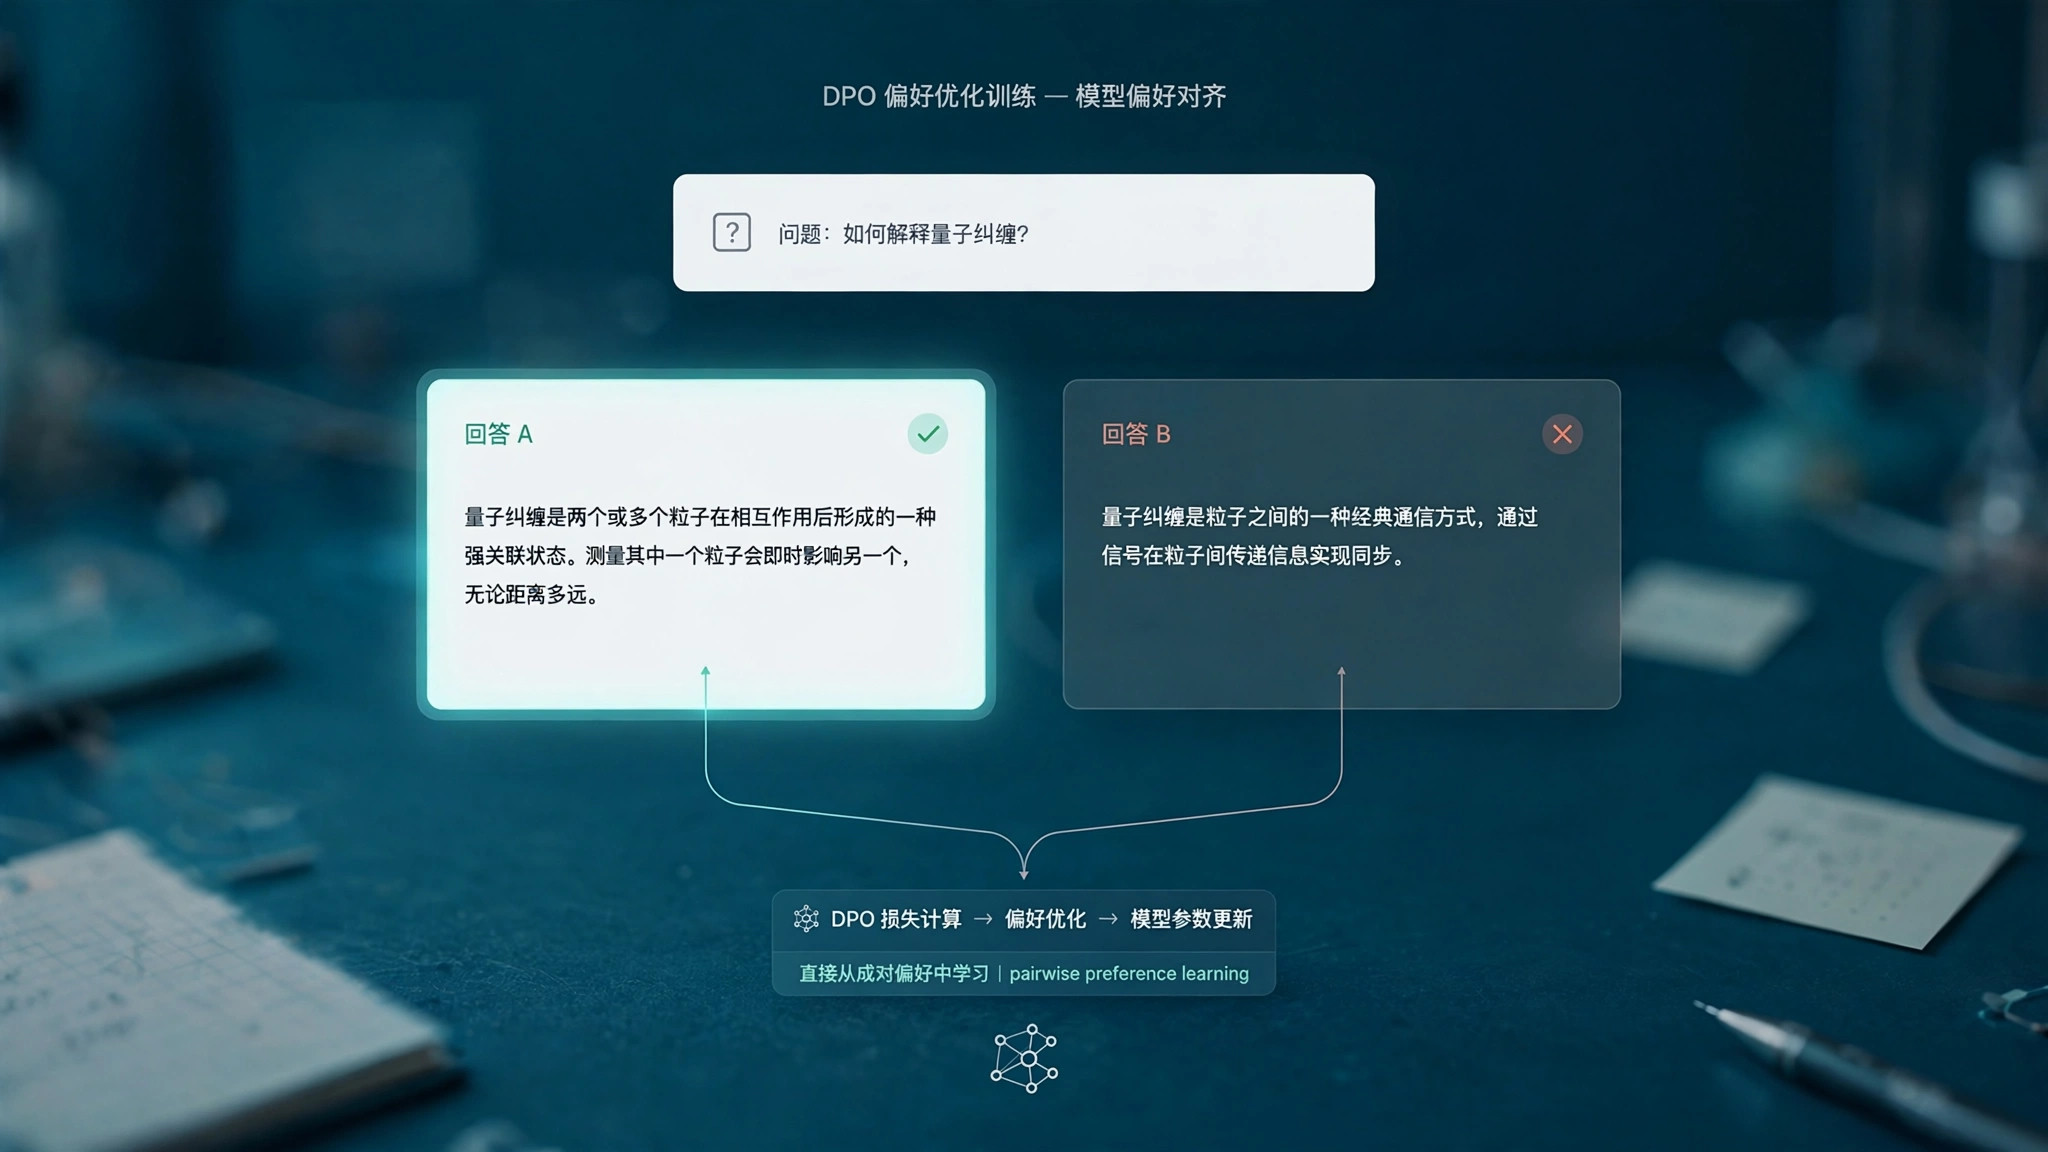
DPO是什么?跳过奖励模型,大模型对齐训练为何更简单
AI百科 AI导航 21 次阅读
GLM-Legal法律模型发布:Harvey LAB通过率升至19.2%
AI资讯 AI导航 30 次阅读
RLHF 是什么?大模型靠人类反馈学会听话守规矩的训练方法
AI百科 AI导航 21 次阅读
通义千问QwenGyre公布:弹性调度GPU,长程智能体训练提速1.85倍
AI资讯 AI导航 24 次阅读
Prime Agent 用 Rust 重写完成:2000 多个智能体两周重写了自己
AI资讯 AI导航 23 次阅读
InnovationEval 结果出炉:前沿模型只拿到人类创新增益的 15%
AI资讯 AI导航 27 次阅读
Mellum2.1 开源发布:架构没变,JetBrains 靠强化学习练出仓库级编程能力
AI资讯 AI导航 30 次阅读
Agent Lightning v1.0 开源:不改智能体代码也能做强化学习训练
AI资讯 AI导航 33 次阅读