Kimi K3.1 Pro 是月之暗面 10 月 23 日在官方博客发布的 K3.1 系列首个模型,也是它迄今最强的 3T 参数量级开放权重旗舰,上下文窗口达到 100 万 token。普通人用它最划算的方式就一句话:别再分十次喂资料,一次把整份长文档、整个项目背景丢进去,让它在完整的上下文里干活。下面 4 类场景是百万上下文真正拉开差距的地方,入口和注意事项先一次讲清。
先看你能在哪用上它
K3.1 Pro 发布当天就在全产品线可用:kimi.com 网页版、Kimi 移动 App(iOS、Android、鸿蒙)、Kimi Work 桌面端 3.1.0 及以上版本、Kimi Code(用 /model 命令切换),以及 Kimi API(模型名 kimi-k3.1-pro,API 客户可选零数据留存)。另外同步上线了 Highspeed 版,交互速度是标准版的 2 到 3 倍,适合需要来回多轮追问的场景;不赶时间的话标准版完全够用。
还有一个值得本地部署党记下的时间点:完整模型权重将在 2026 年 11 月 4 日前公开。官方说明里提了一句安全处理——训练中识别并移除了网络安全相关数据,开源权重不会把漏洞挖掘能力推到最前沿。所以等开源版的人要先想清楚:你要的是长上下文和通用能力,开源版没问题;要的是安全研究方向的能力,它会有意被削弱。
场景一:整份资料一次丢进去,别再分段喂
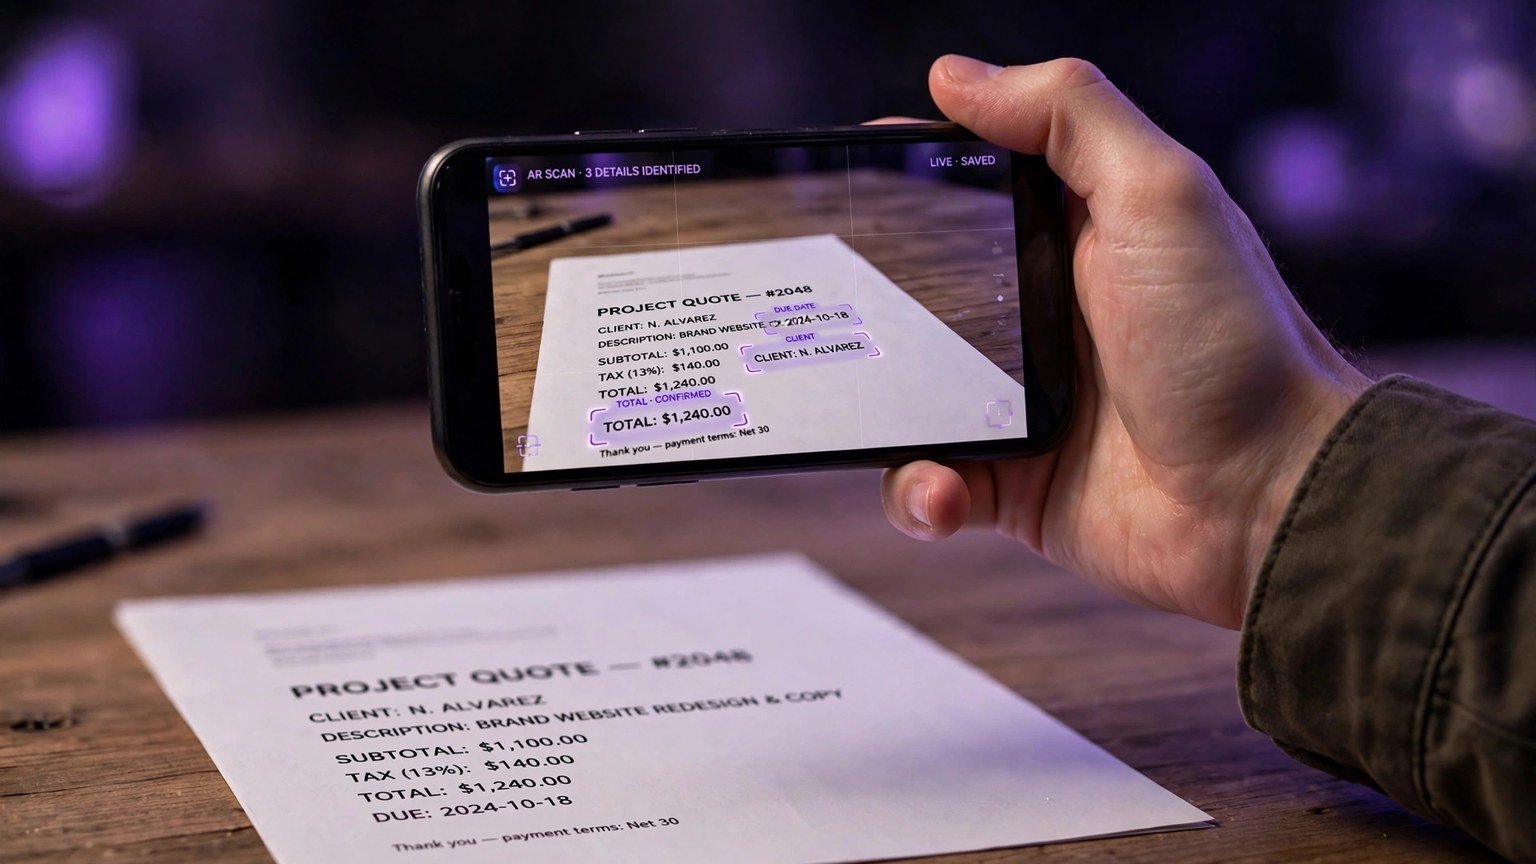
100 万 token 意味着几十万字的资料可以一次装进上下文。长报告、论文、合同、会议纪要合集,以前要拆成十几段分别问、还得自己拼答案,现在可以直接传完整文件。
实操上有个细节:资料丢进去之后,第一句先让它按你的结构输出,比如"先列这份报告的 5 个核心结论,每个结论标注出自第几页",而不是直接问开放式问题。上下文大不等于它会自动抓重点,你给的输出框架越具体,它越不容易在几十万字里"平均用力"。
场景二:代码类的长任务,适合多文件重构
K3.1 Pro 是 Kimi K3 的后训练版本,官方称投入了大得多的后训练算力,并对 RL 框架、长上下文推理和沙箱基础设施做了全栈优化。数字上,Terminal-Bench 4.0 拿到 65.7%,超过 GPT-6 Astra 的 58.2%,只比 Claude Opus 5.5 的 66.4% 低一档;内部的 Kimi Code Bench 3.0 长时程任务 61.2%,高于 K3 的 55.95%。
翻译成大白话:它现在更适合"跨很多文件、要记很久"的编码任务,比如给一个老项目统一改接口、按新规范重构某个模块。在 Kimi Code 里用 /model 切到 K3.1 Pro,把相关文件和需求一次说清,比来回补上下文效率高得多。但要注意,它仍然可能编造不存在的函数,跑起来和查文档这两步不能省。
场景三:3D 创作,从一句话到可打印模型
这是这次发布最出圈的卖点。在 BenchCAD 测试里,K3.1 Pro 带工具拿到 92.7%,接近 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%,能从一句话描述、草图或参考图推导出可用 3D 模型。
普通人能直接玩的是同步上线的 3D Make 功能:在 kimi.com 和 Kimi App 里就能在线预览、编辑生成的模型,还能下载去 3D 打印或导出成视频分享。想试的话建议从"参考图 + 修改要求"开始,比如给一张椅子照片说"改成北欧风、保留扶手结构",比纯文字描述一次成型的概率高。
场景四:金融研究这类"怕幻觉"的活
官方给了两个硬数字:OfficeQA Pro v2 拿到 64.4 分,称是当前最优;内部幻觉测试里,事实性错误率从 K3 的 23.4% 降到 8.3%。财报分析、研报梳理、数据核对这类对事实准确度敏感的任务,是 K3.1 Pro 相对 K3 提升最明显的地方。
但 8.3% 不是 0。关键数字、引用来源仍然要交叉核验,一个实用的习惯是让它"每个结论后面标注依据出自原文哪一段",方便你快速抽查,而不是通篇重读。
别指望它替你做的 2 件事
第一,别指望超长上下文等于"过目不忘"。实测中越靠中间的内容越容易被弱化,重要的指令和约束条件建议放在开头,结尾再重复一遍关键要求。
第二,别把涉密资料无脑丢进网页版。API 客户可选零数据留存,但网页和 App 端走的是官方的数据政策,涉密或受合规约束的资料先看清官方说明再传。模型能力再强,数据边界这件事永远是你自己的责任。