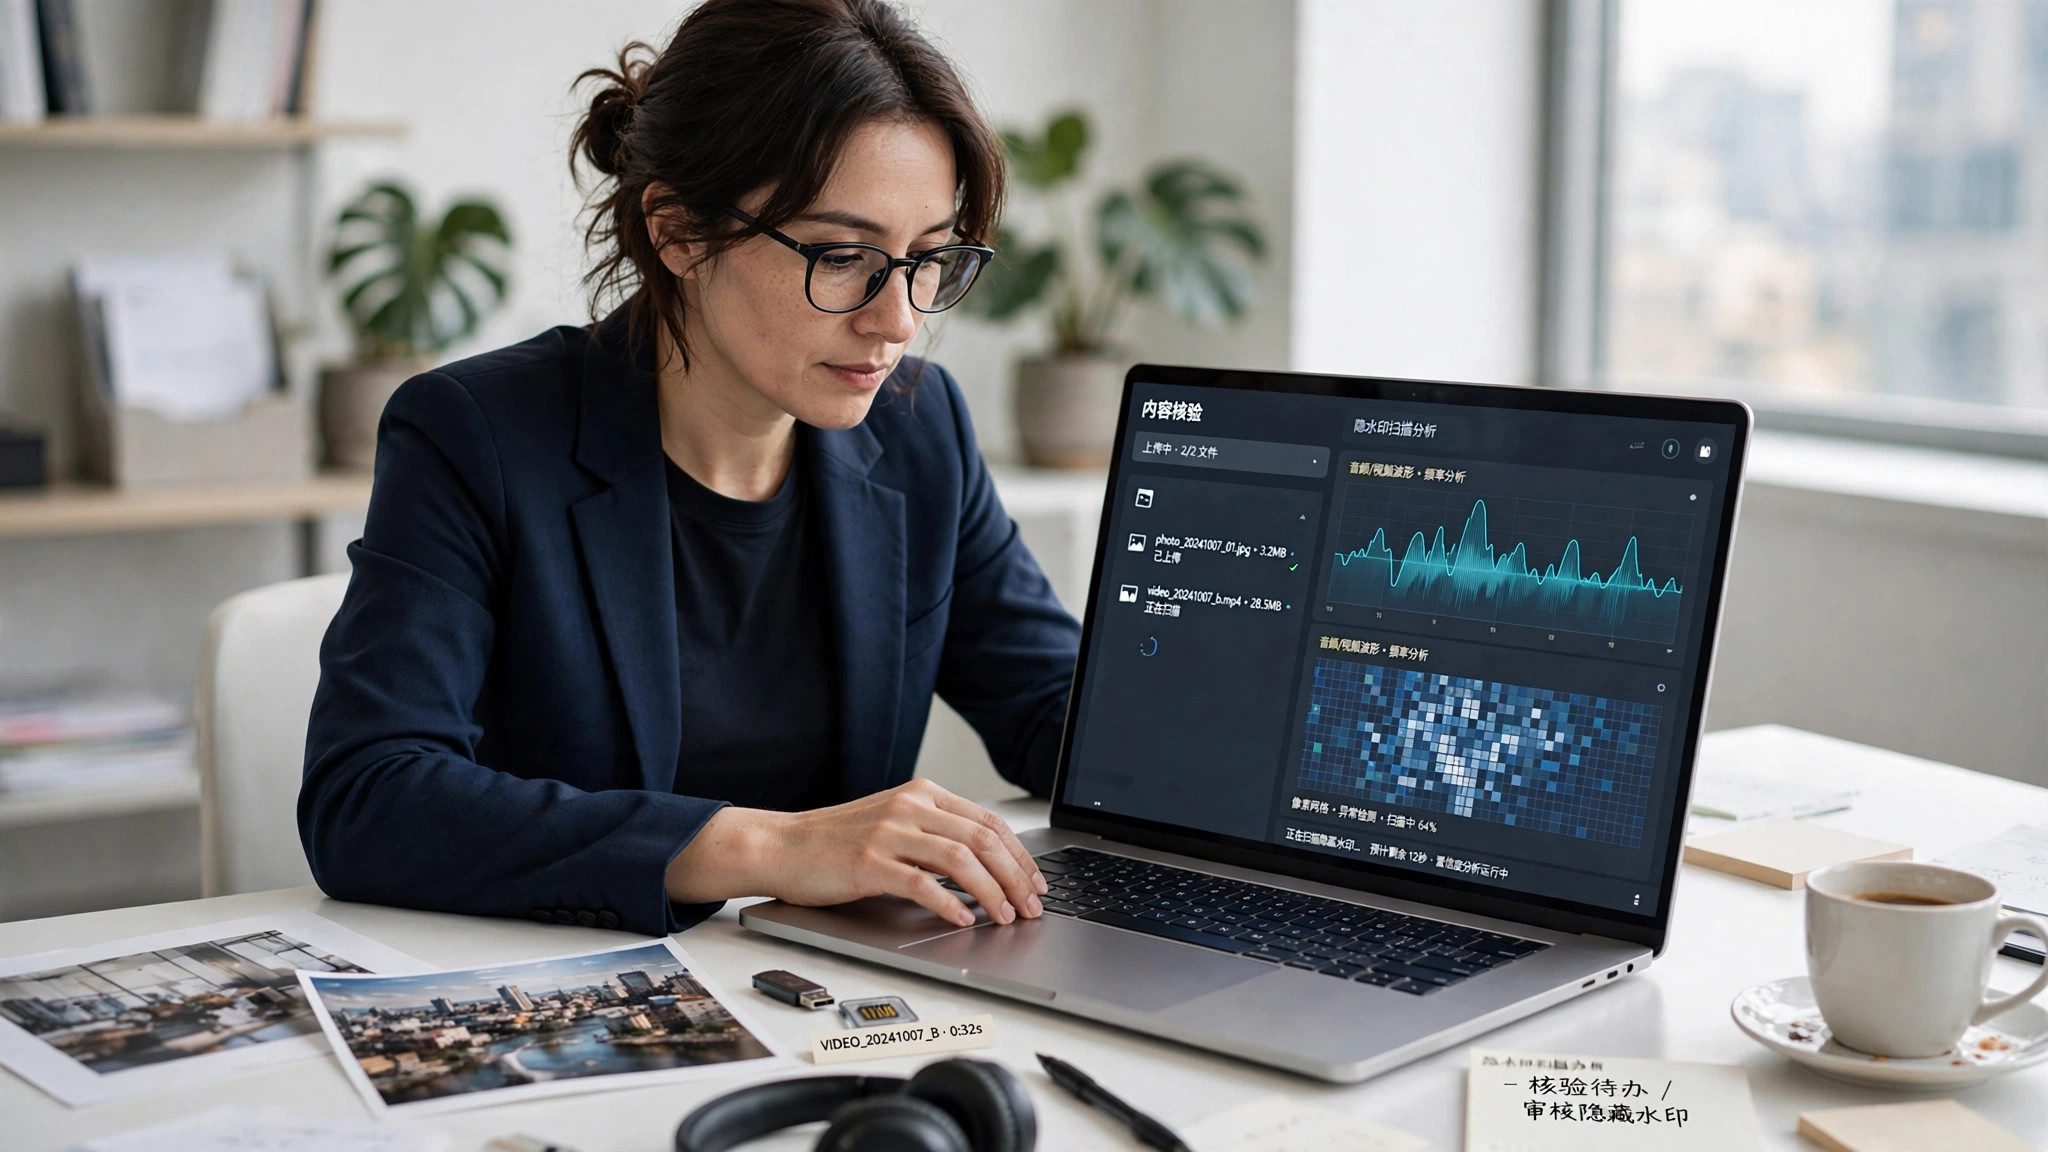
Nemotron 在 2026 年 10 月 7 日由 NVIDIA 团队通过 Hugging Face 博客正式汇总了两项奥赛成绩:同一模型家族经过微调后,在国际信息学奥林匹克(IOI)2026 和国际数学奥林匹克(IMO)2026 都达到了金牌水平。这不是换了个新基础模型刷榜,团队想证明的是另一件事:一个足够强的通用模型,配上针对性的后训练和推理流程,可以被改造成不同领域的顶尖专家。两项成绩的细节如下。
| 赛事 | 系统构成 | 成绩 | 对照线 |
|---|---|---|---|
| IOI 2026 | Nemotron-3-Ultra-CC 微调加 GenCorrect 推理策略 | 535.4 / 600 | 金牌线 361.12,人类最高分 498.27 |
| IMO 2026 | 通用、SFT、RL 三个检查点组成生成—核验—修正系统 | 30 / 42 | 官方金牌线 29 |
两块金牌的含金量要分开看
IOI 这次是在与人类选手相同的时间、联网和提交限制下做的一次实时前瞻测试,535.4 分不仅越过金牌线,还高于人类最高分;但团队也明确说明,这是一次非官方、无监督的基准运行,不计入 IOI 官方排名。IMO 的流程则更接近正式参赛:系统为每道题生成候选证明、打分、提出批评再修正,最后由高算力阶段挑选提交稿,全程只用自然语言,不用形式化证明工具、不联网、不调用外部工具,六道题里四道拿到满分,30 分的成绩由 IMO 官方阅卷人评出。读这类消息时,把这两条边界分清,才不会把宣传口径当成赛事纪录。
配方里真正起作用的不是堆采样
团队把方法拆成四步:选一个强基础模型,准备领域问题和高质量推理轨迹,用监督微调和强化学习做后训练,再配上能生成、评估、改进答案的推理循环。以小一号的 Nano 模型为例,它在 IOI 2025 题目上从微调前的 130 分涨到微调后 280 分,强化学习再推到 291 分,叠加 GenCorrect 的多轮反馈修正后达到 468 分、越过当年金牌线。IMO 系统里,SFT 检查点首轮最强、RL 检查点单模型最好,两者与通用模型组合使用,效果好过只对单个模型反复采样。结论很朴素:金牌来自模型、数据和推理流程的共同设计,不是某一招的功劳。
哪些东西已经开源出来
这次汇总同时把可复用的材料摆上了 Hugging Face:IMO 方向公开了 SFT 与 RL 两个检查点、两份训练数据和一个包含 200 道新题的 Nemotron-IMO-Bench,推理流水线、提示词和实际提交的证明放在 NeMo-Skills 仓库里;IOI 方向的 Ultra-CC 模型和 GenCorrect 方法说明也可以直接取用。对想做领域微调的团队来说,这套从数据、训练到推理的完整配方,比金牌本身更值得花时间研究。