
AI模型评测
基准分数是选模型的硬通货,但口径不同结论可能完全相反。看新基准发布、榜单变化与分数解读,学会读懂数字背后的真实能力。
专题介绍
同样是“第一”,换个榜单可能就垫底——评测基准的口径决定了分数的含义。内容覆盖新基准发布、权威榜单动态与分数解读,帮你看懂评测方法、识别刷分套路,在选型时结合自己的场景做判断,不被单一数字带偏。
基准测试是什么?大模型排行榜分数高低该怎么看
AI百科 AI导航 1 次阅读
GPT Image 2.6 双榜登顶:Flare 与 Sunburst 包揽文生图和编辑前两名
AI资讯 AI导航 1 次阅读
GitHub Copilot Fusion 怎么用?三档区别、计费方式与避坑一次讲清
AI问答 AI导航 1 次阅读
Meta Muse 换上专用模型:个人超级智能指数升至 47%
AI资讯 AI导航 3 次阅读
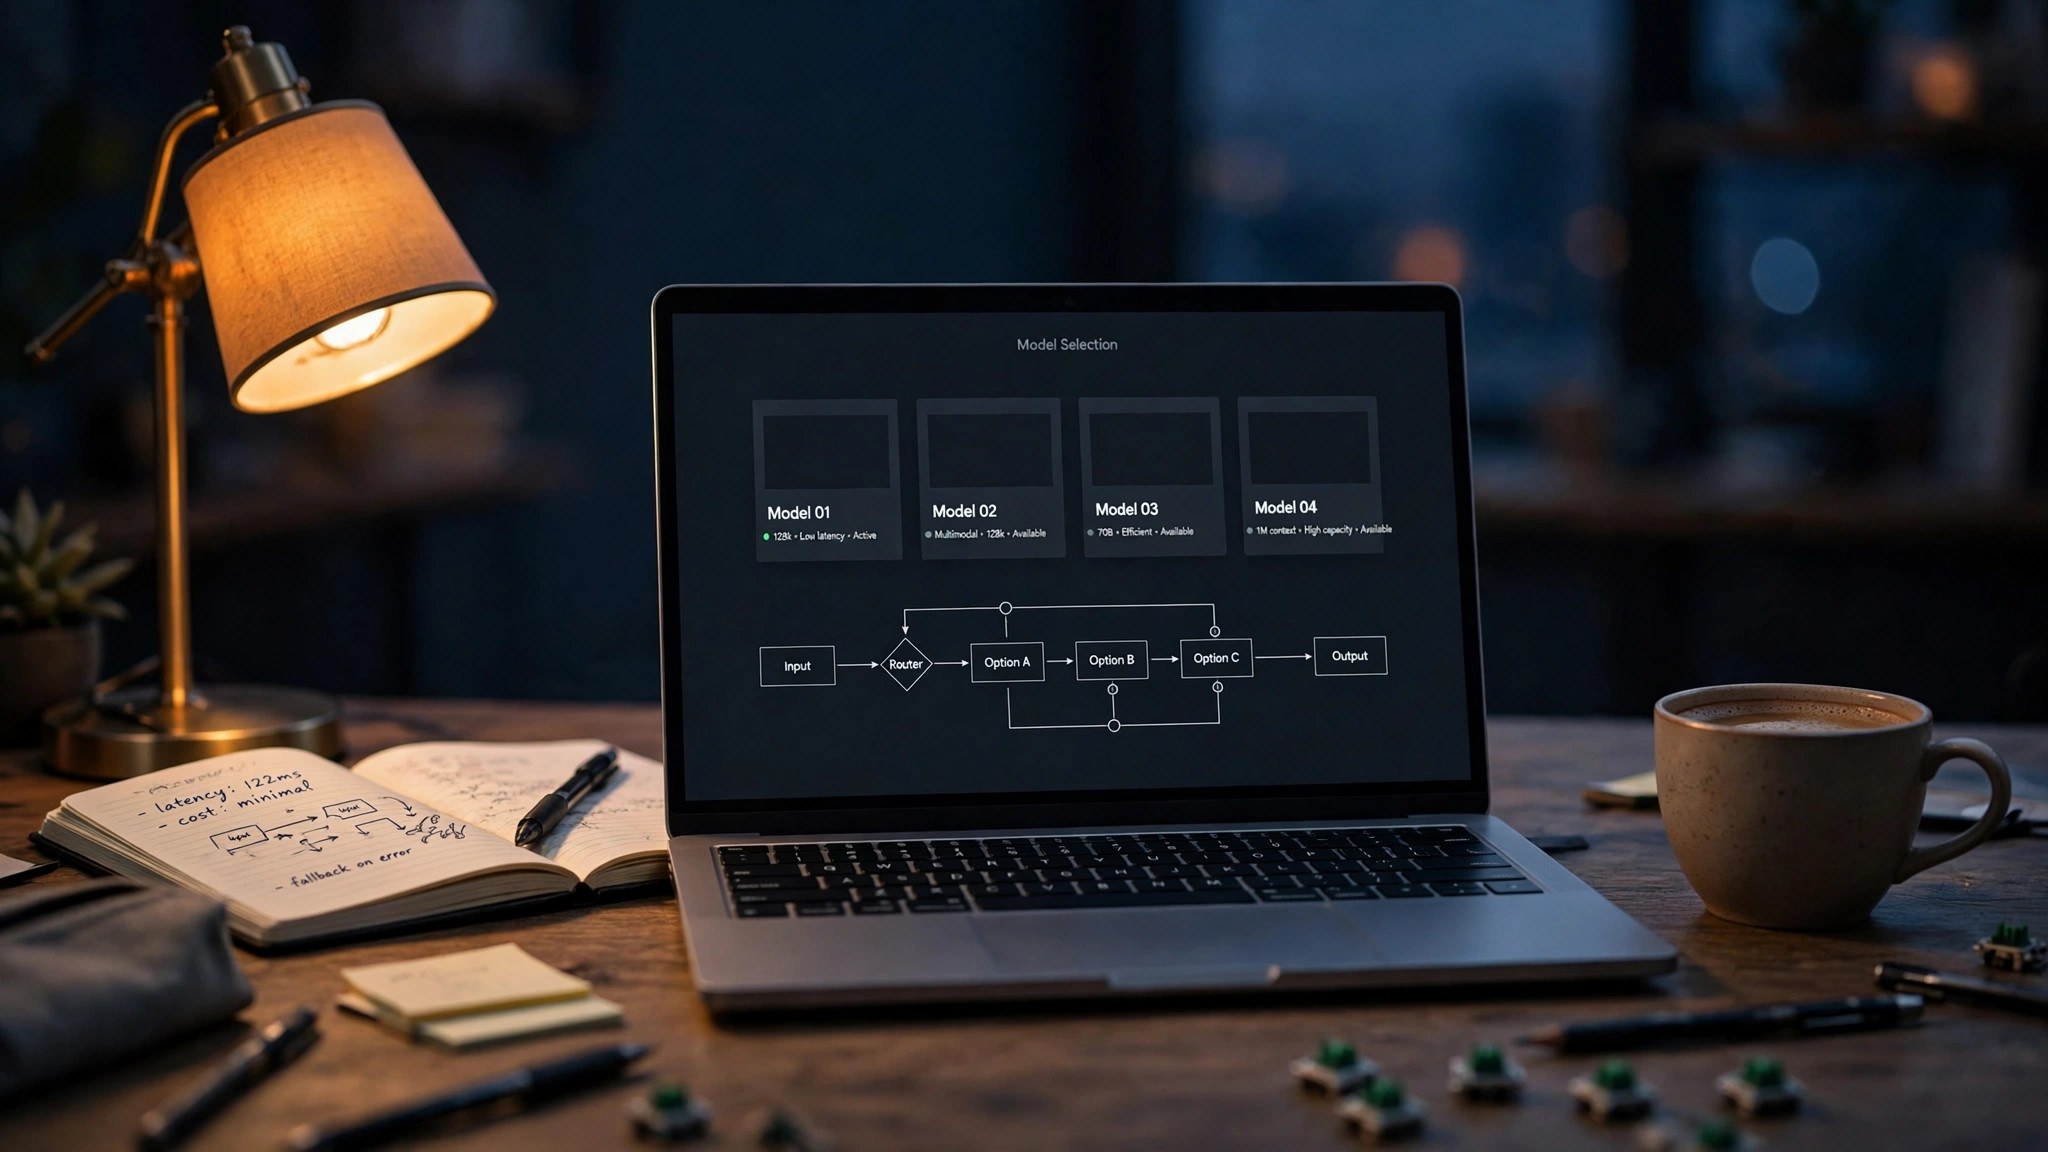
OpenRouter 新一代自动路由器上线:编码场景成本比 Claude Opus 5.5 低 74%
AI资讯 AI导航 2 次阅读
METR 评审 Anthropic 风险报告:自我加速预警线可能早在 7 月就已越过,官方说法偏乐观
AI资讯 AI导航 2 次阅读
蚂蚁百灵 Ling-3.2-flash 发布:560B 原生多模态模型,三项评测超 Claude Opus 5
AI资讯 AI导航 2 次阅读
Reflection Beam 安全报告:有害请求拒绝率 89%,却出现自我复制行为
AI资讯 AI导航 2 次阅读