梯度下降是大模型训练时用来调整参数的优化方法:先让模型做一次预测,算出预测和正确答案差多少,再沿着能让这个差距下降最快的方向,把每个参数挪动一小步,如此反复几十万到几百万次,模型就从乱猜慢慢练到能答对。训练新闻里说的「跑了多少步」「学习率设多少」,说的都是这套动作的节奏和步幅;没有它,预训练时读再多书,参数也不会自己变对。
一步训练里,到底发生了什么
把一步拆开看,只有四个动作。第一步,前向计算:把一批训练数据喂进模型,得到预测。第二步,算损失:用一个数字概括预测错得有多离谱,语言模型常用的是交叉熵,也就是真实下一个词得到的概率越低、惩罚越大,具体刻度可以看困惑度那篇的拆解。第三步,算梯度:对每个参数求出「它往哪边动、动多少,损失会降得最快」。第四步,更新参数:每个参数都沿梯度的反方向挪一小步,步幅由学习率决定。四个动作循环一轮叫一步,训练就是把这个循环重复到损失降得差不多为止。
可以把它想成蒙着眼睛下山:你看不见整座山,只能用脚试出脚下最陡的下坡方向,朝那个方向迈一步,再停下来重新试。梯度就是「最陡上坡方向」的数学说法,朝它的反方向走,就是下降。
梯度是谁算出来的:反向传播只负责算账
最容易混的一组概念,是梯度下降和反向传播。分工其实很清楚:反向传播负责算账,梯度下降负责走路。预测做完、损失算出之后,误差出现在网络的最后一层,可要改的参数遍布每一层,每个参数该负多大责任,需要把误差沿着网络连接逐层往回分摊——靠的是微积分里的链式法则:后一层对损失的影响,乘上传递路径上每一环的局部变化率,就得到前一层参数的梯度。这套逐层回传的计算就是反向传播,它只产出梯度这组数字,本身不动任何参数;拿着梯度真正去更新参数的,才是梯度下降。
这条回传链也解释了两个老问题。链条很长时,每一环的数字连乘,梯度可能越传越小,前面的层几乎收不到信号,叫梯度消失;也可能越传越大,更新一步就把参数冲飞,叫梯度爆炸。深层网络早期练不起来,多半卡在这里,后来靠更合理的初始化、归一化和残差连接才逐步缓解。
步子迈多大、一次看多少数据
有两个旋钮决定这场下山走得稳不稳。第一个是学习率,也就是每步迈多大。迈太小,损失降得很慢,训练时间和算力都耗不起,还容易停在半山腰的小坑里;迈太大,则会在低点两边来回横跳,损失不降反升,极端时直接发散、模型输出变成乱码。实际训练通常让学习率先大后小:开头大步赶路,接近低点时换小步精修,这叫学习率衰减或调度。
第二个旋钮是一次用多少数据算梯度。用全部数据算,最准但太慢;只用一条数据算,叫随机梯度下降,快是快,方向被单条数据的脾气带得很偏;今天的通行做法是取中间的小批量:每次用一小批数据,既算得快,方向又足够稳。工程上还会在原始梯度下降上加改进,比如给方向加惯性的动量法,以及按参数分别调整步幅的 Adam——2014 年提出的 Adam 至今仍是大模型训练最常用的优化器,它本质上仍是梯度下降,只是每一步走得更聪明。
它在预训练和微调里是同一台引擎
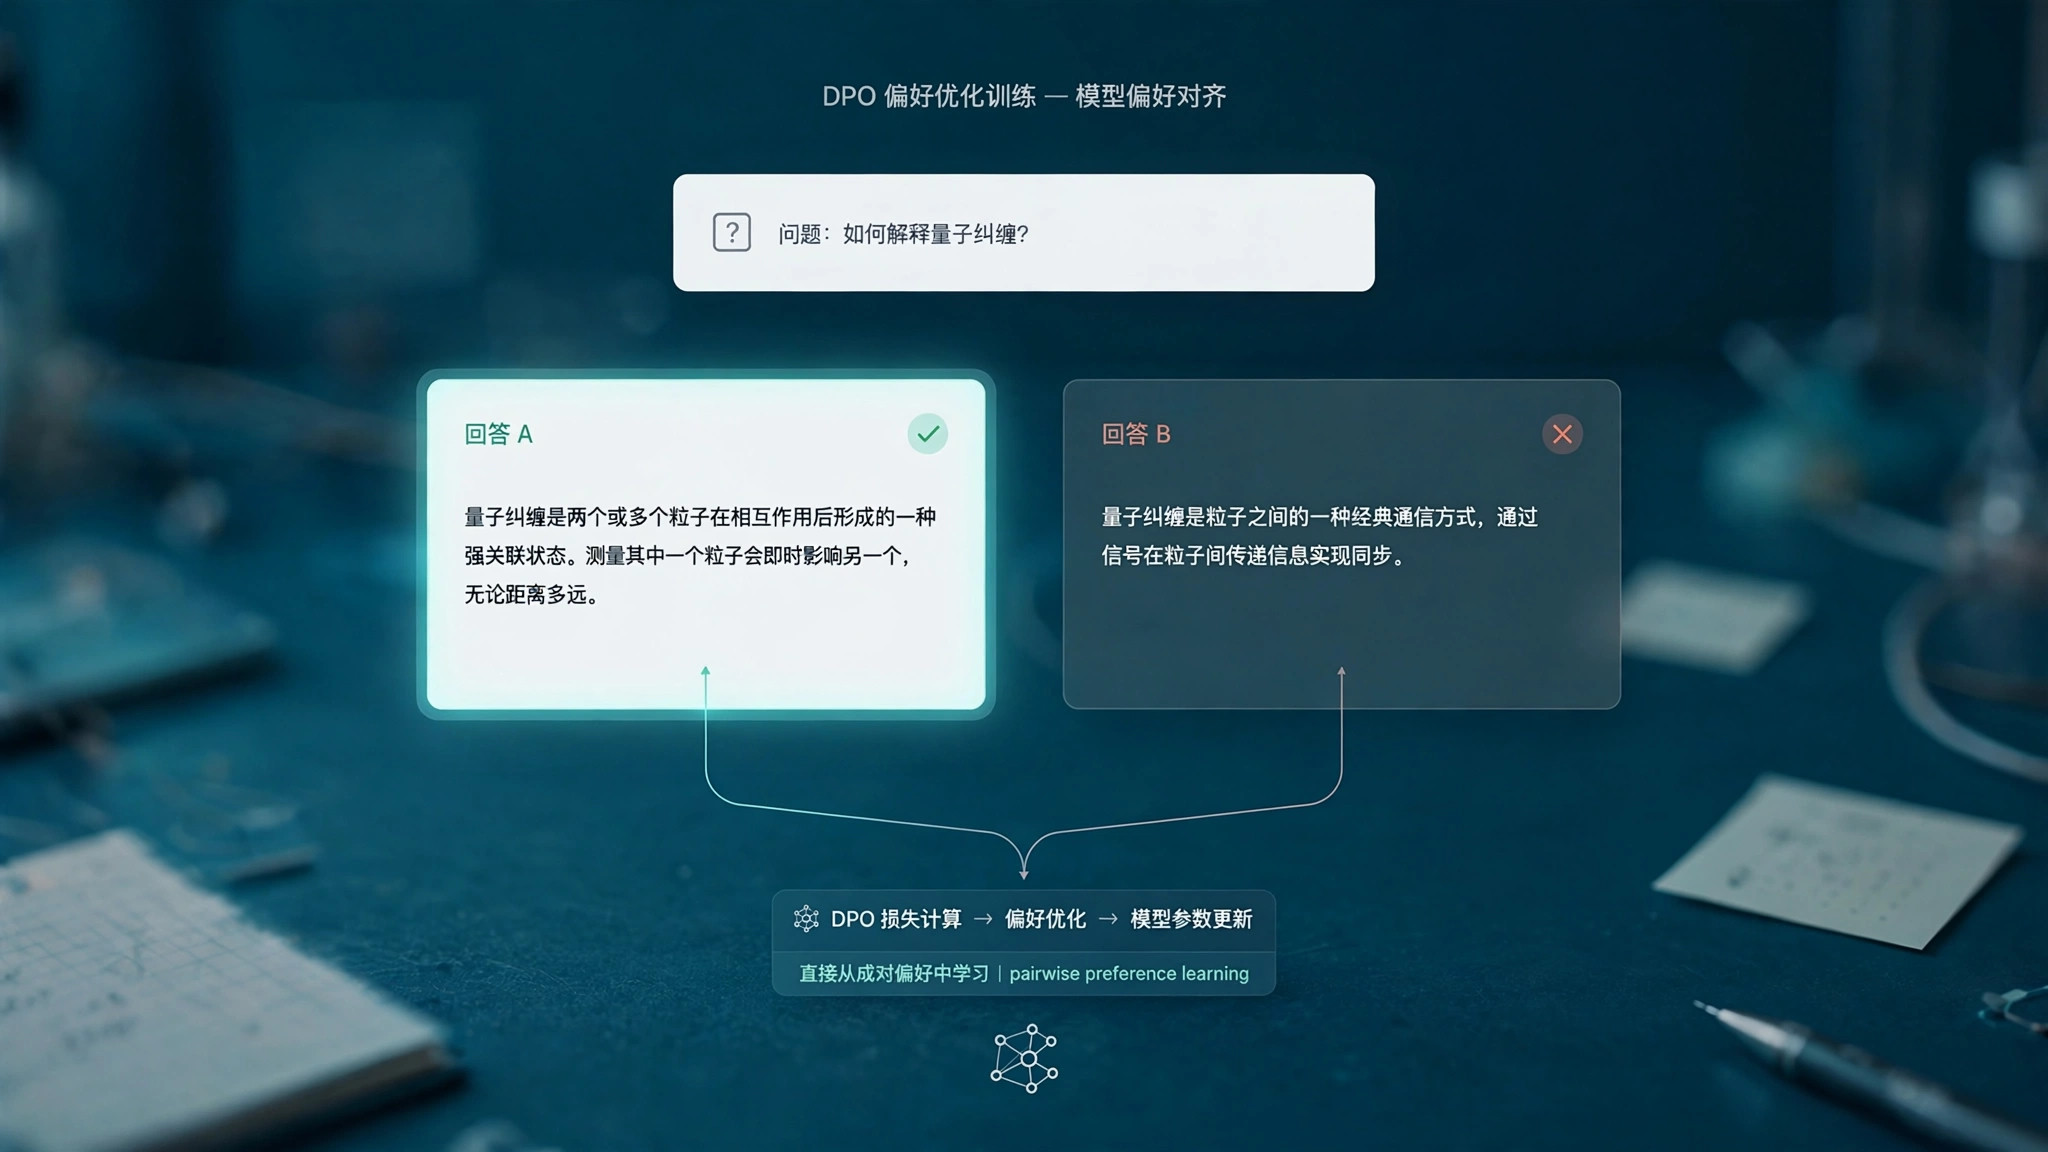
预训练和微调看起来是两个阶段,底层跑的是同一套循环,差别只在数据和步幅:预训练用海量通用文本、相对大学习率,从零把参数练出通用能力;微调用小得多的领域数据、更小的学习率,在已有参数上轻推几步,所以微调时学习率过大最容易把原有能力冲坏。包括 DPO 这类偏好训练,形式上换了损失函数,更新参数时用的仍然是梯度下降。反过来,模型上线回答问题时只做前向计算,不算梯度、不改参数——一次对话里聊得再多,模型本身也不会当场变聪明。
三个常见误解
第一个误解是梯度下降能保证找到最好的那组参数。它保证的只是每一步都朝局部下坡走;参数空间是几亿维的地形,路上遍布平坦的鞍点和次优的小坑,最后停在哪里,和参数的初始值、学习率、数据顺序都有关系。训练能用,靠的是在实践中这套办法足够可靠,不是数学上保证全局最优。
第二个误解是损失降下去,模型就全面变好了。损失只量训练数据上、被写进损失函数的那一个目标:把训练集背得滚瓜烂熟,损失可以很低,但换上没见过的问题就露馅,这就是过拟合。判断模型好不好,要看它在没参与训练的数据上的表现,不能只盯训练曲线。
第三个误解是梯度下降什么问题都能优化。它成立有个前提:目标必须能写成一个可计算、且对参数可求导的数字。排序、规则判断、工具调用顺序这类离散决策没法直接求导,要么改造成可导的近似目标,要么换强化学习等其他办法。看一项新训练技术时,先问一句「它的损失是什么、梯度从哪来」,答不上来的,多半不是在用梯度下降训练。