预训练是大模型训练的第一阶段:先让模型在海量、没有人工标注的文本、代码等数据上,反复练习预测下一个词,从中自己学出语言规律、世界知识和初步的推理方式。走完这一步的模型通常还不会好好聊天,它更像一位读过极多书、却没接受过岗前培训的通才;之后再经过微调和对齐,它才会变成能听懂指令、语气得体的助手。看懂预训练,就看懂了大模型的能力从哪来,也看懂了它为什么带着一些与生俱来的短板。
预测下一个词,为什么能学出这么多东西
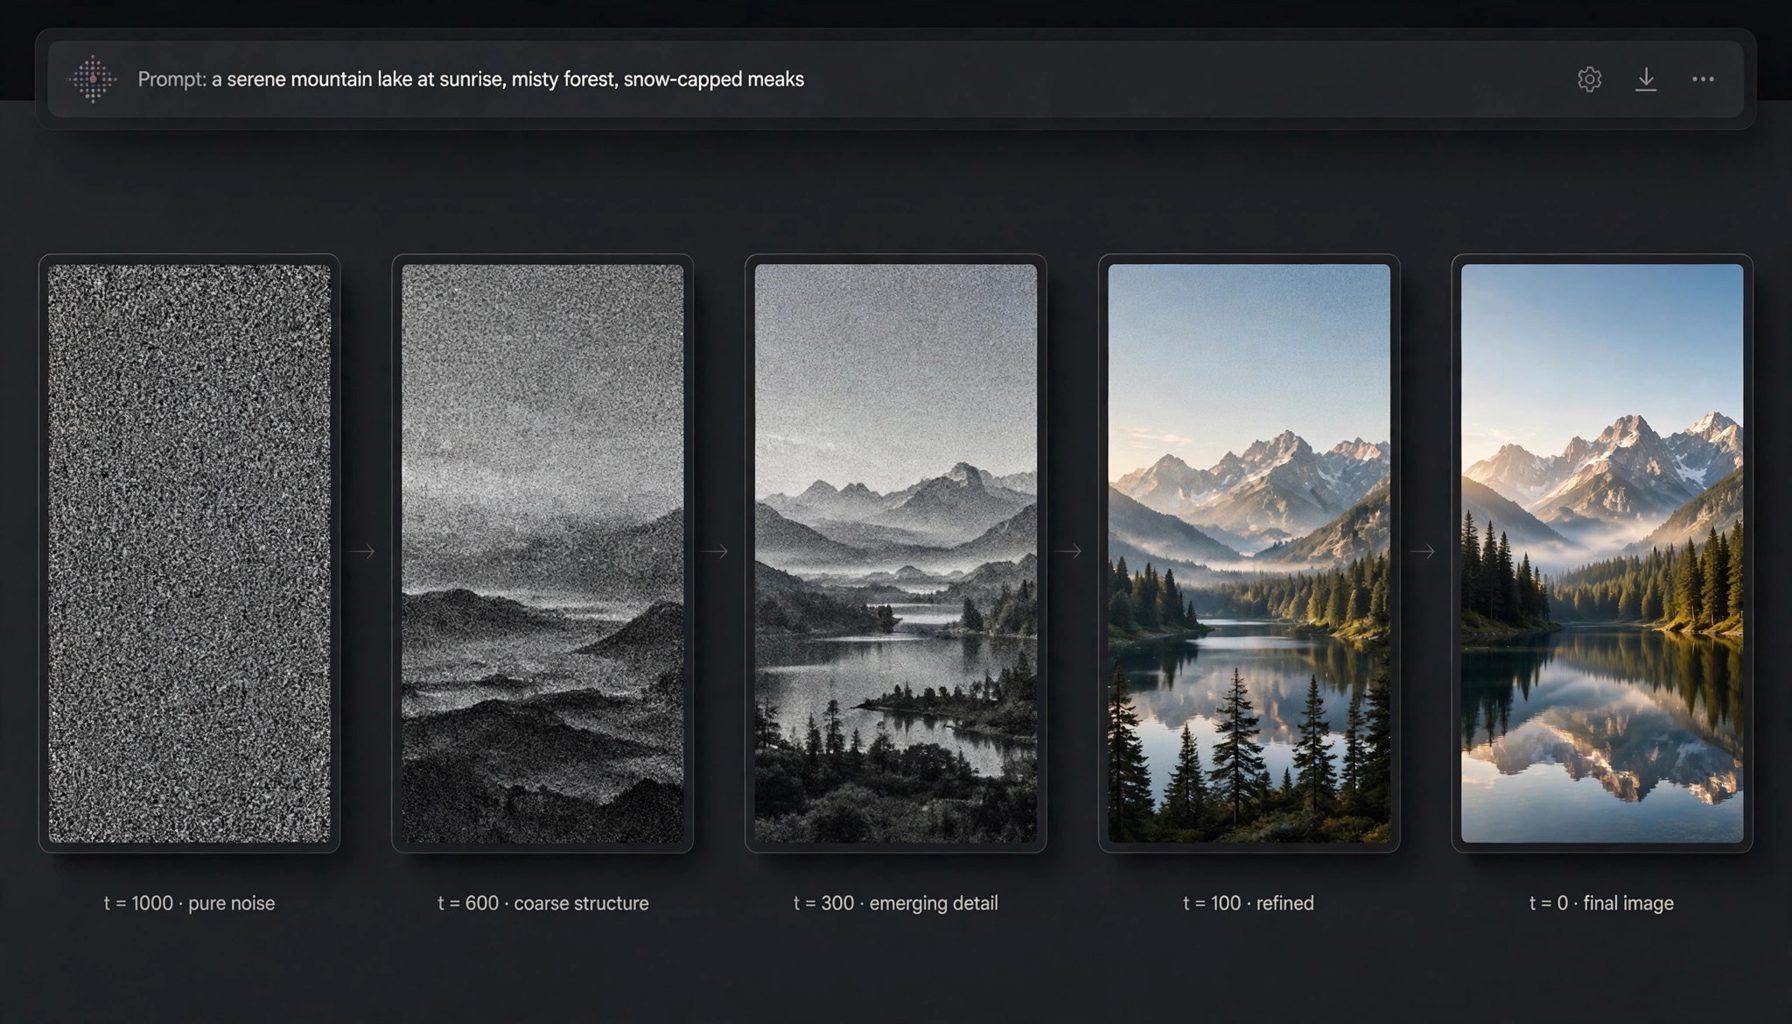
预训练用的办法叫自监督学习:不需要人给每条数据贴标签,文本本身就自带答案。把一句话遮住后半段,让模型猜下一个词最可能是什么;猜错了,就根据误差把内部参数往正确方向调一点。一句两句看不出效果,但当这个动作在万亿级词元上重复无数次后,模型被迫把很多东西一起学会。
原因不难想:要把下一个词猜准,光背搭配远远不够。猜对动词需要懂语法,猜对人名和年份需要记住事实,猜对推理题的下一步需要跟住因果链,猜对代码的下一行需要理解程序逻辑。预测只是表面任务,被逼出来的其实是理解。语言模型内部跑的骨架大多是 Transformer 架构,它负责让每个词在预测时能参考足够长的上下文。
另一条早期路线是掩码预测:随机盖住句子中间的几个词,让模型结合左右两边把它们填回去,BERT 是这条路线的代表。它更擅长理解类任务,如分类和检索;今天主流的聊天大模型大多走预测下一个词的路线,因为它天然适合续写和对话生成。两条路线都算预训练,差别在练习方式,不在阶段位置。
喂进去的数据,不是把互联网原样倒进去
预训练语料通常来自公开网页、书籍、论文、百科、代码仓库等渠道,但原始材料不能直接用。工程团队要先做大量清洗:去掉重复和模板垃圾,过滤明显低质、有害或隐私内容,再按比例混合不同来源——代码占比高,模型的逻辑和编程能力往往更好;对话和问答占比高,表达会更接近日常交流。数据配比是各家不公开的核心 know-how 之一。
还有一个常被低估的事实:预训练学到的不只是知识,还有语料里的偏见、错误和过时信息。网上流传广的说法会被学得更牢,冷门但正确的知识反而可能学得浅。这解释了为什么模型对热门问题答得头头是道,对小众事实却容易顺口编造——它的知识分布,从预训练那天起就跟着语料的分布走。
预训练、微调、对齐:一栋楼的三个工期
很多人把训练当成一件事,其实从预训练产出基础模型,到最终能用的助手,中间还隔着两个阶段,三者的目标、数据和成本完全不同:
| 阶段 | 主要目标 | 数据规模与形式 | 产出 |
|---|---|---|---|
| 预训练 | 学语言、知识与通用能力 | 万亿级通用语料,无需标注 | 基础模型,只会续写 |
| 微调 | 学会特定任务、领域或格式 | 万到百万级精选示例 | 指令模型或领域模型 |
| 对齐 | 让回答符合人类偏好与安全要求 | 偏好对比与反馈数据 | 语气得体、守规矩的助手 |
成本差距是数量级的:预训练动辄需要数千张加速卡跑数周到数月,是整个流程里最烧钱的一步;微调通常只是它的零头。关于微调具体在调什么,可以接着看微调到底在调什么那篇。顺序也不能颠倒:没有预训练打下的通用底子,微调时那点数据根本教不会模型说话;没有对齐,只会续写的模型则可能把用户的半句话当成要接着编的故事,而不是要回答的问题。
三个流传很广的误解
第一个误解是预训练完成就等于能直接聊天。不能。此时的模型只学会了续写:你给它一个问题,它可能接着编出更多问题,或者模仿网页语气写下去,因为它从没被教过什么叫一问一答。聊天感是后面微调和对齐教出来的。
第二个误解是模型把读过的文章都背了下来。它学到的是统计规律,不是原文存档。大多数内容它只留下一个模糊的印象,既说不清出处,也可能把几个相似事实拼错;要求它逐字复述某本书、给出准确引用时最容易露馅。
第三个误解是数据越多、越新,预训练就越好。规模确实重要,但低质数据灌得越多,模型学到的噪声也越多;而且再新的语料也只截止到训练启动之前。预训练解决的是底子问题,不是时效问题。
这些边界,决定了使用时该注意什么
第一条边界是知识截止。预训练结束的那一刻,模型的知识就被冻住了,之后发生的事它一概不知,只能靠联网搜索或 RAG 这类外挂知识库补上。问它最新政策、近期价格时答错,多半不是模型变笨,而是你问到了它没读过的内容。
第二条边界是门槛。从头预训练一个像样的基础模型,只有少数机构承担得起;绝大多数团队和个人,实际是在别人训好的基础模型之上做微调、接知识库、编排智能体。选模型时先看它的预训练底子——数据质量、上下文长度、擅长的语言和领域——比只看发布时的演示效果更靠谱。
第三条边界是底子很难靠后天完全纠正。预训练阶段学进去的偏见和错误模式,对齐只能压制和缓解,很难连根拔掉。把预训练理解成打地基,就能对后面所有阶段有合理的预期:地基决定上限,装修决定好不好住。