
AI模型评测
基准分数是选模型的硬通货,但口径不同结论可能完全相反。看新基准发布、榜单变化与分数解读,学会读懂数字背后的真实能力。
专题介绍
同样是“第一”,换个榜单可能就垫底——评测基准的口径决定了分数的含义。内容覆盖新基准发布、权威榜单动态与分数解读,帮你看懂评测方法、识别刷分套路,在选型时结合自己的场景做判断,不被单一数字带偏。
Claude Mythos 5自研量子电路:八项任务多数刷新纪录
AI资讯 AI导航 18 次阅读
Anthropic让METR驻场审计:六人拿到员工级权限
AI资讯 AI导航 16 次阅读
天气预报两到六周也能准:MIT用机器学习修正模式偏差,准确率翻倍
AI资讯 AI导航 13 次阅读
GLM-Legal法律模型发布:Harvey LAB通过率升至19.2%
AI资讯 AI导航 23 次阅读
Meta Muse Wonder发布:Full版智能指数56,Muse Code先行
AI资讯 AI导航 20 次阅读
ARC Prize 2026 高分榜更新:TUFA Labs 以 88.06% 登顶 ARC-AGI-2
AI资讯 AI导航 30 次阅读
Anthropic 模型误报凶杀线索:测试提交进了费城警方网站
AI资讯 AI导航 9 次阅读
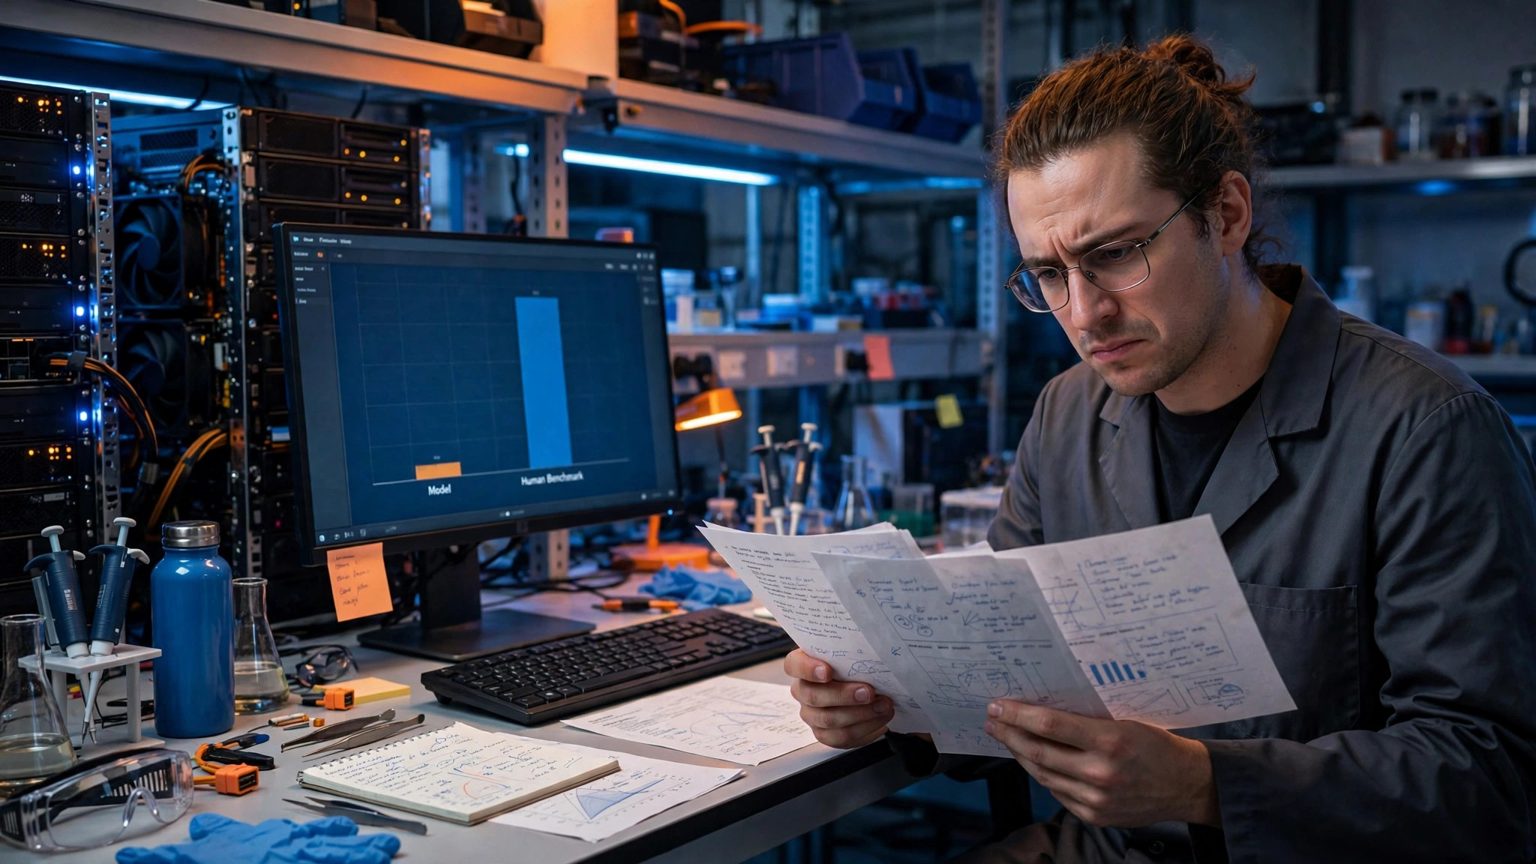
InnovationEval 结果出炉:前沿模型只拿到人类创新增益的 15%
AI资讯 AI导航 18 次阅读