
大模型推理优化
从注意力架构、KV 缓存到量化与推测解码,追踪让大模型推理更快、显存更省的关键技术进展,帮你看懂每次提速背后的原理。
专题介绍
模型越来越大,推理成本成了真正的门槛。这个专题追踪注意力架构、KV 缓存优化、量化、推测解码、推理框架与部署调优等方向的实质进展:每次提速是怎么做到的、省了多少显存、代价是什么。适合关心模型落地成本与响应速度的开发者和产品团队。
Reflection 发布 Beam 开放权重模型:501B 参数只激活 23B,主打推理效率
AI资讯 AI导航 30 次阅读
Together Link 上线:一条命令,编码智能体改用开源模型省一半账单
AI资讯 AI导航 16 次阅读
Baseten 让 Claude 写推理引擎:单流解码比 vLLM 快 90%
AI资讯 AI导航 17 次阅读
Prime Inference 发布:前沿开源模型推理服务上线,首个端点是 GLM-5.3
AI资讯 AI导航 18 次阅读
GPT-6 Astra Ultrafast 上线:Blackwell 加速,token 生成最高快 8 倍
AI资讯 AI导航 20 次阅读
Modal Clusters 正式发布:一条装饰器调动多节点 GPU 集群
AI资讯 AI导航 24 次阅读
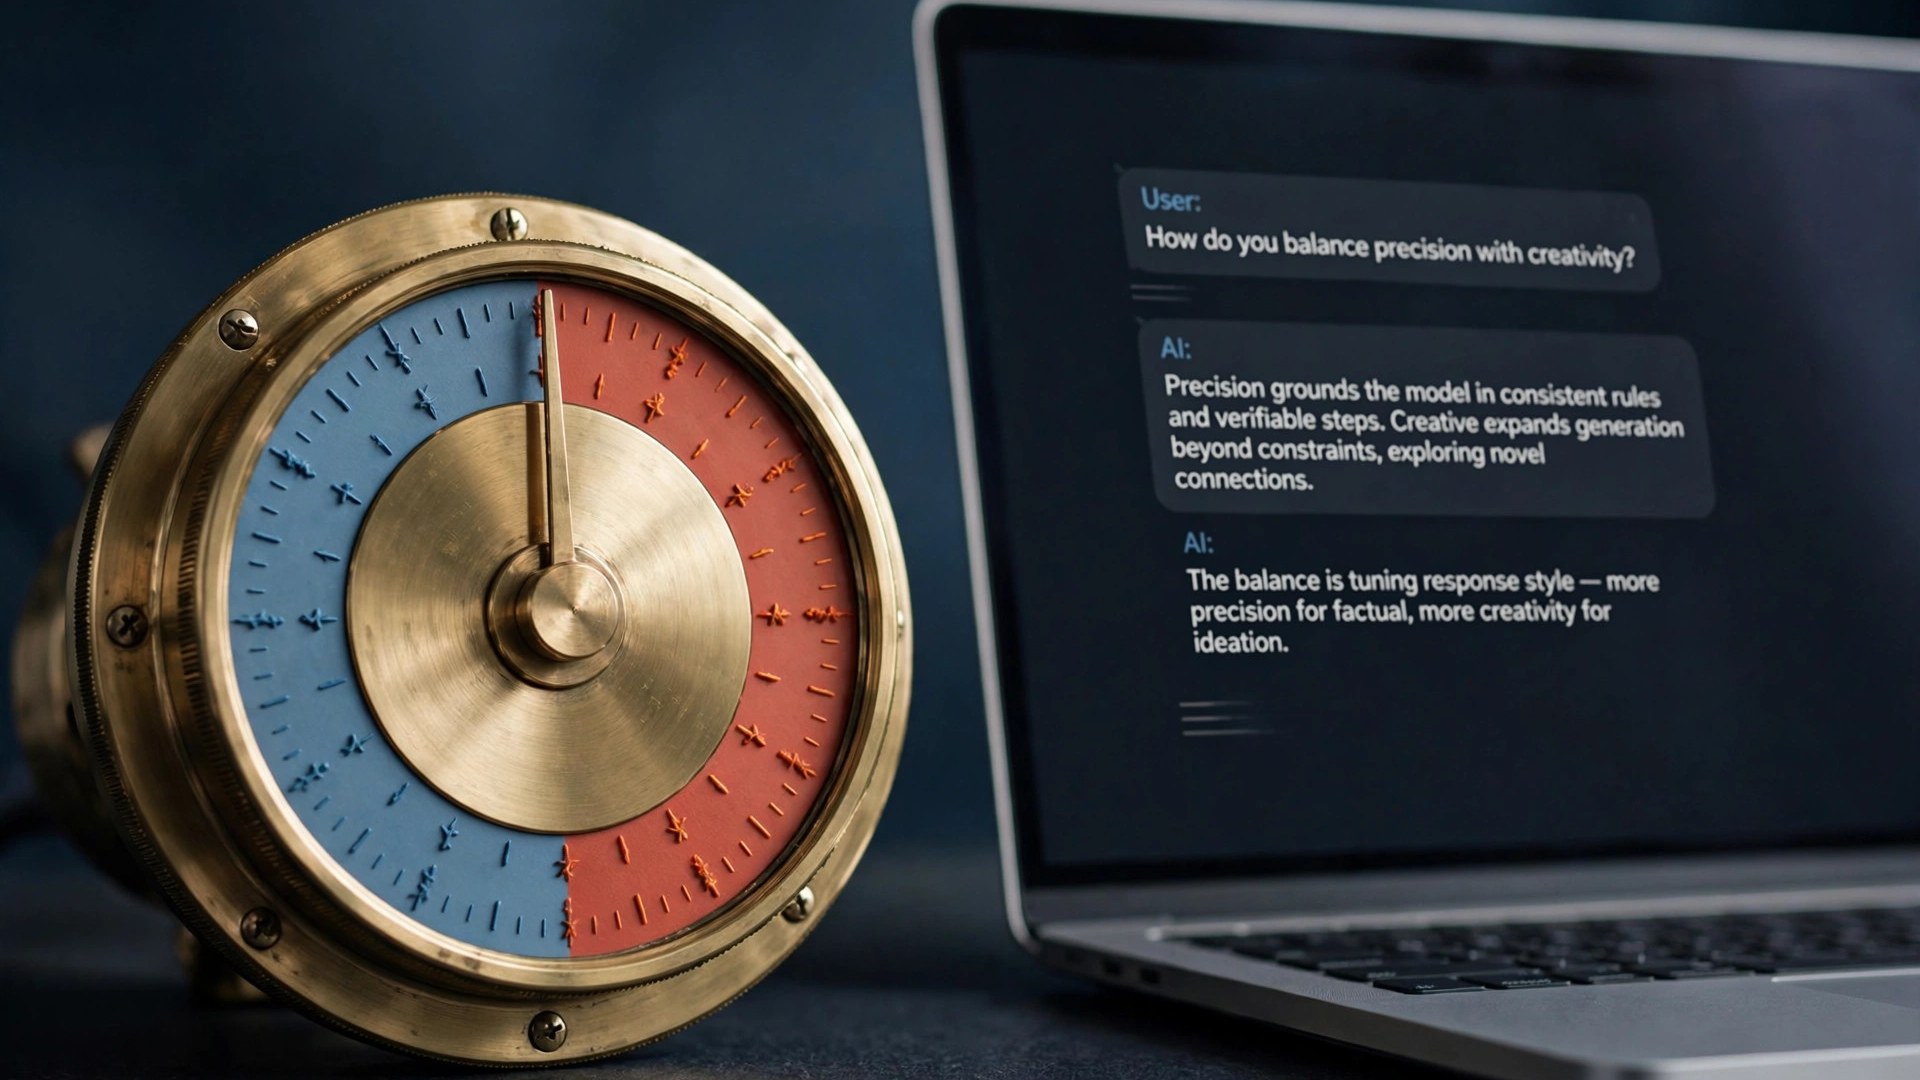
温度参数是什么意思?大模型回答随机性的控制旋钮
AI百科 AI导航 25 次阅读
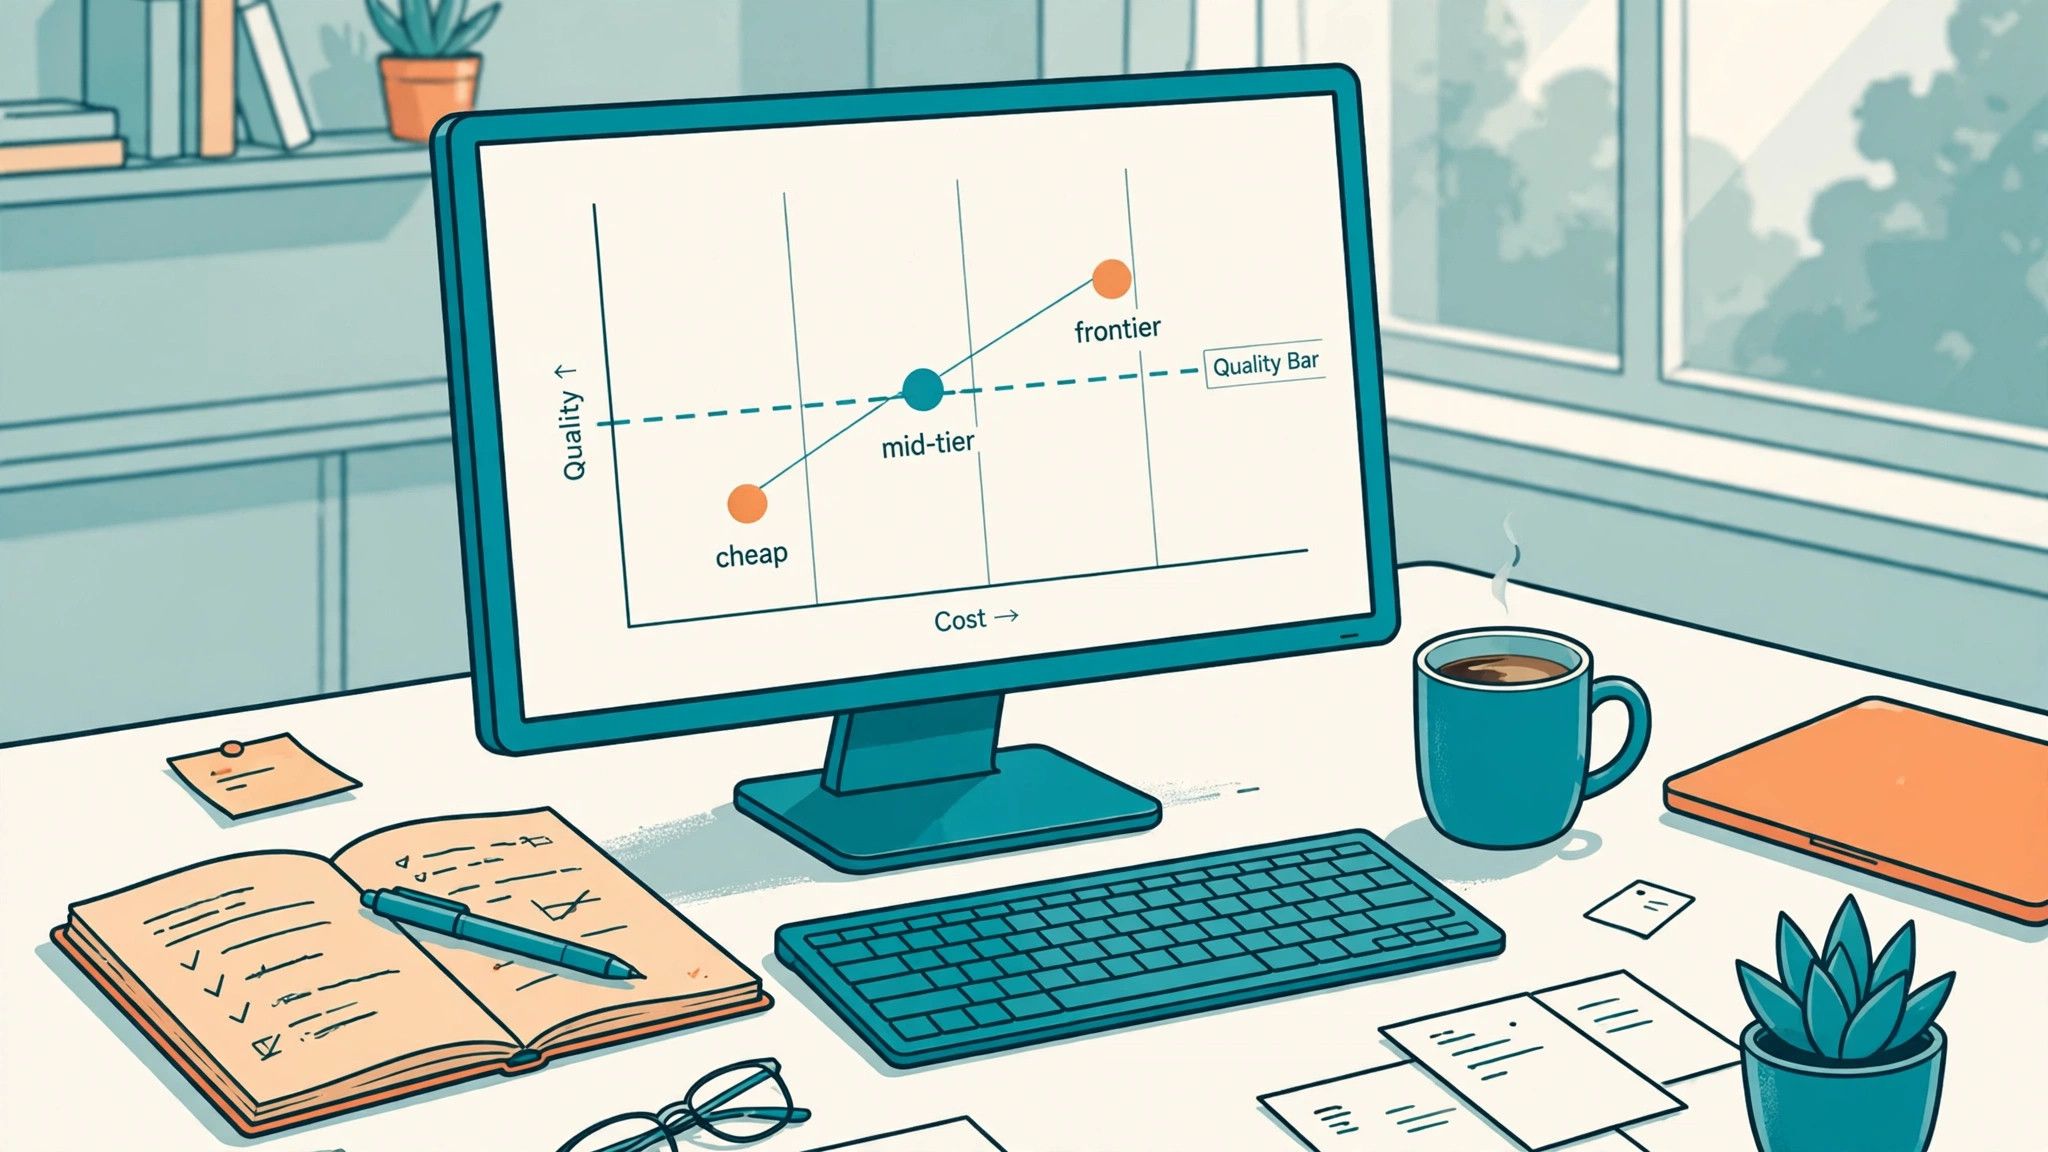
OpenRouter 发布 Agent 模型选型框架:先给任务定质量线,再算清每质量点成本
AI资讯 AI导航 12 次阅读