
大模型推理优化
从注意力架构、KV 缓存到量化与推测解码,追踪让大模型推理更快、显存更省的关键技术进展,帮你看懂每次提速背后的原理。
专题介绍
模型越来越大,推理成本成了真正的门槛。这个专题追踪注意力架构、KV 缓存优化、量化、推测解码、推理框架与部署调优等方向的实质进展:每次提速是怎么做到的、省了多少显存、代价是什么。适合关心模型落地成本与响应速度的开发者和产品团队。
蚂蚁集团发布 Ling-3.1-flash:5600 亿参数,专攻 Agent 与长任务,试用两周后开源
AI资讯 AI导航 48 次阅读
DeepSeek 开源昇腾版推理组件:国产算力补上关键一环
AI资讯 AI导航 33 次阅读
GPT-6.1 Sol 发布:智能体编码接近 Astra,价格只要五分之一
AI资讯 AI导航 24 次阅读
Transformer 是什么?主流大模型都在用的核心架构
AI百科 AI导航 28 次阅读
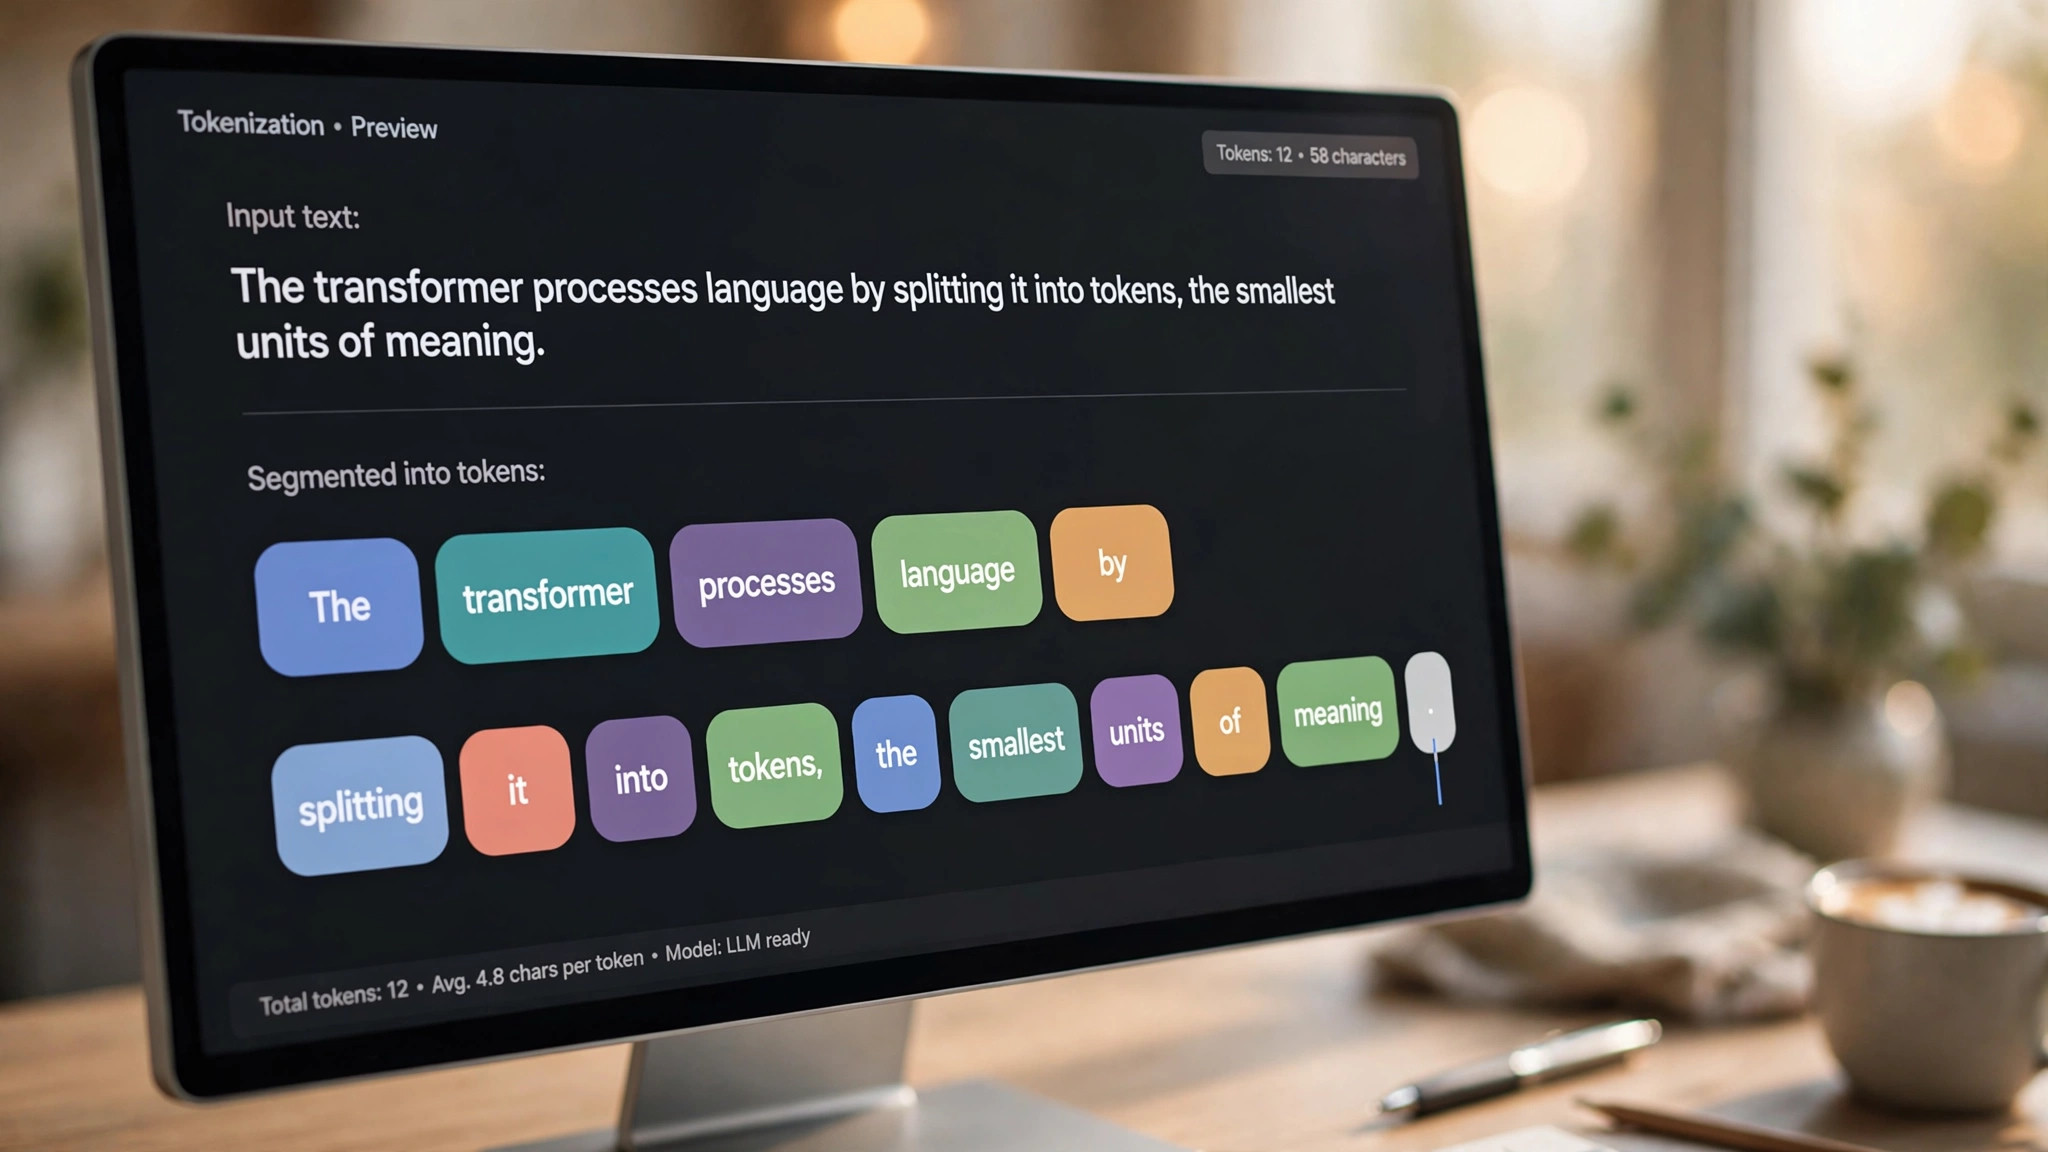
Token 是什么意思?大模型处理文字的最小单位
AI百科 AI导航 26 次阅读
模型蒸馏是什么意思?小模型为什么能学到大模型的本事
AI百科 AI导航 25 次阅读
vLLM 上线无失真文本水印:AI 生成内容可验明出处,性能几乎零损耗
AI资讯 AI导航 12 次阅读
Claude Opus 5.5 降价 40% 背后:缓存读取降价 60%,长会话编码场景最受益
AI资讯 AI导航 6 次阅读