
本地部署
数据不许出内网、云账单越跑越贵,就该考虑把模型搬回本地。llama.cpp、Ollama、GGUF 量化这些本地推理方案怎么搭、硬件怎么选,这里一次讲透。
专题介绍
本地部署不是把云端模型下载下来那么简单:显存、量化格式、推理框架,哪个环节没算对都会翻车。本专题讲清本地跑大模型与调云 API 的取舍,整理 llama.cpp、MLX、GGUF 等方案的实操要点,帮你在隐私、成本与效果之间找到平衡。
Perplexity Computer本地跑Mac怎么用?订阅、内存与模型要求
AI问答 AI导航 5 次阅读
Perplexity Computer能在Mac本地跑:模型和智能体都不上云
AI资讯 AI导航 13 次阅读
微软扩展主权云:控制面板将预览,欧洲工程师访问要过本地监督
AI资讯 AI导航 9 次阅读
FLUX 3 Image Klein开放权重:5.6B参数,8GB显存可本地运行
AI资讯 AI导航 30 次阅读
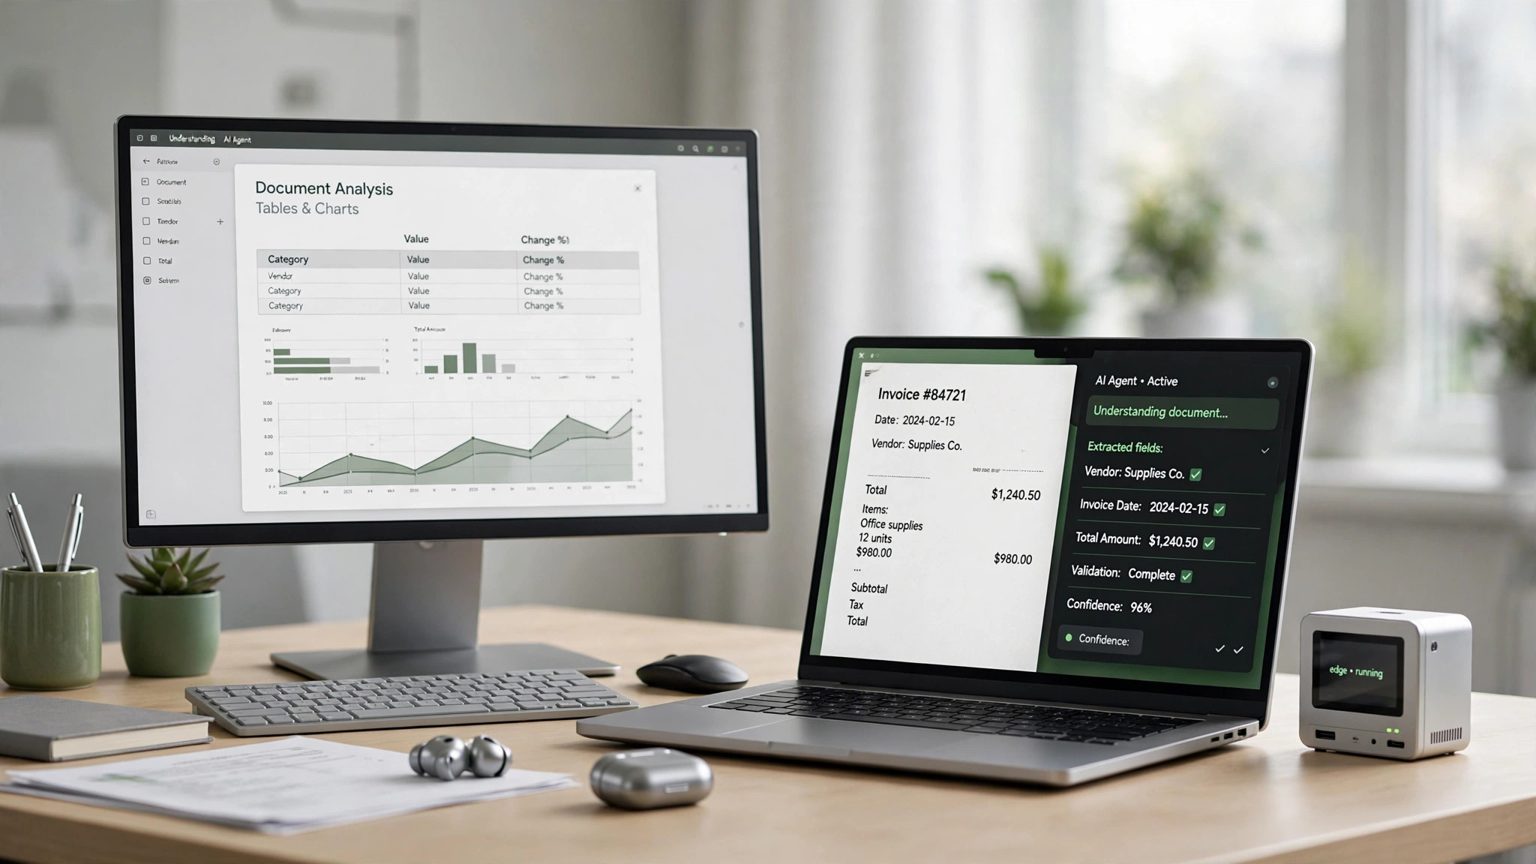
Nemotron 3.5 Super VL发布:120B多模态模型配端侧Bolt
AI资讯 AI导航 18 次阅读
昆仑万维Matrix-Game 4.0开源:单张RTX 5090实时跑视频大模型游戏,引擎管规则、模型画画面
AI资讯 AI导航 22 次阅读
LoRA是什么?冻结原模型只练小矩阵,微调成本为何骤降
AI百科 AI导航 18 次阅读
Liquid AI发布LFM2.5-24B-A2B:24B参数只激活2B,端侧智能体再提速
AI资讯 AI导航 21 次阅读