
多模态AI
能同时看懂文字、语音、图像和视频的 AI,正在把通用助手从概念变成现实。看多模态模型的发布、能力评测与应用场景。
专题介绍
只会聊天的 AI 已经不够看了——真正的通用助手要能看图、听声、理解视频。多模态就是这条路:各家旗舰模型都在向全模态演进。内容包括多模态大模型的发布动态、跨模态能力对比与真实应用场景,帮你看懂 AI 是如何打通多种感官的。
2026年AI视频生成工具推荐:7款对比,短视频团队这样选
AI精选 AI导航 1 次阅读
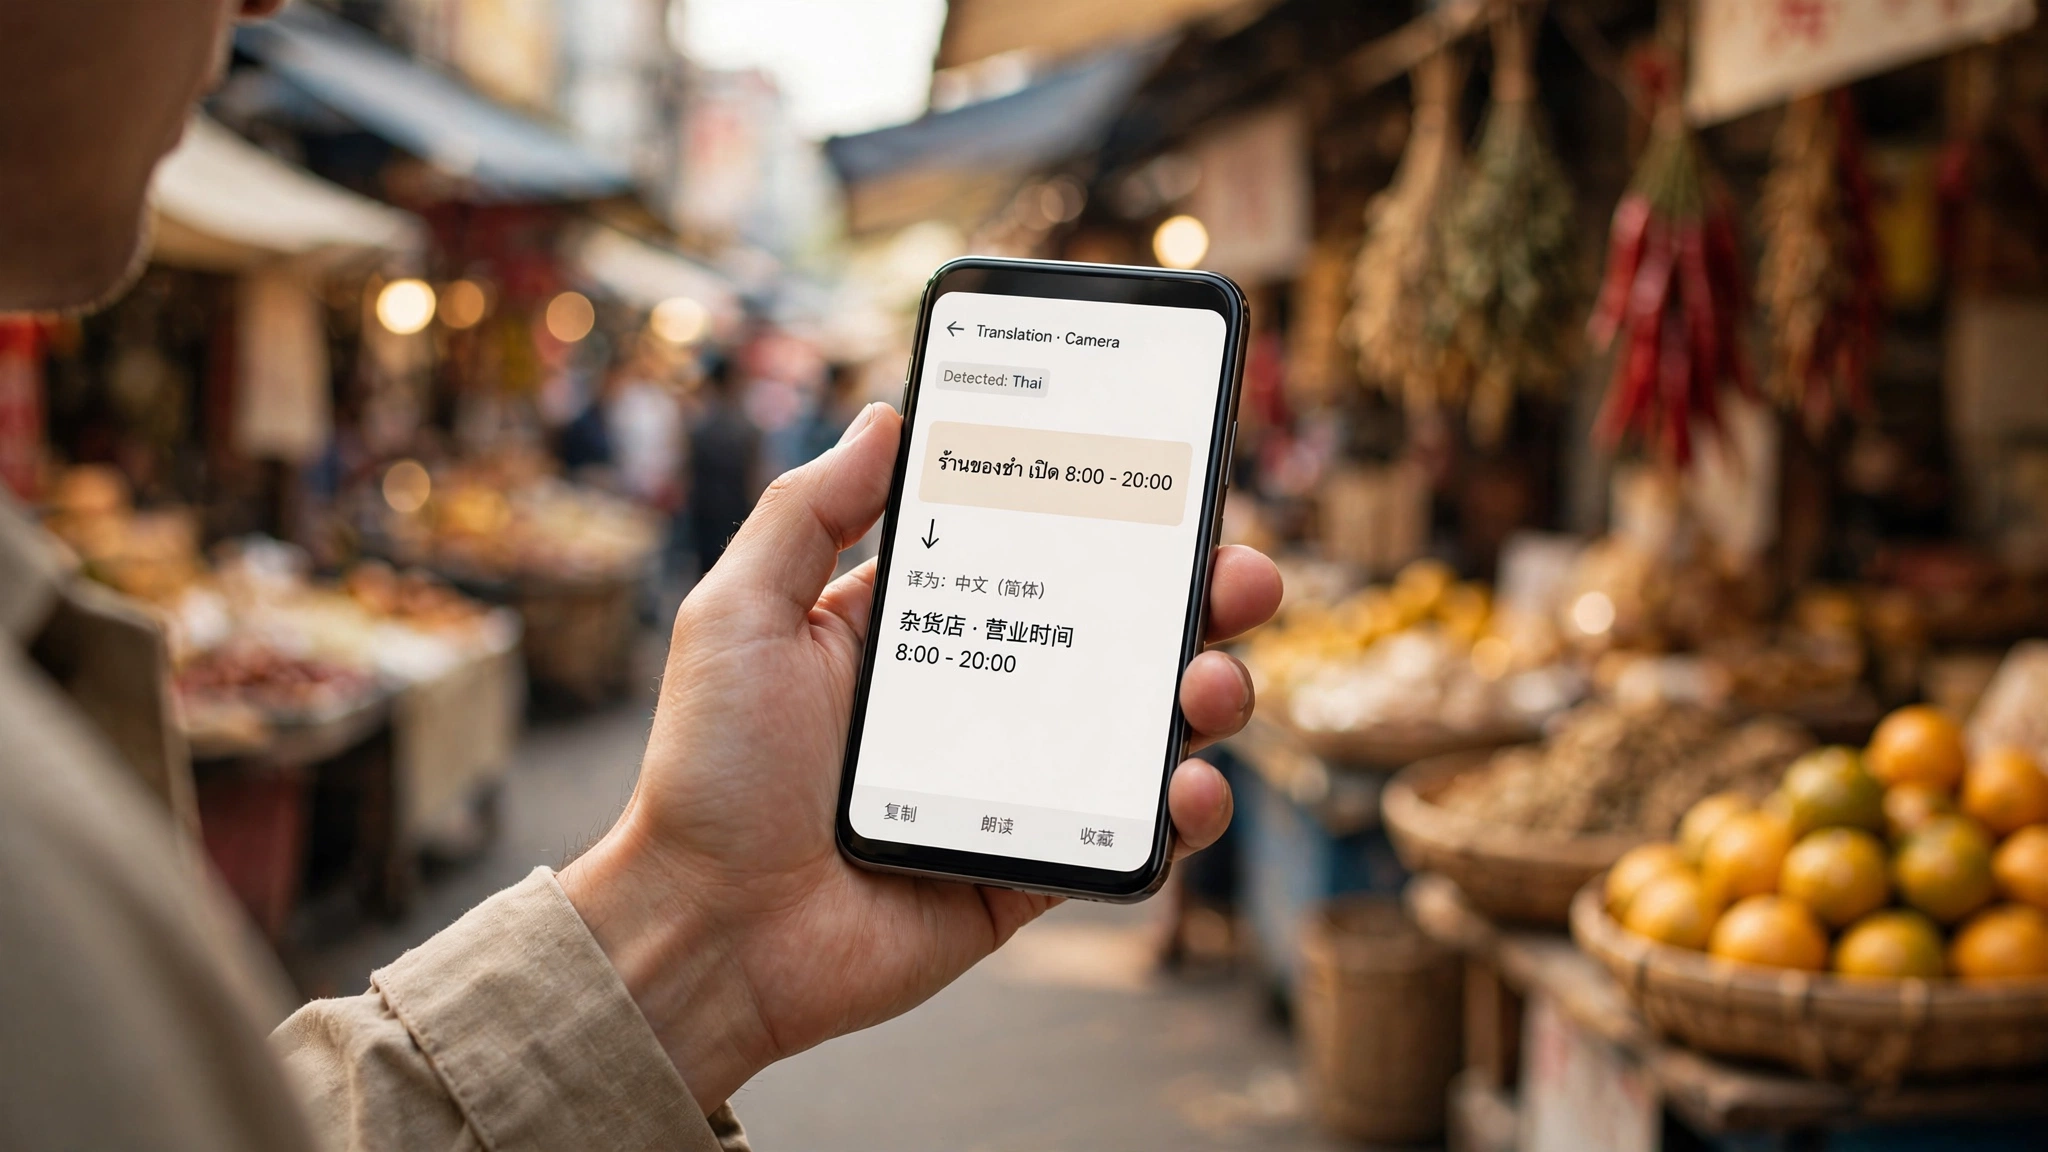
腾讯Hy翻译App今日上线:33种语言互译,语音拍照离线都能用
AI资讯 AI导航 2 次阅读
Google 发布 Gemini 3.8 Flash TTS:语音生成更快更便宜,支持 100+ 语言
AI资讯 AI导航 1 次阅读
小米开源 MiMo-V2.6:万亿参数全模态模型登顶开源榜
AI资讯 AI导航 0 次阅读
DeepSeek-V4.1-Flash 发布:原生多模态进入新架构起点
AI资讯 AI导航 11 次阅读

Thinking Machines 发布 Inkling,9750 亿参数多模态模型开放权重
AI资讯 AI导航 21 次阅读

Google 推出 Nano Banana 2 Lite 与 Omni Flash,生成成本继续下探
AI资讯 AI导航 13 次阅读

HunyuanImage 3.0-Instruct上线:原生多模态理解与高保真图像合成能力公布
AI资讯 AI导航 66 次阅读