奖励模型
奖励模型把人类对回答的好恶变成一个分数,让大模型知道哪种回答更受认可,是理解 RLHF 与模型对齐绕不开的关键一环。
专题介绍
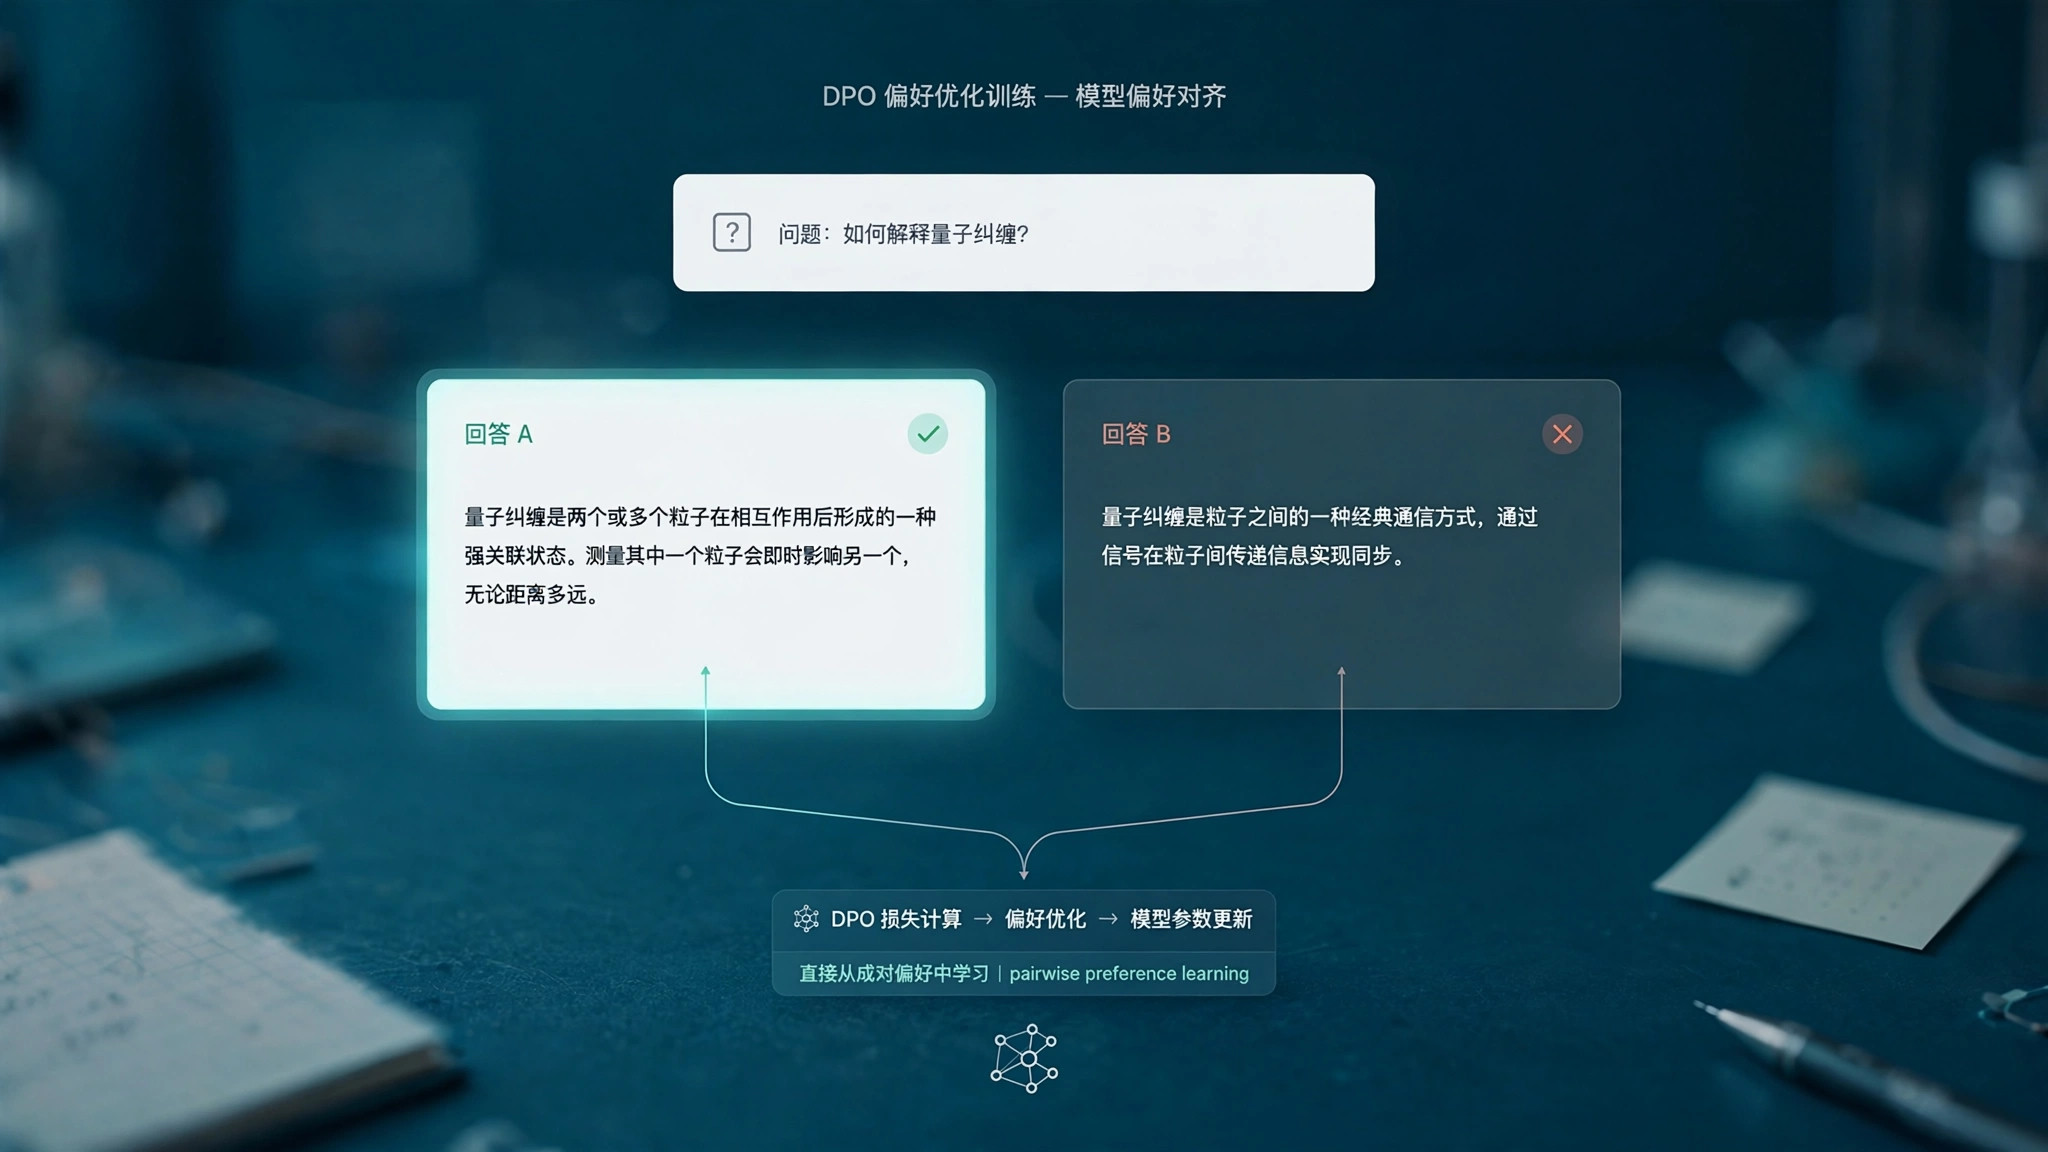
奖励模型是给大模型回答打分的打分器:它从人类挑出的成对回答里学会偏好,再把这种偏好变成连续分数,供强化学习或筛选回答使用;它只学到偏好的近似,不是绝对真理。专题会讲清它的训练方式、打分边界与奖励投机等局限。
奖励模型把人类对回答的好恶变成一个分数,让大模型知道哪种回答更受认可,是理解 RLHF 与模型对齐绕不开的关键一环。
奖励模型是给大模型回答打分的打分器:它从人类挑出的成对回答里学会偏好,再把这种偏好变成连续分数,供强化学习或筛选回答使用;它只学到偏好的近似,不是绝对真理。专题会讲清它的训练方式、打分边界与奖励投机等局限。