2026 年 9 月 24 日凌晨(北京时间),Google 开发者博客宣布:Antigravity SDK 开始支持本地模型,智能体工作流可以完全离线运行。首批支持的是 Gemma 4 26B A4B,通过 Google AI Edge 的 LiteRT 在本地 GPU 上跑。
简单说,写代码、审代码、修 bug 这些智能体任务,不再必须把代码发到云端。官方列了四个理由:省钱(没有 API 费用和速率限制)、隐私(代码和请求不出本机)、断网也能干活、以及可以和云端模型混搭。
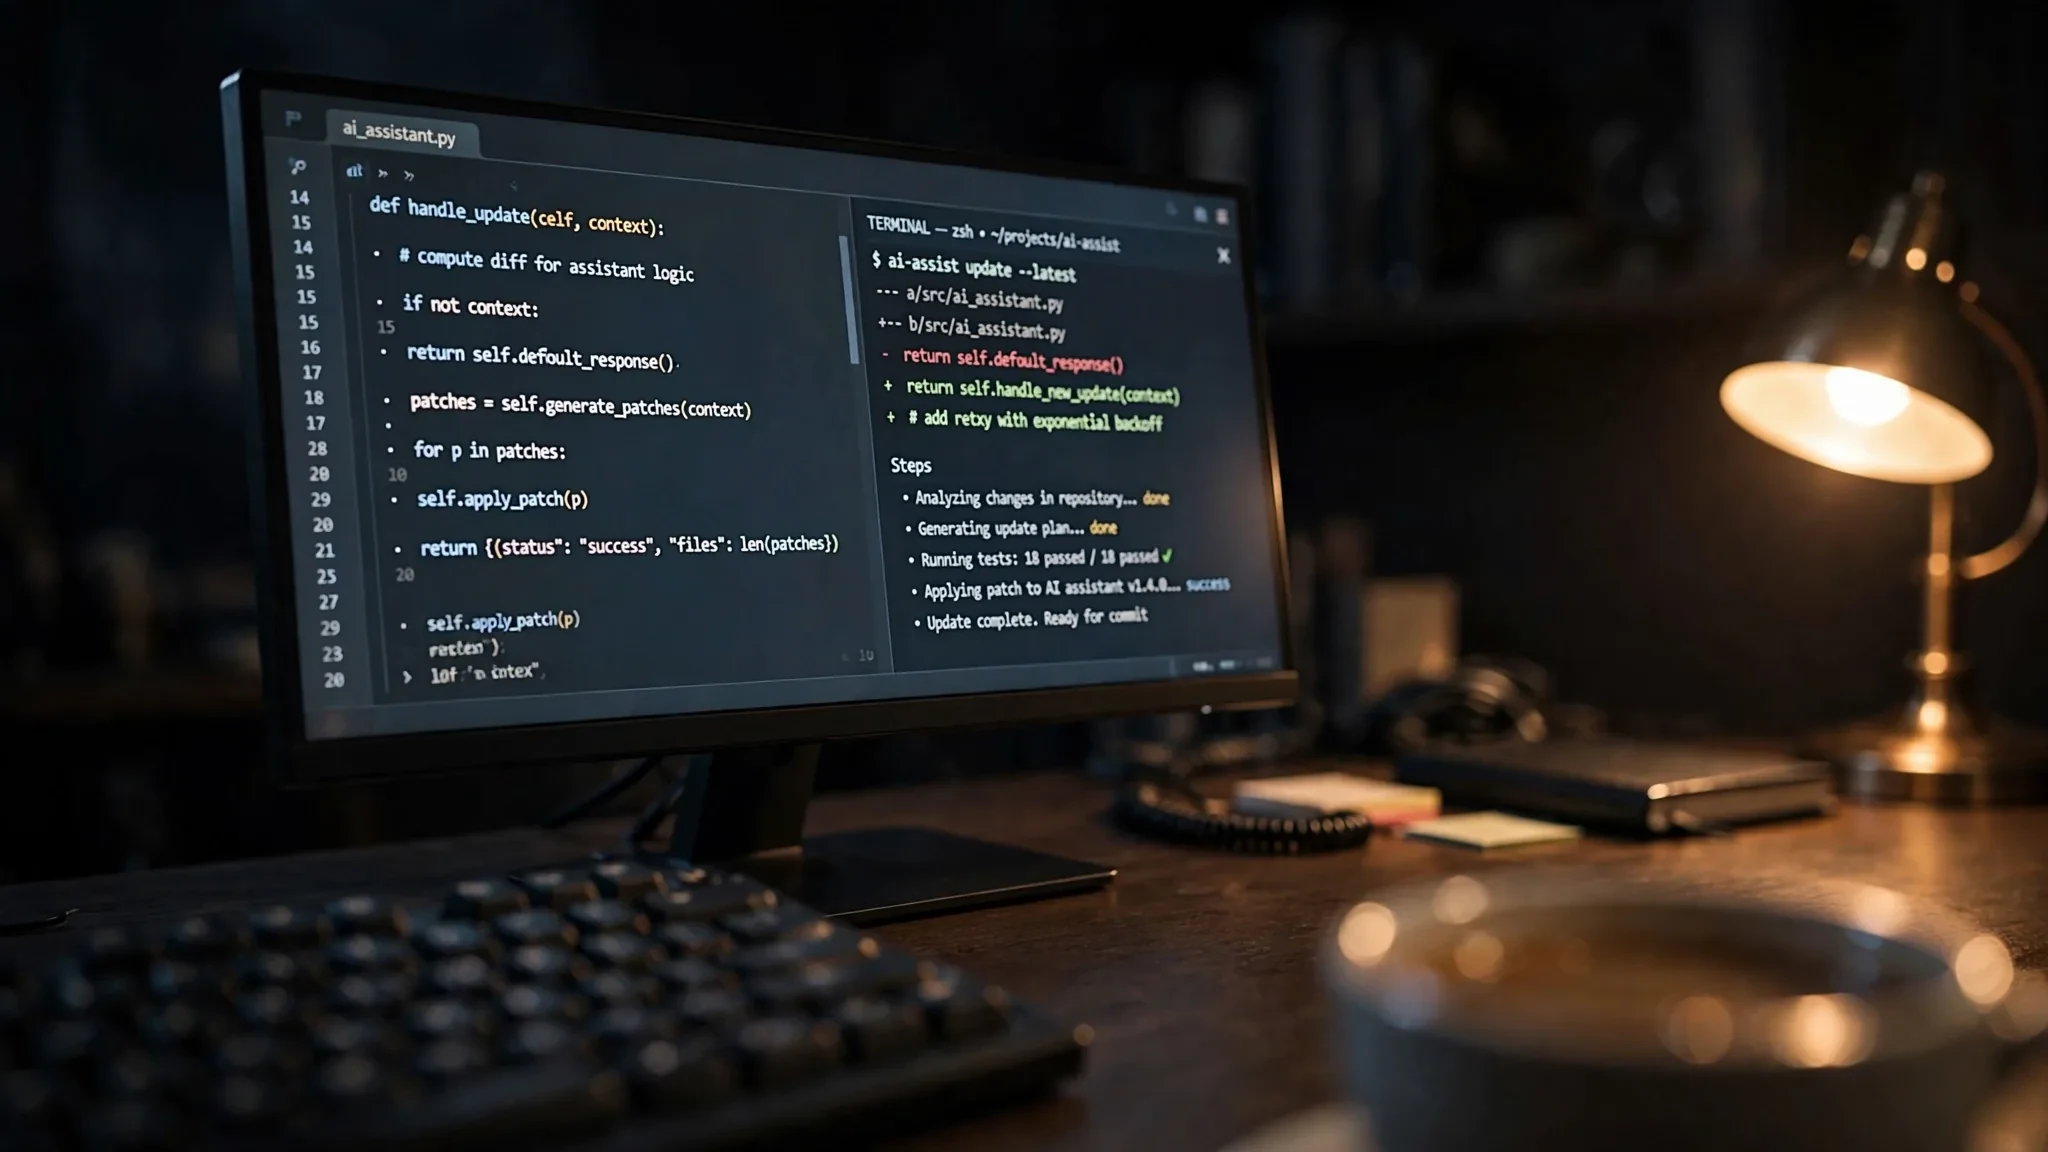
混合编排是这次最有看头的一段演示。任务是审计并修复三个有漏洞的模块(auth.py、billing.py、database.py):云端的 Gemini 3.8 Flash 当“架构师”,只看文件名和任务描述就拆好策略、指挥全局,全程只花了 95 个云端 token,源代码一行没上传;本地的一群 Gemma 4 26B 实例在 GPU 上当“施工队”,复现漏洞、写修复、互相挑刺、跑回归测试。官方数据:这次运行里 97.2% 的 token(3322 个)在本地离线完成,补丁全部验证通过。
除了自己优化的 LiteRT 路线,SDK 还兼容任何 OpenAI 协议的本地推理后端——Ollama、LM Studio、vLLM 都能直接插进来,换后端不用改智能体的编排代码。博客里另一个例子很接地气:只给一句话提示,本地智能体就自己写了个终端资源监控工具,连依赖清单和测试都包了。
两道门槛先看清
第一是硬件。官方建议 24GB 以上显存或统一内存,普通轻薄本基本没戏,这是给工作站和高内存一体机准备的。第二是能力差距。Gemma 4 26B 再强也是本地小模型,复杂推理和超长上下文还是得靠云端旗舰模型,离线模式更适合“执行密集、规划轻量”的任务——官方的架构师加施工队分工已经说明了这一点。
适合谁、不适合谁
适合三类人:在合规严格的公司写代码、代码不许出内网的开发者;经常断网或弱网环境(出差、高铁、海外)还要干活的人;以及 Agent 用量大、想省 API 钱的团队。不适合:只想尝鲜、机器显存不够,或者主要做复杂架构设计、依赖超大上下文的人——这些场景云端模型仍然是正解。下一步可以看 Google 会不会把更多 Gemma 尺寸和端侧优化路线(比如手机端)接进来,以及 Ollama 生态的第三方模型在这种编排里表现如何。