KV缓存是大模型生成文字时,把前面每个词已经算出的键(Key)和值(Value)临时存进显存的一种做法:写下一个词时,模型不必把前文从头再算一遍,直接调出存好的结果接着算就行。它不保存原文,也不保存答案,存的是注意力计算中间产生的两组数字;没有它,长对话每多说一句,等待时间就会明显往上叠,有了它,生成才跟得上打字机式的逐词输出。
没有缓存时,每写一个词都要重头算前文
大模型写字是一个词接一个词往后推的。每生成一个新词,它都要回看前面所有词,判断哪些词对当前这一步更重要、应该参考多少,这个回看过程就是注意力机制在做的事。具体计算时,每个词会被换算成三组数字:负责提问的查询、负责被匹配的键、以及真正被取用的值。
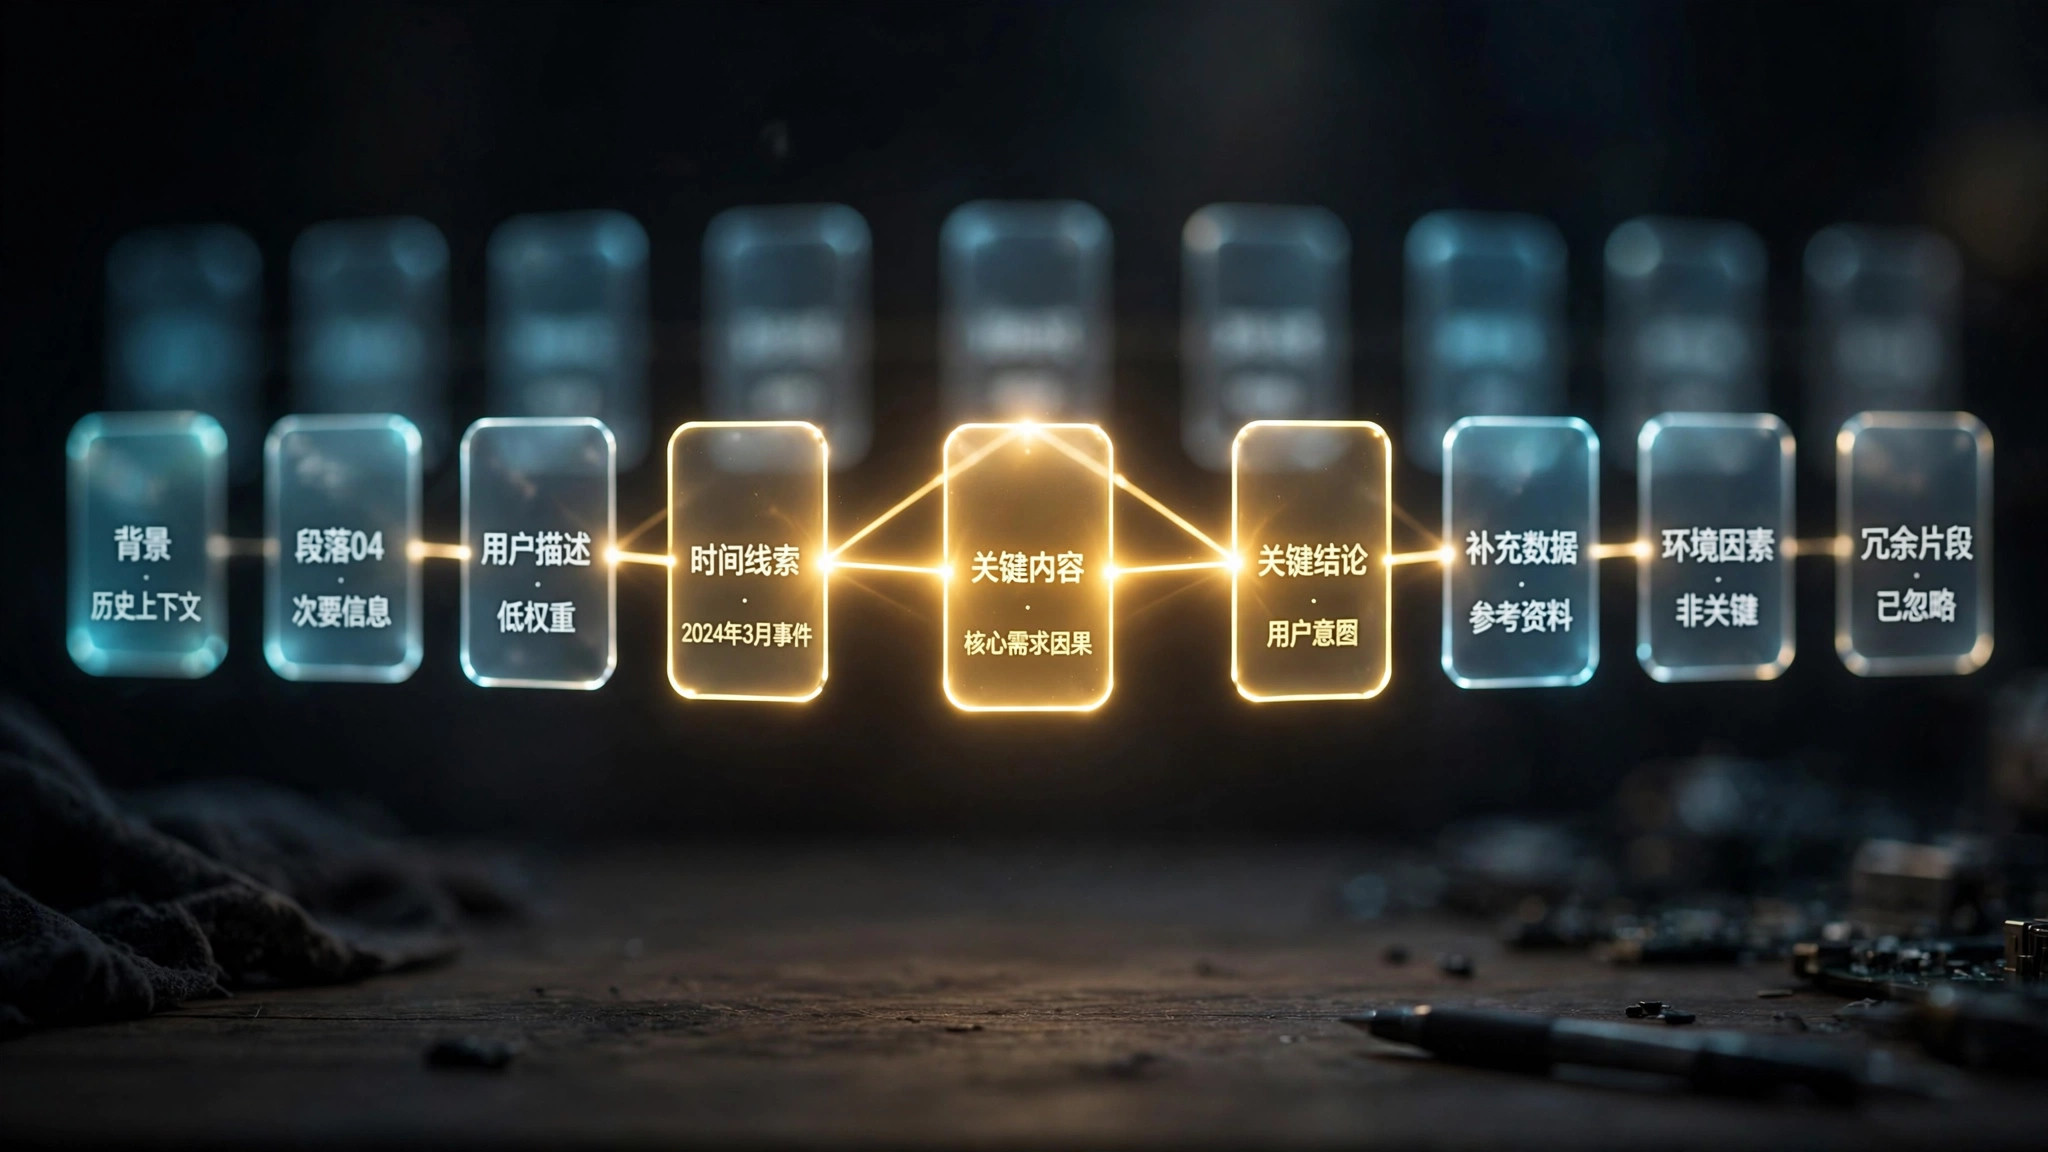
问题出在重复上。假设一句话已经写了 500 个词,要写第 501 个词,前 500 个词的键和值其实和上一步算的完全一样;写第 502 个词时,又会再重复一次。文本越长,这种白算的部分越大,计算量会随着长度近似平方级膨胀。实际系统把生成拆成两段:先把用户输入整段读一遍,算出最初的键和值,这一步叫预填充;之后逐词往外写,每一步只给新词算一份键和值,再把它追加进缓存,这一步叫解码。KV缓存真正改变的是解码阶段,让每一步的计算量只跟新词有关,不再跟全文长度一起涨。
缓存里存的不是文字,是算过的中间结果
这一点最容易被误会。KV缓存里没有句子、没有段落,也没有任何能直接读出来的内容,只有每个词在每一层注意力里对应的一串数字。同一个词出现在不同位置、不同上下文里,算出的键和值并不相同,所以缓存和具体的一次生成过程绑得很紧:换一个问题、改动前文任何一个词,后面的缓存就不能再原样套用。
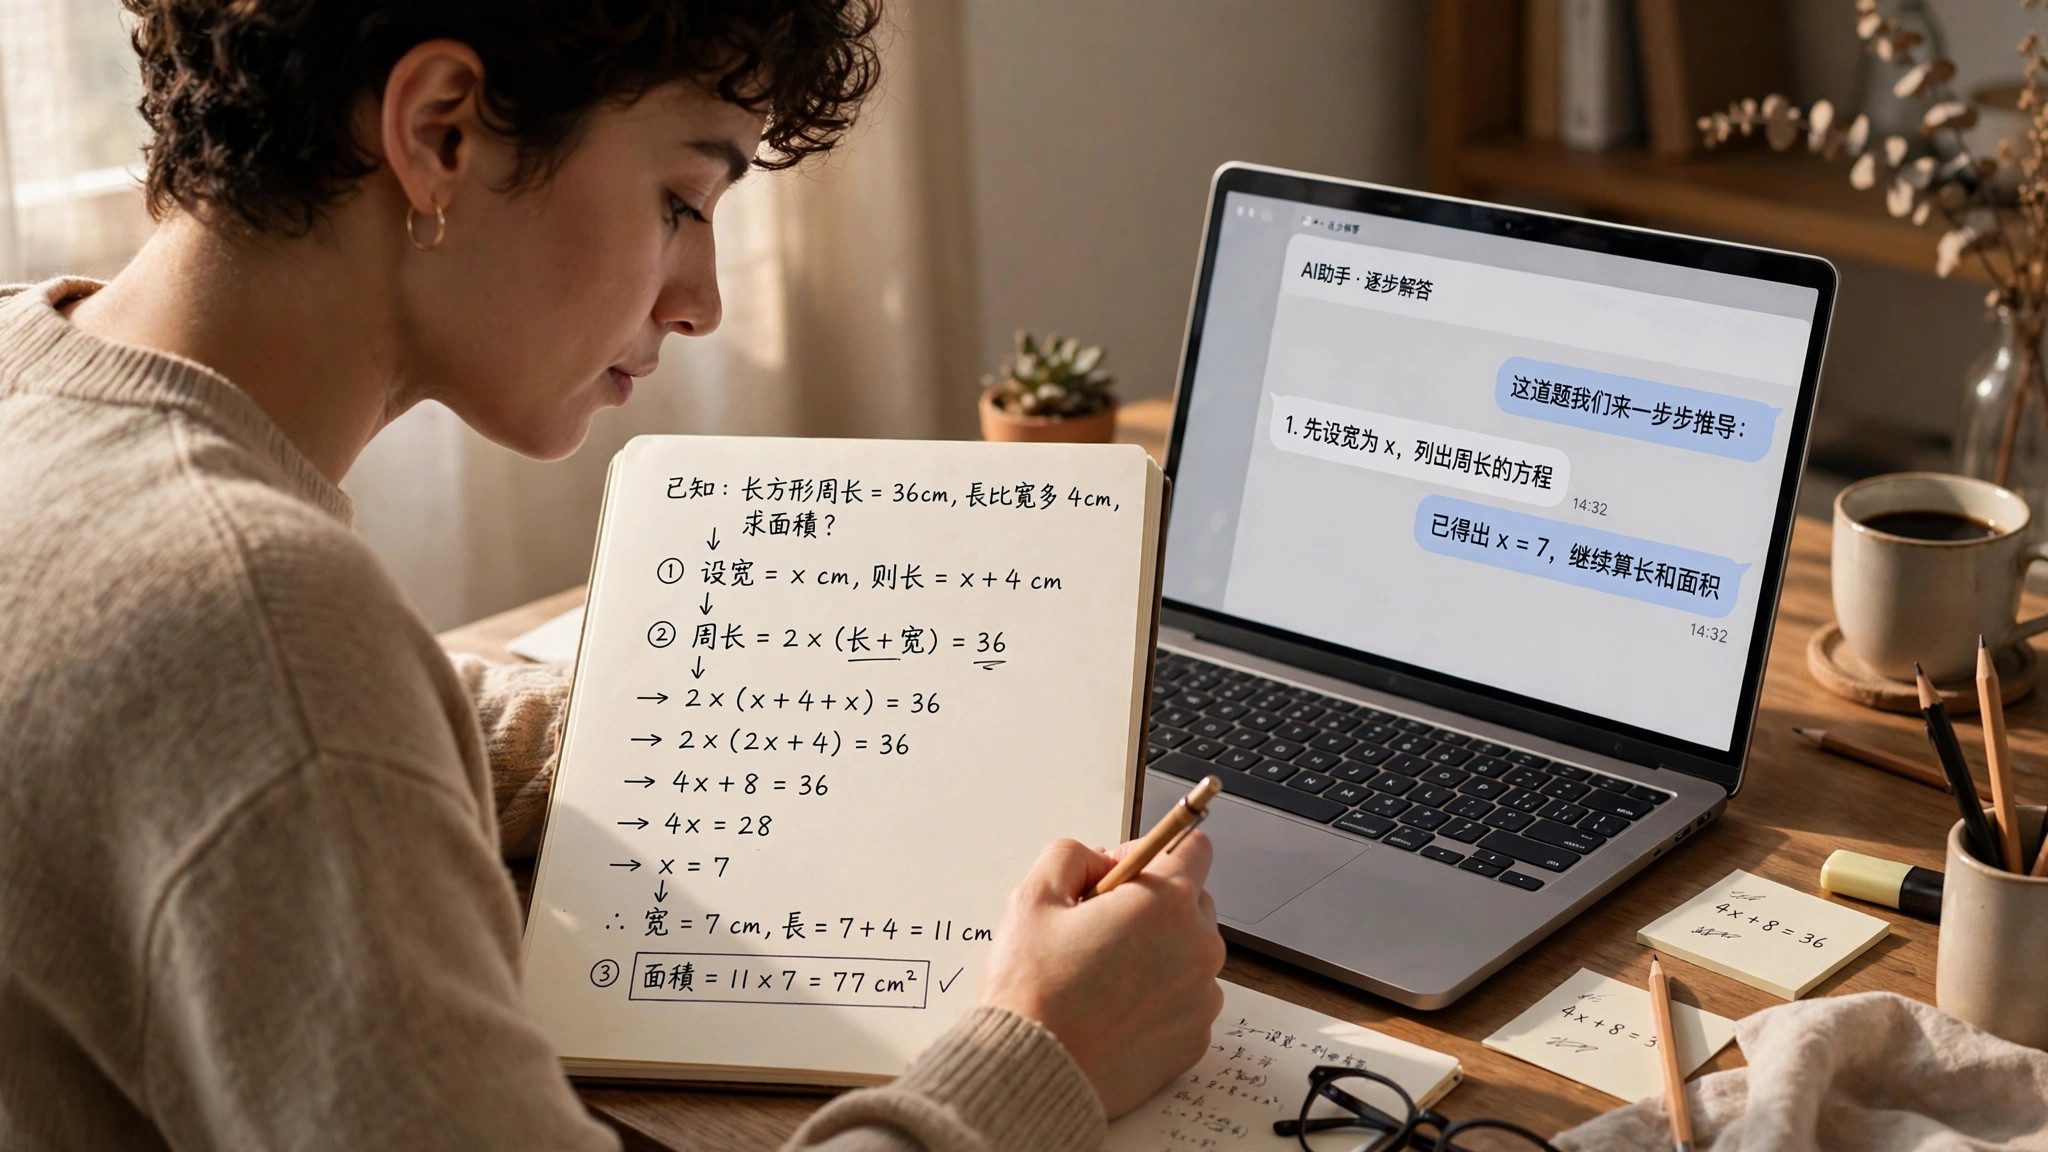
它还有一个朴素的类比可以帮着理解。做一道多步骤的数学题时,把前面几步的结果写在草稿纸边上,后面直接抄来用,就不用每一步都从第一行重算。KV缓存扮演的就是这张草稿纸,区别是草稿上写的不是人能看懂的算式,而是模型内部的中间量,生成一结束,这张纸通常就被扔掉,下一次对话重新再写。
它和提示词缓存、上下文窗口不是一回事
名字相近的概念有三个,混在一起就会把速度、容量和记忆这三件事谈乱:
| 概念 | 解决的问题 | 存的是什么 | 生命周期 |
|---|---|---|---|
| KV缓存 | 同一次生成里少算重复的前文 | 注意力中间的键和值 | 通常只活在这次请求内 |
| 提示词缓存 | 多次请求开头相同,少算重复的开头 | 相同前缀对应的计算结果 | 可跨请求保留一段时间 |
| 上下文窗口 | 模型一次最多能看多少内容 | 不是存储,是容量上限 | 由模型本身决定 |
上下文窗口决定一篇材料能不能整个放进去,KV缓存决定放进去之后写起来快不快,两者一个管上限、一个管速度。提示词缓存则是在 KV缓存的基础上再往外走一步:很多请求都带着同一段很长的系统说明或固定材料时,把这段共同开头的计算结果在多次请求之间留住,新请求就不必连预填充也从零开始。它省的是跨请求的重复,KV缓存省的是同一次生成内部的重复。
至于很多人以为的记住偏好、记住上次聊过什么,那是产品层面的对话记录和记忆功能,和显存里这份缓存没有关系。关掉一个聊天窗口,服务端留下的可能是聊天记录,不会是当时那份键和值。
省下来的时间,是拿显存换的
KV缓存不是免费提速。缓存的大小跟着几个因素一起涨:文本越长,存的份数越多;模型层数越多、注意力头越多,每份要存的数字也越多。对话写到几万甚至十几万词时,这份缓存占用的显存可能比很多人预想的要夸张,甚至成为一张显卡能同时服务多少人、能把上下文撑多长的实际瓶颈。
这也解释了几个日常现象。长对话里第一个词往往等得久,后面反而出得相对顺,因为贵的那次整段预填充只在开头发生一次。本地跑模型时,明明模型文件本身装得下,聊长了却报显存不足,多半就是缓存随着对话一起长,把剩下的显存吃完了。服务商做高并发时同样要算这笔账:同一张卡上同时开的对话越多,每份对话能分到的缓存空间就越紧。
为了把这笔账压下来,工程上常用的办法包括把缓存里的数字用更低的精度存、只保留最近一段窗口的缓存、把不常用的部分换出到内存里,或者让多个请求共享相同前缀的那份缓存。这些办法都在同一个方向上取舍:省显存,或者保效果,很少能两头都占满。
三个流传很广的误解
第一个误解是缓存越大,模型就越聪明。不是。缓存只决定算得快不快、能撑多长,不增加任何新知识,也不改变模型对内容的理解深度。把缓存清掉,模型不会变笨,只会变慢,因为它要把前文重新算一遍。
第二个误解是模型靠 KV缓存记住了你。单次生成里,它确实是靠这份缓存回看前文的,但这是一种临时的计算便利,不是长期记忆。请求结束、缓存释放之后,模型本身不会因为这次对话多记住任何东西;下一次还能接上话题,靠的是产品把历史消息重新发给模型再算一遍。
第三个误解是只要有了缓存,长文本就不再有成本。恰恰相反,缓存把成本从重复计算挪到了显存占用上。上下文翻倍,预填充更久,缓存也跟着翻倍;很多长上下文用起来又慢又贵的根子,就在这里,而不是模型故意限速。
什么时候你会实际感受到它
普通短问答里,KV缓存的存在感很低,问一句答几行,前文没多长,重算也花不了多少时间。它真正起作用的场景都很具体:连续追问很多轮的长对话、一次塞进整份文档再反复提问、写长代码文件时不断续写,以及本地部署时想把上下文再开大一点。这些场景的共同点是前文长、生成也长,省下的是每一步都在重复的那部分账。
判断一个工具或接口的长文本体验时,与其只看它标称的上下文有多大,不如实际试三件事:长材料发进去后第一个词要等多久,后面生成是否稳定不卡顿,以及多轮追问后速度有没有明显掉下来。这三点背后,很大程度上就是预填充、KV缓存和显存调度在起作用。看懂这层关系,就不会再把慢简单归因于模型不行,也不会把上下文大直接当成体验一定好。