上下文窗口是大模型在一次处理中能同时看到的文本总量上限,按 Token 计算:你发过去的系统提示、之前的对话、粘贴的文档,再加上模型正在生成的回答,全都要装进这一个窗口里。窗口之外的文字,模型不是记性差,而是根本没读到。常听到的 8K、128K、1M,说的都是这个上限,比如 128K 指 12.8 万个 Token,换成中文大约是十万字量级。把这个定义抓住,几个最常见的困惑就解开了:为什么聊着聊着它就忘了开头,为什么文档塞得越长反而答得越飘,为什么窗口越大的模型往往越贵。
窗口里到底装了什么
很多人以为窗口只装用户输入,其实一次请求里至少有四样东西在抢位置。
- 系统提示:应用预先写好的角色设定、规则和格式要求,你看不见,但它一直占着开头的位置。
- 对话历史:多轮聊天时,之前每一轮的问答都会被重新打包发给模型,聊得越久,历史吃掉的额度越多。
- 你提供的资料:粘贴的文档、检索回来的片段、工具调用返回的结果,都要先进窗口,模型才能引用,没进窗口的资料等于不存在。
- 模型正在生成的回答:回答也是逐个 Token 往外吐的,写得越长占用越多。很多接口单独标一个最大输出上限,就是怕回答把窗口撑爆。
这也解释了一个常见现象:同一份长文档,在新对话里问得好好的,聊了二十轮再问就开始出错。不是文档变了,是历史对话把窗口挤满了,文档的关键段落被挤了出去。想让长对话保持靠谱,定期把关键背景重新贴一遍,比指望模型自己记得住管用。
它和知识、记忆、RAG 不是一回事
这组概念最容易混,分清之后能少踩很多坑。
和知识的区别。 知识是模型训练时学进参数里的东西,像一个人读书多年形成的常识,回答时不用翻书。窗口里的内容则是临时摊在桌面上的资料,这次会话结束就没了。模型知识再渊博,你不把合同条款放进窗口,它也不知道这份合同写了什么;反过来,你把最新财报放进窗口,它能引用,却不等于学会了,下次新开对话还得重新放。
和记忆功能的区别。 有些产品有跨会话记忆,那是应用层把你的偏好和事实存进数据库,下次对话再取出来放进窗口。记忆是仓库,窗口是桌面:仓库可以很大,但每次能摊到桌面上的,永远受窗口限制。
和 RAG 的区别。 RAG 是先检索再喂的取料方式,解决的是资料太多、桌面放不下时先挑哪几段放上来。它改变不了桌面大小,只改变放什么。窗口决定容量,RAG 决定取舍,两者是配合关系,不是替代关系。
窗口越大越好吗?先看三个代价
厂商把窗口从 4K 一路卷到 1M、2M,很容易让人以为越大越强。实际上有三个代价绕不开。
第一是贵和慢。注意力机制要让窗口里的每个 Token 都和其他 Token 算一遍关联,计算量随长度近似平方增长。窗口翻倍,成本涨得比翻倍还多,响应也更慢,所以长窗口模型要么按 Token 收费更高,要么对超长输入单独加价。
第二是注意力稀释,中间最容易丢。实测中普遍存在中间迷失现象:放在长文本开头和结尾的信息,模型用得比较好;埋在中间的关键段落,最容易被漏掉。128K 窗口塞满 12 万个 Token,不等于这 12 万个 Token 都被同等认真地读了。把最重要的材料放在开头或结尾、给长文档加目录和分段标题,都是在对抗这个毛病。
第三是标称值和有效值不是一回事。标称 1M 的模型,处理几万 Token 时可能又快又准,塞到八十万时质量明显下滑。选型时别只看参数表,拿自己最长的真实文档实测一次再下结论。
窗口满了会发生什么
不同产品的处理方式不一样,逃不出三种。
- 从头截断:最早的内容被直接丢弃。表现是聊久了之后,模型忘了你最初提的格式要求,改口换了另一种排版。它不是故意的,是那段话已经不在窗口里了。
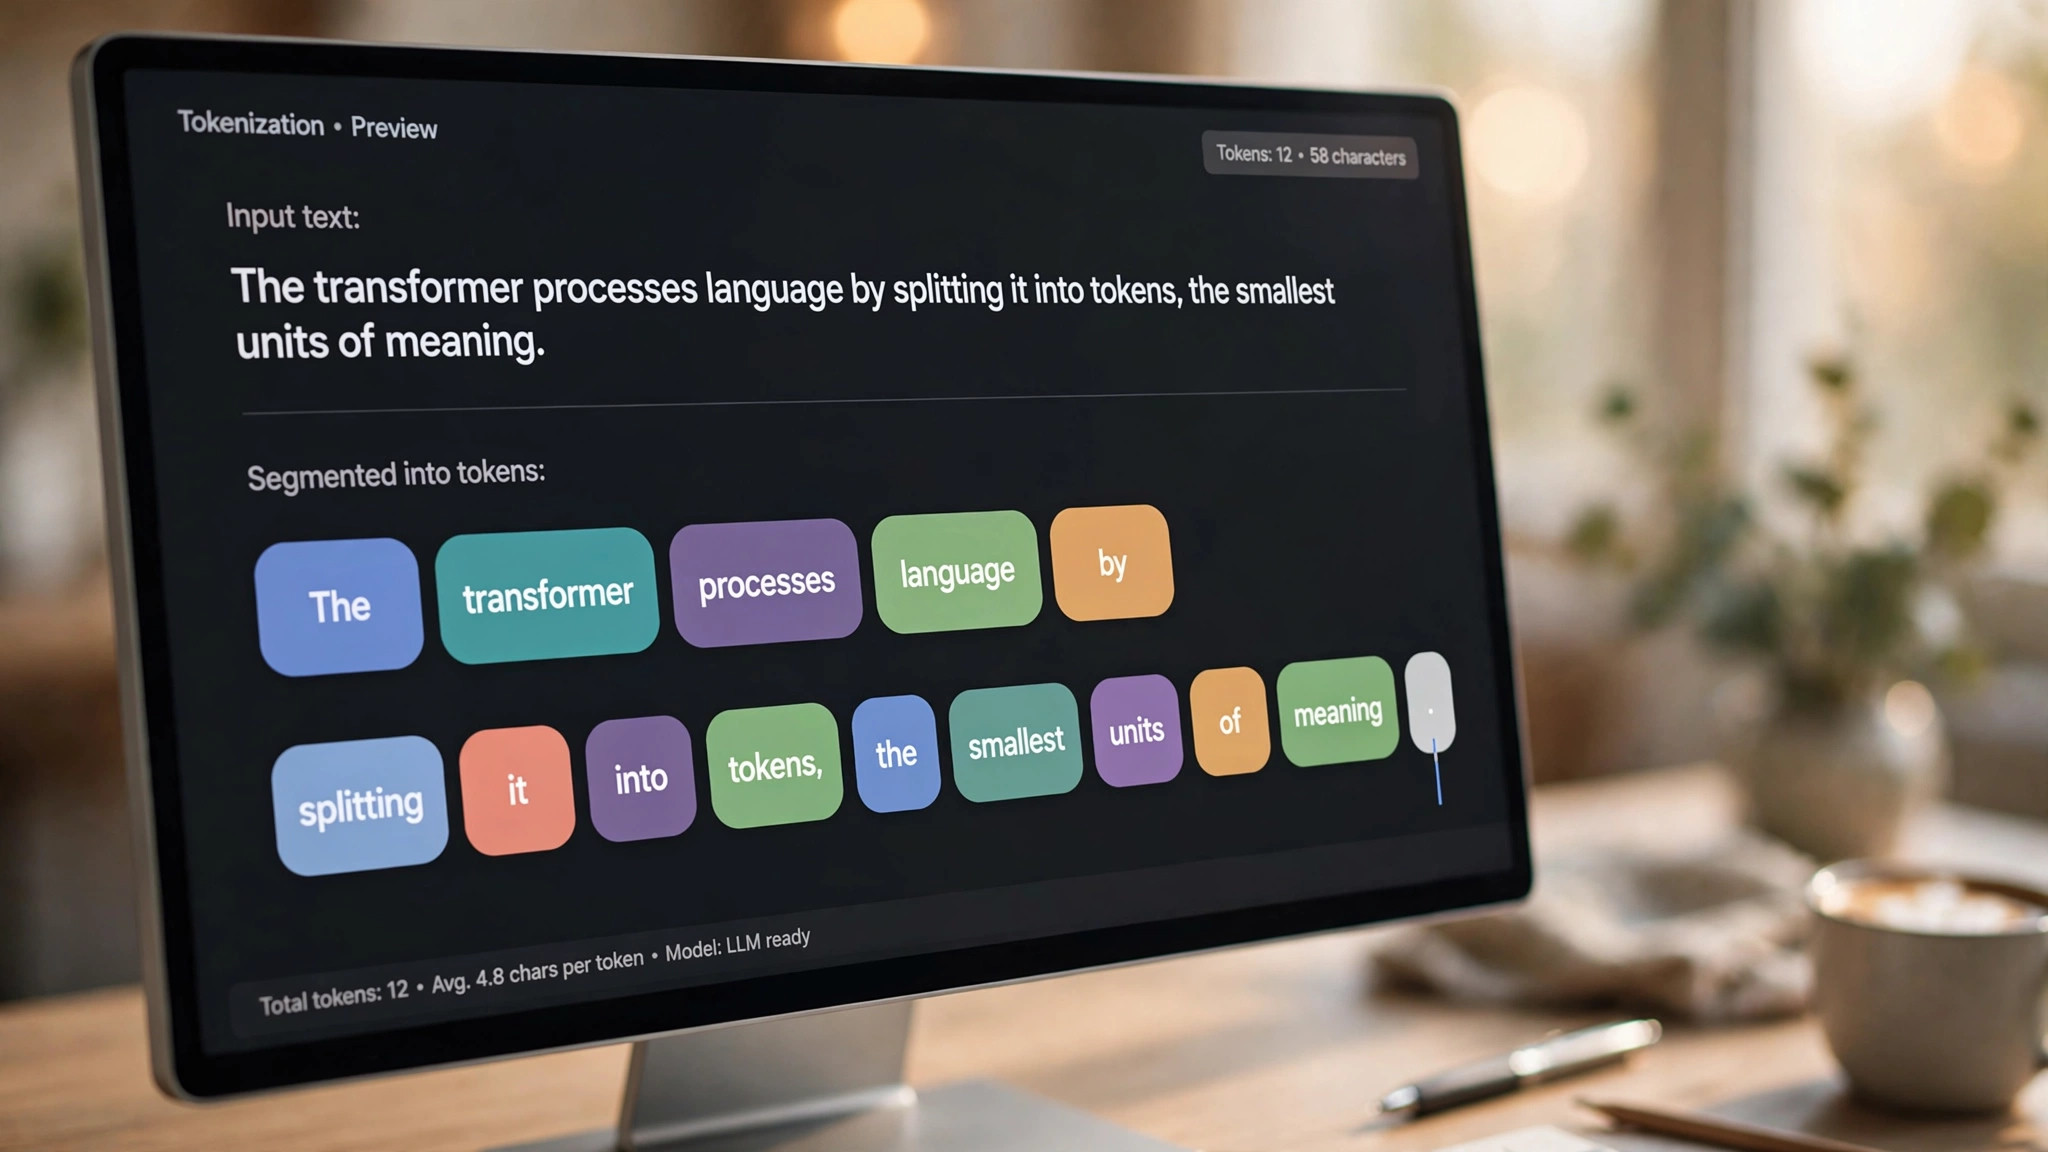
- 直接报错:调用 API 时输入超过上限,请求会被拒绝。需要在发送前自己数 Token、做裁剪,Token 怎么计量是这里的基本功。
- 自动总结压缩:一些产品会把早期对话压成一段摘要,用摘要顶替原文继续聊。代价是细节会丢,摘要里没写到的数字和口头约定,后面就找不回来了。
对应的实用习惯是:长对话里重要的约束,比如格式、预算、禁忌,隔一段时间重申一次;或者干脆开个新会话,把关键背景重新贴一遍。这比反复提醒模型你应该还记得可靠得多。
窗口不够用时,四种办法怎么选
| 办法 | 适合什么情况 | 代价 |
|---|---|---|
| 换长窗口模型 | 资料总量大但有限,比如一份几百页的报告要通读找矛盾 | 更贵更慢,超长时仍有中间迷失 |
| RAG 检索 | 资料是持续更新的大知识库,每次只用其中一小部分 | 要建检索链路,检不准就答不准 |
| 分段处理再汇总 | 任务能拆开,比如逐章总结再合并 | 段与段之间的全局关系会丢一部分 |
| 先总结压缩再继续 | 对话太长、历史细节不重要,只保留结论接着聊 | 被压掉的细节无法恢复 |
判断顺序并不复杂:先看资料会不会变,天天更新的知识库优先 RAG;再看任务需不需要全局,通读固定报告找前后矛盾,分段汇总容易漏,宁可换长窗口模型;最后看预算,长窗口是最省事的办法,通常也是最贵的办法。
最后回到这个概念本身:Token 决定模型怎么计量文字,上下文窗口决定它一次能看多少,RAG 和总结决定往窗口里放什么。把这三件事分开,你再看任何一款大模型的介绍页,不管它主打 128K 还是 1M,都知道该拿什么去试它、试的时候该盯着什么看。