注意力机制是大模型在处理一段文字时,动态决定每个词应该重点参考哪些词的计算方法,英文叫 Attention。它不把一句话里所有词一视同仁,而是先算出词与词之间的相关程度,再按相关程度把信息加权汇总:关系越紧的词,对当前词的影响越大。ChatGPT、Claude 这类模型能读懂长对话、抓住前文埋下的关键信息,靠的正是这一步;它也是 Transformer 架构最核心的部件。
先看一个例子:模型怎么知道“它”指谁
读这句话:“小狗追着皮球跑进院子,它累得趴在地上。”人一眼就知道“它”指小狗,不是皮球,也不是院子,因为前文里小狗是动作的主体。模型没有这种直觉,它要靠计算:处理“它”这个词时,注意力机制会拿“它”去和前面每个词逐一比对相关程度,给小狗打出高分,给皮球、院子打出低分,然后主要按小狗的信息来理解“它”。
这种比对不是查词典查出来的固定关系。同一个“苹果”,在“苹果发布了新手机”里会被重点关联到“发布、手机”,在“吃一个苹果”里则关联到“吃”。注意力权重是随上下文现场算出来的,这也是它比早期按固定顺序逐词阅读的方法更灵活的地方:哪两个词相关,不取决于它们离得多远,而取决于内容本身。
查询、键、值:三步算出该看谁
注意力计算常被拆成三个角色,名字听起来玄,其实对应一次很朴素的检索:
- 查询(Query):当前词想找什么。比如处理“它”时,查询相当于在问“谁在做趴下这个动作”。
- 键(Key):每个词亮出的标签,说明自己是什么、能被什么样的查询命中。
- 值(Value):每个词真正携带的内容信息,最终被汇总的就是它。
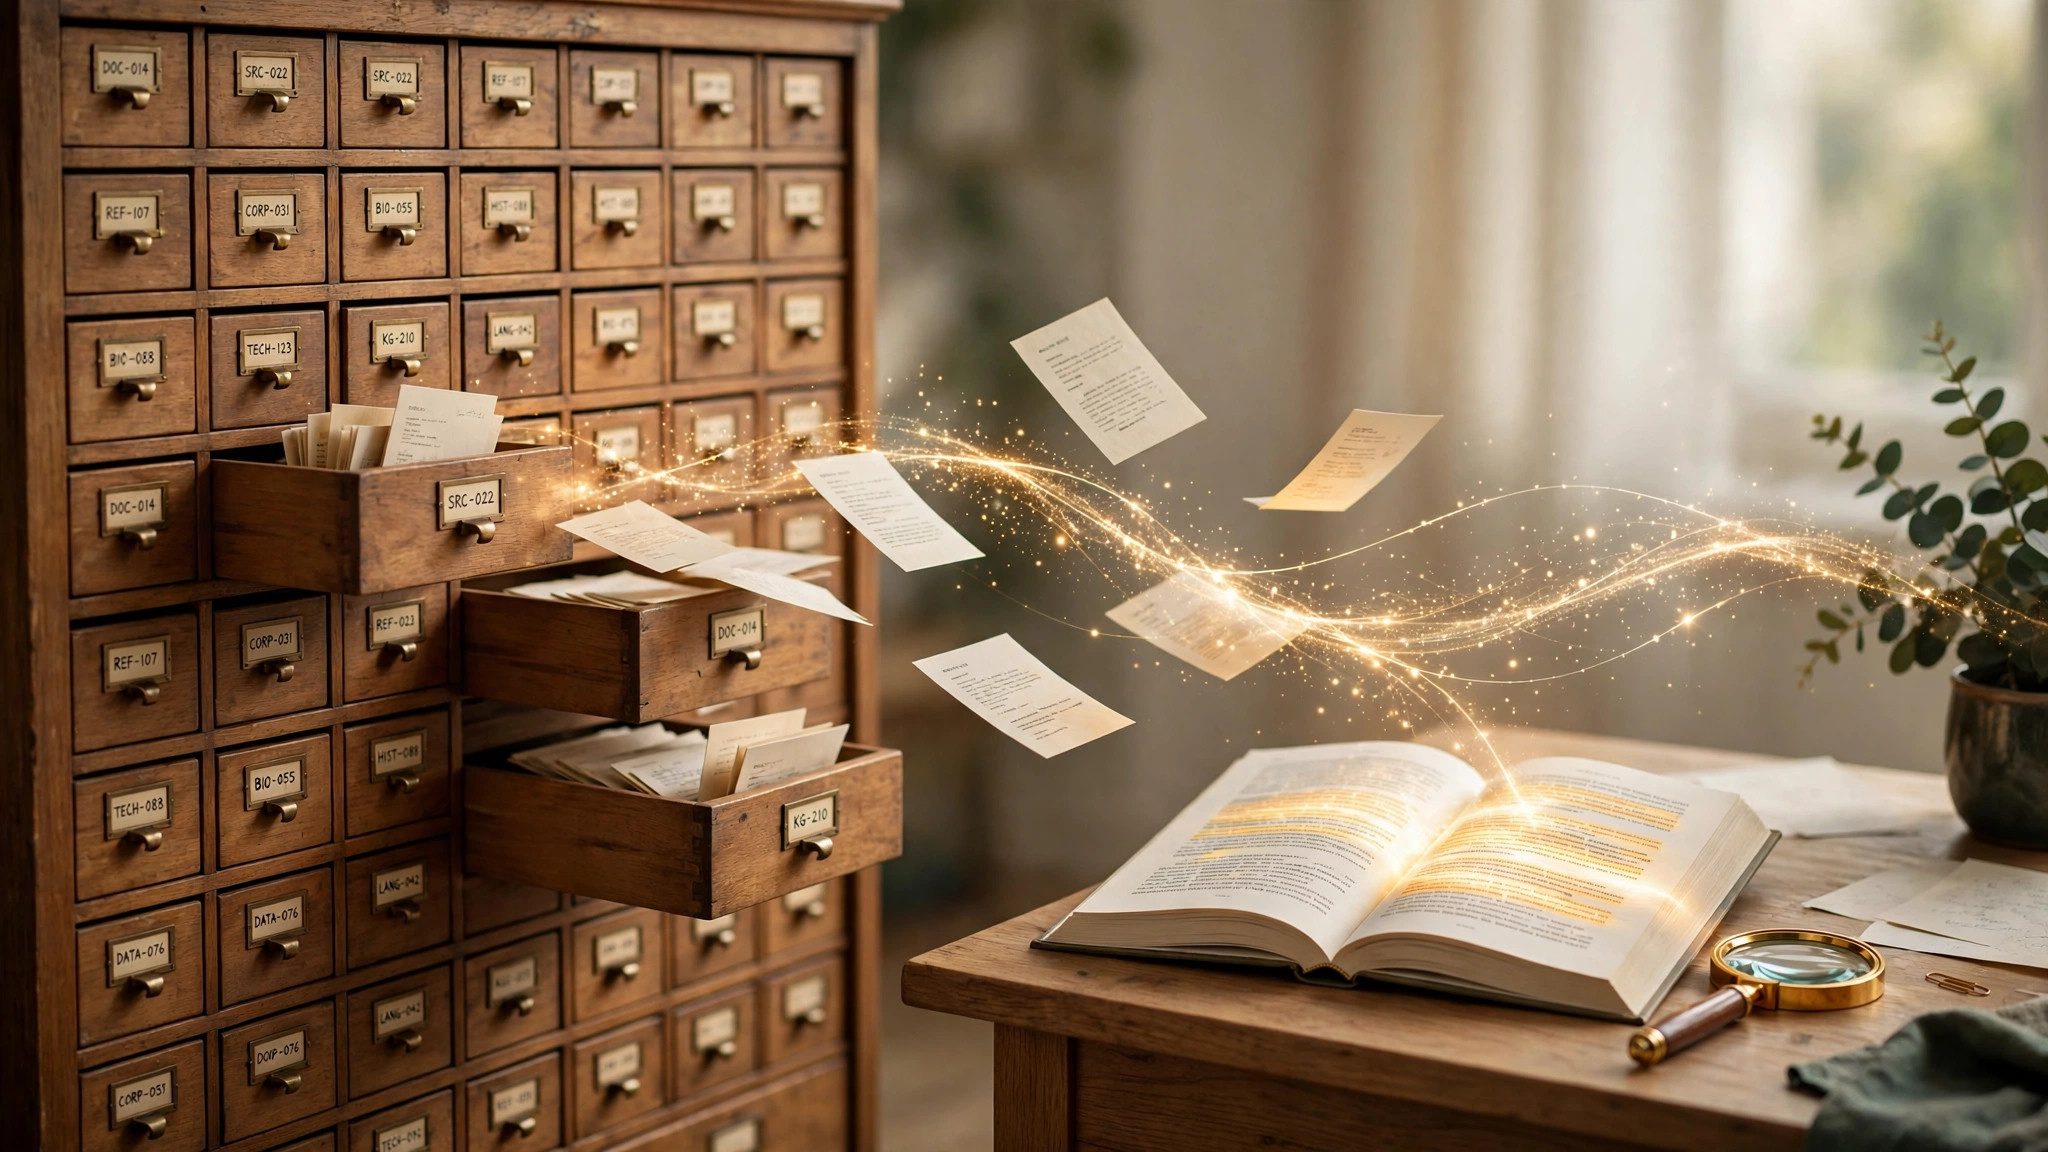
计算分三步:先用当前词的查询和每个词的键算匹配分,匹配越好分越高;再把分数换算成加起来等于 1 的权重;最后按权重把所有词的值加权平均,得到当前词融合了上下文的新表示。图书馆里按书名找书是类似的过程:查询是你的需求,键是书脊上的标题,值是书里的正文。只不过在模型里,这套动作对每个词同时进行,一层网络里要重复很多遍。
多头注意力:同时从几个角度看同一句话
实际模型不会只算一套注意力,而是并行算多套,叫多头注意力。每个头关注的角度不同:有的头盯着指代关系,负责把“它”连回小狗;有的头盯着句法搭配,比如动词和宾语;有的头盯着位置远近。多套结果拼在一起,模型对一句话的理解就比单一视角完整。这也是为什么砍掉某些头模型表现只略微下降、砍得多了才明显变差——不同头之间有分工,也有冗余。
它和相近概念的边界在哪
注意力机制最容易和“记忆”混为一谈,其实两者分工不同。上下文窗口决定模型一次能把多少内容摆在桌面上,相当于桌子大小;注意力决定在这些内容里先看哪几处,相当于目光的分配方式。桌子再大,如果目光分配不准,模型照样会漏掉关键句;目光再准,内容没进上下文窗口,它也无从参考。平时说的“模型忘了前文”,多数情况是内容被挤出了上下文窗口,而不是注意力失效。
它也和早期的循环神经网络(RNN)不同。RNN 像逐字朗读,只能把前文信息压缩进一个不断更新的状态里,句子一长,前面的信息容易被冲淡;注意力则允许任意两个词直接建立联系,第一个词和第一千个词之间的关联不比相邻词弱。代价是计算方式完全不同,这一点下面单独说。
代价:文本越长,计算量涨得越快
注意力的软肋在成本。每个词都要和其余所有词两两比对,文本长度翻一倍,比对次数大约变成四倍,也就是随长度平方增长。一万词的文档和十万词的文档,差的不是十倍算力,而可能接近一百倍。这就是长上下文模型价格更高、速度更慢的根本原因之一。
工程上有一系列办法缓解:推理时把已经算过的键和值缓存下来,避免每生成一个新词就重算全场,这叫 KV 缓存;有的架构只让每个词关注附近一小段或少数关键位置,叫稀疏注意力、滑动窗口注意力;还有的从计算实现层面减少显存读写。它们都是在“看得全”和“算得起”之间找折中,没有哪种能让平方增长的本质凭空消失。选模型时看到上下文窗口标得很大,也要留意长文本下实际的速度和价格。
三个常见误解
第一,注意力不是人类那种注意力。人类会走神、会疲劳,模型的注意力只是一组算出来的权重数字,叫这个名字是因为功能上有相似之处,不代表它在“专心”或“理解”。
第二,权重高不等于模型就是因为这个词才给出答案。注意力权重能提供线索,但模型内部还有很多层计算,把权重图当成完整的决策解释,容易得出错误结论,专业研究里对此一直有争论。
第三,注意力机制本身不存储知识。模型记住的事实、语言规律都存在参数里;注意力只负责在当次输入内部调度信息。换一段全新的文字,它调度得再好,也变不出参数里没有的知识——这正是需要外挂知识库,也就是 RAG 的原因之一。
把这三点分清,再回头看各种模型介绍里“注意力升级”“注意力优化”的说法,就能判断它改的到底是目光分配的方式、成本,还是只是换了个名字。