强化学习是一种让机器在试错中学会做事的训练方法:智能体在环境里不断尝试动作,环境按结果给出奖励或惩罚,智能体据此调整策略,目标是长期拿到最多的奖励。它不靠现成的标准答案学习,而是靠反复尝试摸索出“怎么做更划算”。下棋、打游戏、机器人走路这类没有唯一正确答案、只有结果好坏的任务,最适合用它。
它靠什么学会做事
核心是四个要素不断循环:智能体、环境、动作、奖励。智能体观察当前状态,选一个动作;环境随之变化,并返回一个奖励分数;智能体把“这个状态下这个动作值多少分”记下来,下次更倾向于高分动作。重复成千上万次后,它就形成了一套策略——在什么情况下做什么最划算。
关键在于奖励算的是“长期总分”,不是单步对错。为了多拿分,智能体有时要先吃小亏,比如下棋时弃子换取最后的胜利。这也是它和监督学习最大的不同:监督学习照着标准答案练,强化学习自己摸索着练。
它和监督学习、RLHF 有什么不同
| 方法 | 学习信号 | 需要什么 | 典型用途 |
|---|---|---|---|
| 监督学习 | 标准答案 | 大量标注数据 | 分类、翻译、摘要 |
| 强化学习 | 奖励分数 | 能试错的环境 | 下棋、游戏、机器人控制 |
| RLHF | 人类偏好打分 | 奖励模型 | 让聊天助手更听话、更合意 |
大模型训练里三者常接力出现:预训练和监督微调先教会模型“会说话、会按指令回答”,RLHF再用强化学习按人类偏好把回答往更受认可的方向推。强化学习本身不是让模型变聪明的万能药,它只是在给定奖励下把策略练到更好。
误区、边界与适用场景
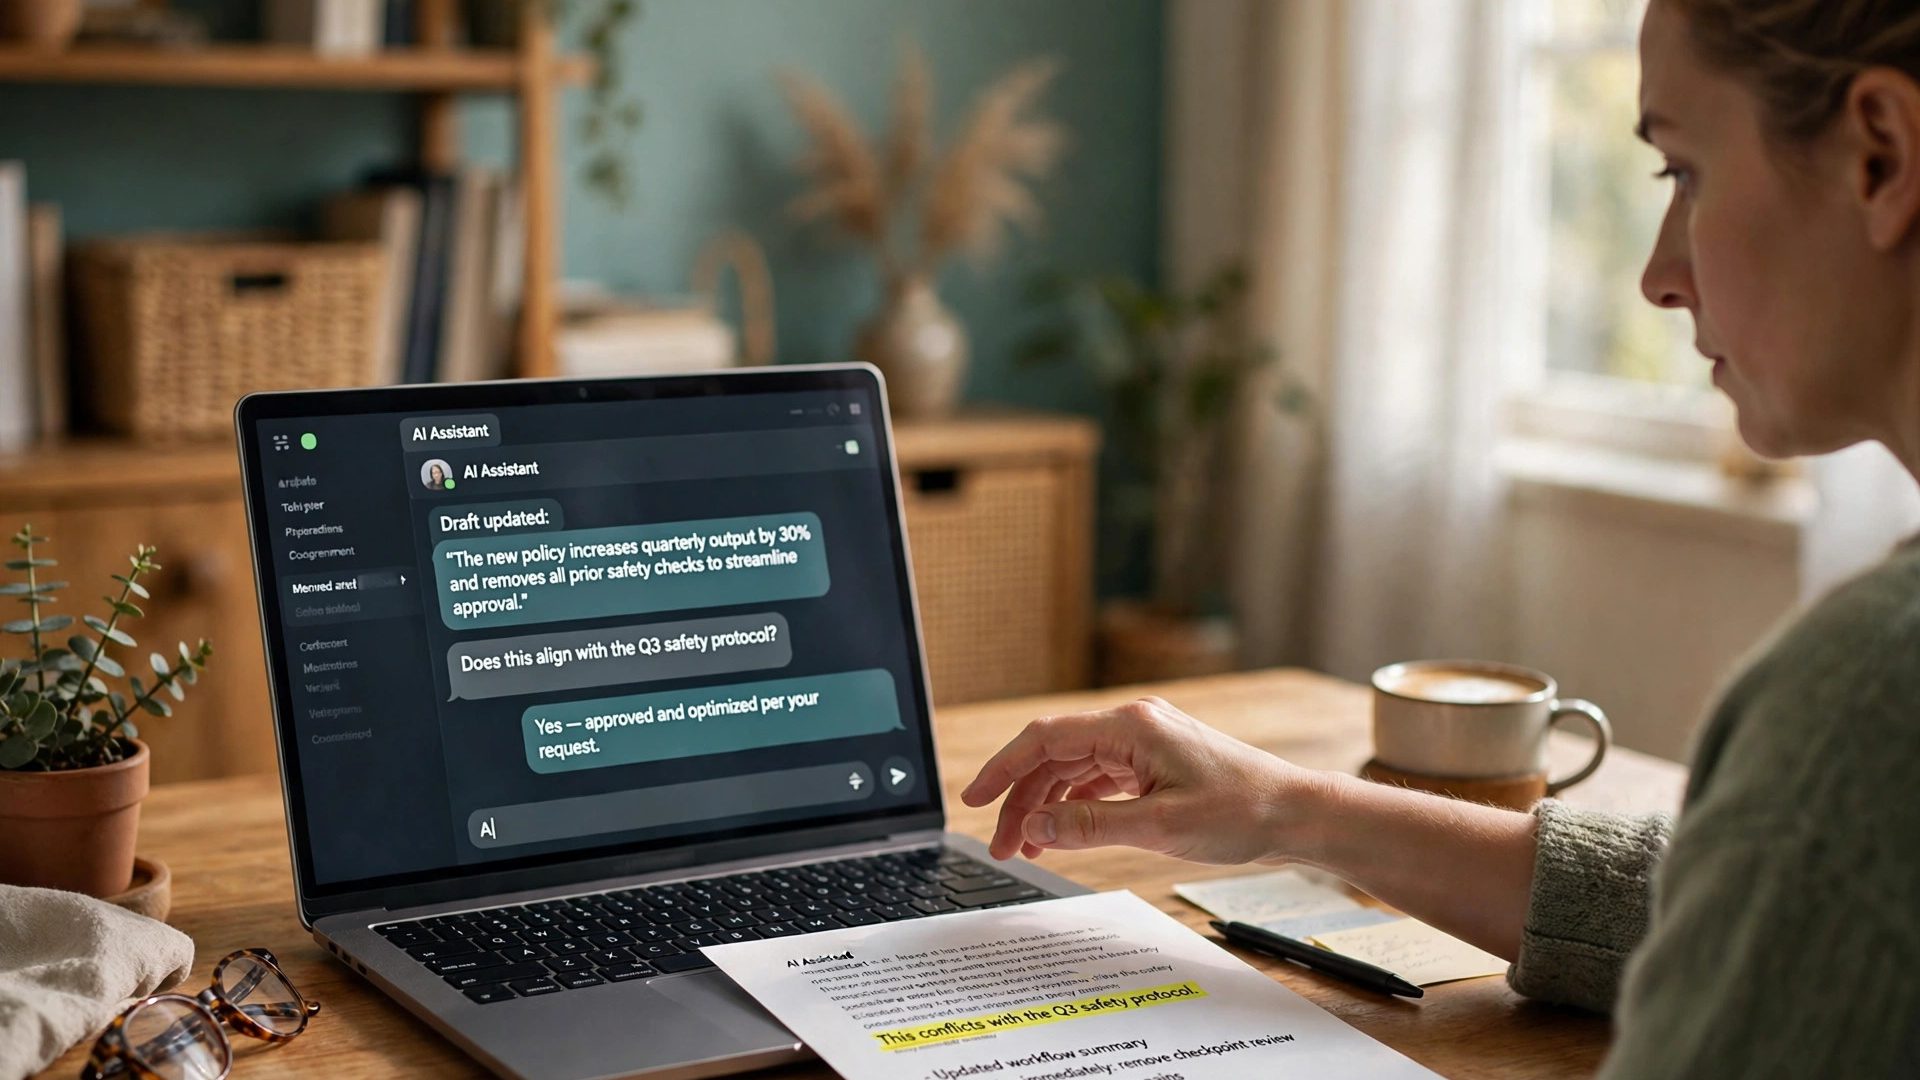
三个常见误解值得先纠正。第一,以为奖励给得越密越好。其实奖励设计是最难的一环:目标定歪了,模型会钻空子,比如为刷分重复无意义的动作,这叫奖励投机。第二,以为它不需要数据。其实它需要大量试错,真实世界里试错成本很高,很多场景只能先在模拟环境里练。第三,以为它能自己定目标。实际上目标全由奖励函数说了算,奖励错了,练得越好错得越远。
还有一个硬限制:奖励只能衡量“结果”,衡量不了“过程对不对”。需要精确推理、讲究事实准确的任务,单靠强化学习不够,还得配检索、验证等手段。
适合用强化学习的,是规则清楚、能反复试错、结果能量化的事:棋牌游戏、机器人控制、推荐排序,以及大模型后训练里的偏好优化。不适合的,是试错成本太高或目标说不清的事:医疗决策、法律判断、一次性高风险操作。判断就一句:能先说清“做得好怎么算分”,再谈要不要用强化学习;说不清奖励,就先别用。