RAG(检索增强生成)是一种让大模型先查资料、再开口回答的技术:用户提问后,系统先从外部知识库里找出最相关的几段文字,把它们连同问题一起交给大模型,大模型再依据这些资料组织答案。它不改动模型参数,只给模型临时补课,回答因此能用上训练截止日期之后的新知识、私有文档和实时数据。
RAG 是怎么把资料塞进回答里的
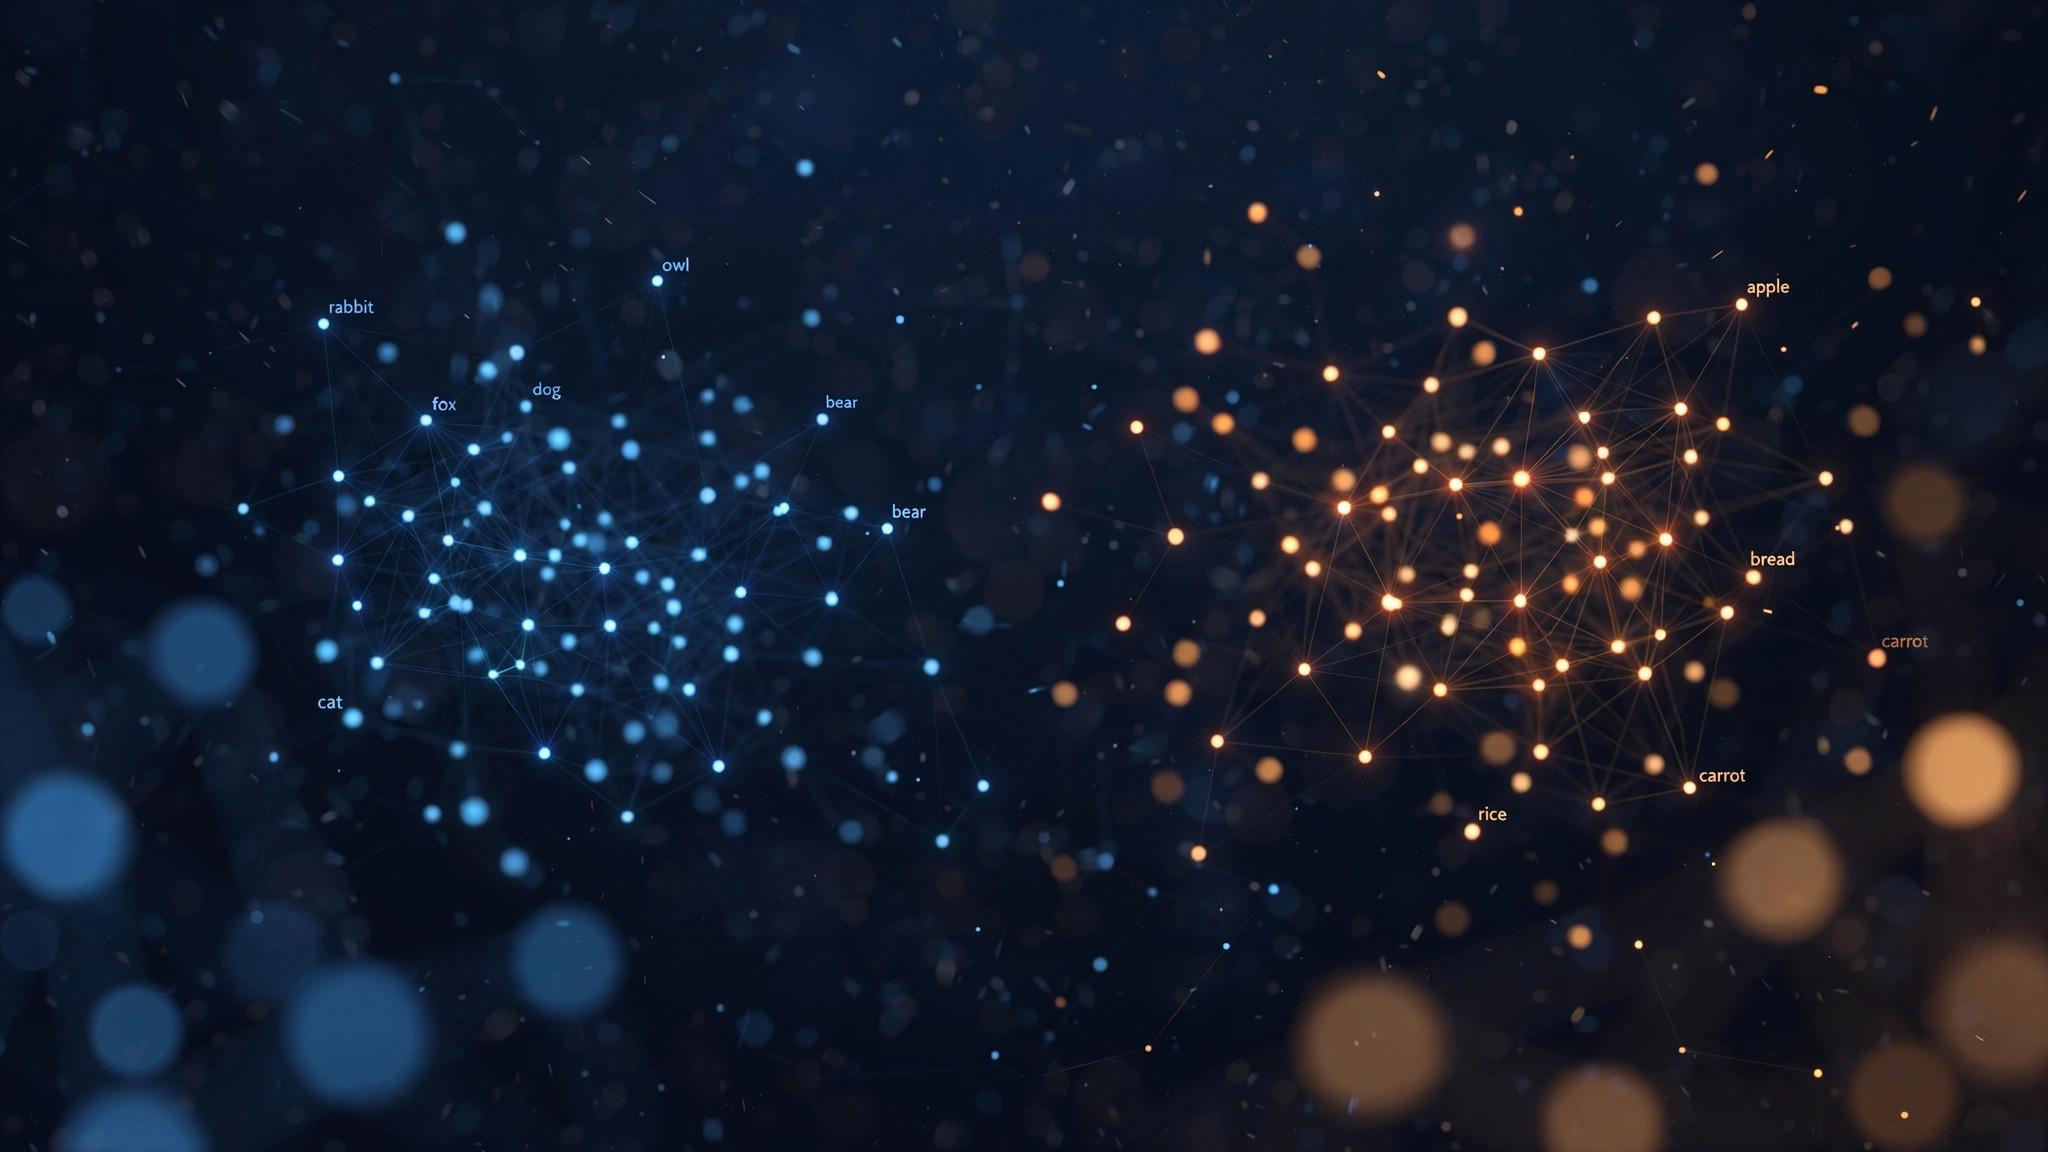
流程分两步走。第一步是离线准备:把文档切成几百字一段的小块,用向量嵌入模型转成数字坐标,存进向量数据库,每段都保留原文出处。第二步是实时检索:用户提问也被转成向量,系统在库里找出语义最接近的几段,按相似度排序后拼进提示词,大模型照着这些材料作答,并能标出答案来自哪段原文。检索质量决定成败:切块太粗会混进无关内容,太细又会丢掉上下文。
RAG 和微调、直接提问有什么区别
直接提问只靠模型训练时记住的知识,遇到训练后才出现的事就容易编造;RAG 把答案的依据摆在眼前,幻觉明显减少,资料更新也不用重新训练。微调是把知识写进模型参数,适合改说话风格、学固定格式,但成本高、更新慢,知识一变就得重练;RAG 换资料只要更新知识库,适合知识常变、讲究出处的场景。两者也能叠加:先微调定风格,再用 RAG 供事实。
用 RAG 常踩的三个坑
一是以为接了知识库就万无一失:检索到的材料如果过时、矛盾或本身就是错的,模型会照着错答案说,查资料只能降低幻觉,不能根除。二是资料切块和嵌入模型没调好,问法稍换就搜不到关键段,答案看着通顺却答非所问。三是把 RAG 当成万能方案:问题不需要外部知识时,硬塞资料反而干扰模型,简单问题直接问更快更准。
最适合 RAG 的地方是企业内部问答、客服知识库、法规与产品文档查询:资料明确、出处重要、内容常更新。它也常和AI Agent搭配:智能体遇到不懂的问题先检索,再决定下一步动作。写小说、做头脑风暴、聊开放话题时不需要它。动手之前先准备好干净的资料源,资料本身混乱,再好的检索也救不回来。