自监督学习是一种不用人工标注、直接从原始数据本身找规律的训练方法。做法是把数据的一部分藏起来,让模型去猜被藏的内容,再拿真实部分当答案纠错。语言模型遮住词再预测下一个词,就是这种思路。它之所以重要,是因为网上有取之不尽的文本、图片和视频,却没有那么多人工标注,靠它,模型才能先大规模学,再用到具体任务上。
自监督学习靠什么给自己出题
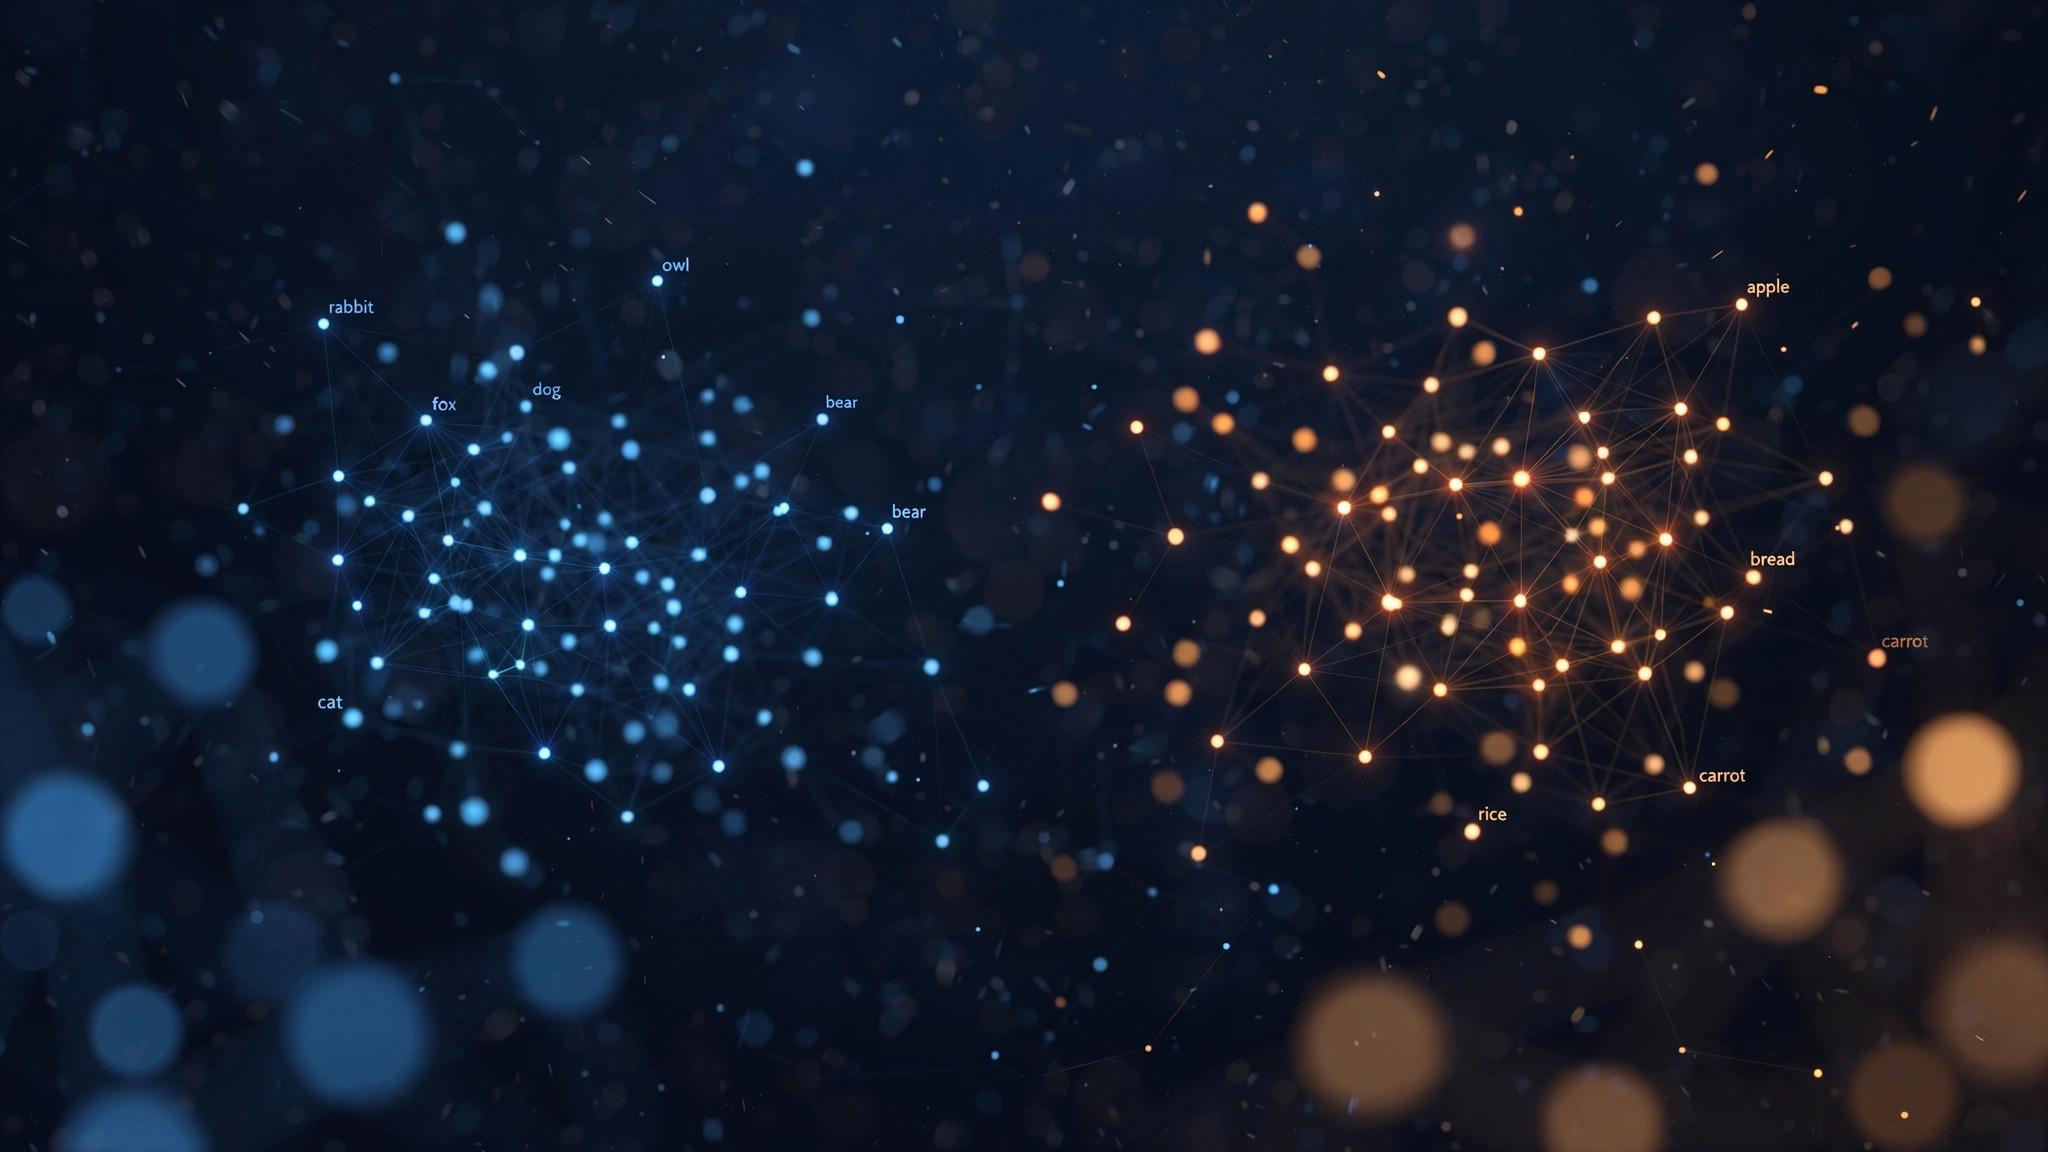
自监督学习的关键,是把“答案”藏进数据里,而不是等人来写。最常见的出题方式有两种。第一种是预测式:遮住文本里的词让模型按上下文填空,或只给前半句让模型逐词预测后半句,今天主流语言模型的预训练大多走这条路,猜词让模型学会语法、搭配和一部分常识。第二种是对比式:把同一张图片裁剪、变色后当成一对,让模型认出它们来自同一来源、推开不相关的样本,由此学会区分形状与物体。两种方式都不需要人工给标签,监督信号来自数据自身的结构,误差可以直接算出,模型靠一次次纠错调整参数。
自监督学习和监督学习、无监督学习有什么不同
三者的差别不在“有没有学习”,而在答案从哪来。监督学习由人先给答案,模型学的是输入到标签的映射,比如拿标好正负面的评论教模型做情感判断;它准,但标注贵、规模受限。自监督学习的答案由数据自己提供,模型学的是通用的表示和规律,学完能迁移到很多任务。无监督学习没有明确答案和预测目标,主要任务是发现数据结构,比如把用户分组、把相似文档聚到一起。自监督常被划进无监督的大类,但它有明确的预测目标和可计算的误差,更像自己给自己出题。分清这点,就不会把“不用标注”等同于“没有目标”。
自监督学习的三个常见误解
第一个误解,是以为它不需要数据和算力。事实正相反:它吃海量未标注数据,仍要消耗大量算力,数据质量差,模型就会学到偏见和错误的关联。第二个误解,是以为预训练完就什么都会。预训练学到的是通用表示和语言规律,要稳定完成具体任务,往往还要经过监督微调或对齐,模型也不知道训练截止后的事。第三个误解,是把它说成完全自主的学习。训练目标、数据选择和评估方式都是人定的,模型只是在人划定的题目里自己找答案。
判断一个任务适不适合用自监督学习,看两点就够了:有没有大量未标注的同类数据,以及目标是不是先学通用能力再迁移。语言、图像、语音预训练都符合。反过来,标签明确、少量样本就能解决的任务,直接做监督学习更省事;需要精确事实和实时信息的场景,预训练也给不了保证,还得靠检索或人工核对。