
多模态AI
能同时看懂文字、语音、图像和视频的 AI,正在把通用助手从概念变成现实。看多模态模型的发布、能力评测与应用场景。
专题介绍
只会聊天的 AI 已经不够看了——真正的通用助手要能看图、听声、理解视频。多模态就是这条路:各家旗舰模型都在向全模态演进。内容包括多模态大模型的发布动态、跨模态能力对比与真实应用场景,帮你看懂 AI 是如何打通多种感官的。
豆包工作上线无限画布:2.1 Lite 和新图片模型一起接入
AI资讯 AI导航 27 次阅读
Odyssey-3 世界模型发布:一个模型同时演示六个领域,含机器人与自动驾驶
AI资讯 AI导航 29 次阅读
Perplexity 开源 pplx-embed-v2-late:图文共用一个检索空间
AI资讯 AI导航 28 次阅读
Mistral 发布 Large 4 公开预览:万亿参数多模态模型月底开放权重
AI资讯 AI导航 20 次阅读
Reka 发布 Rho-1 全模态模型:一个网络同时生成视频并控制机器人
AI资讯 AI导航 21 次阅读
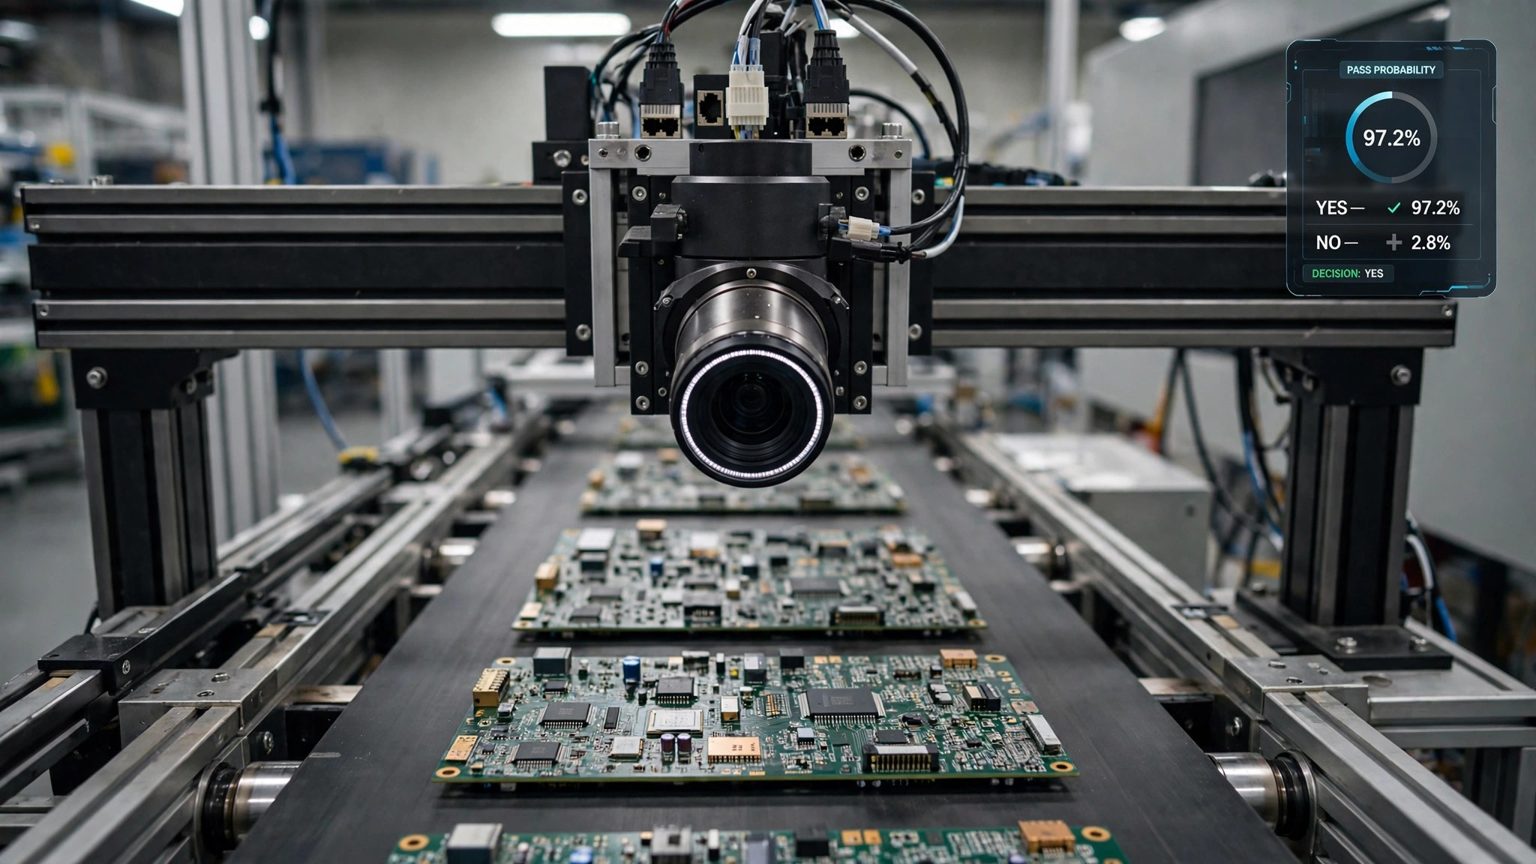
Liquid AI 发布首款决策模型 d1:不写字,只给概率,还能看图判断
AI资讯 AI导航 38 次阅读
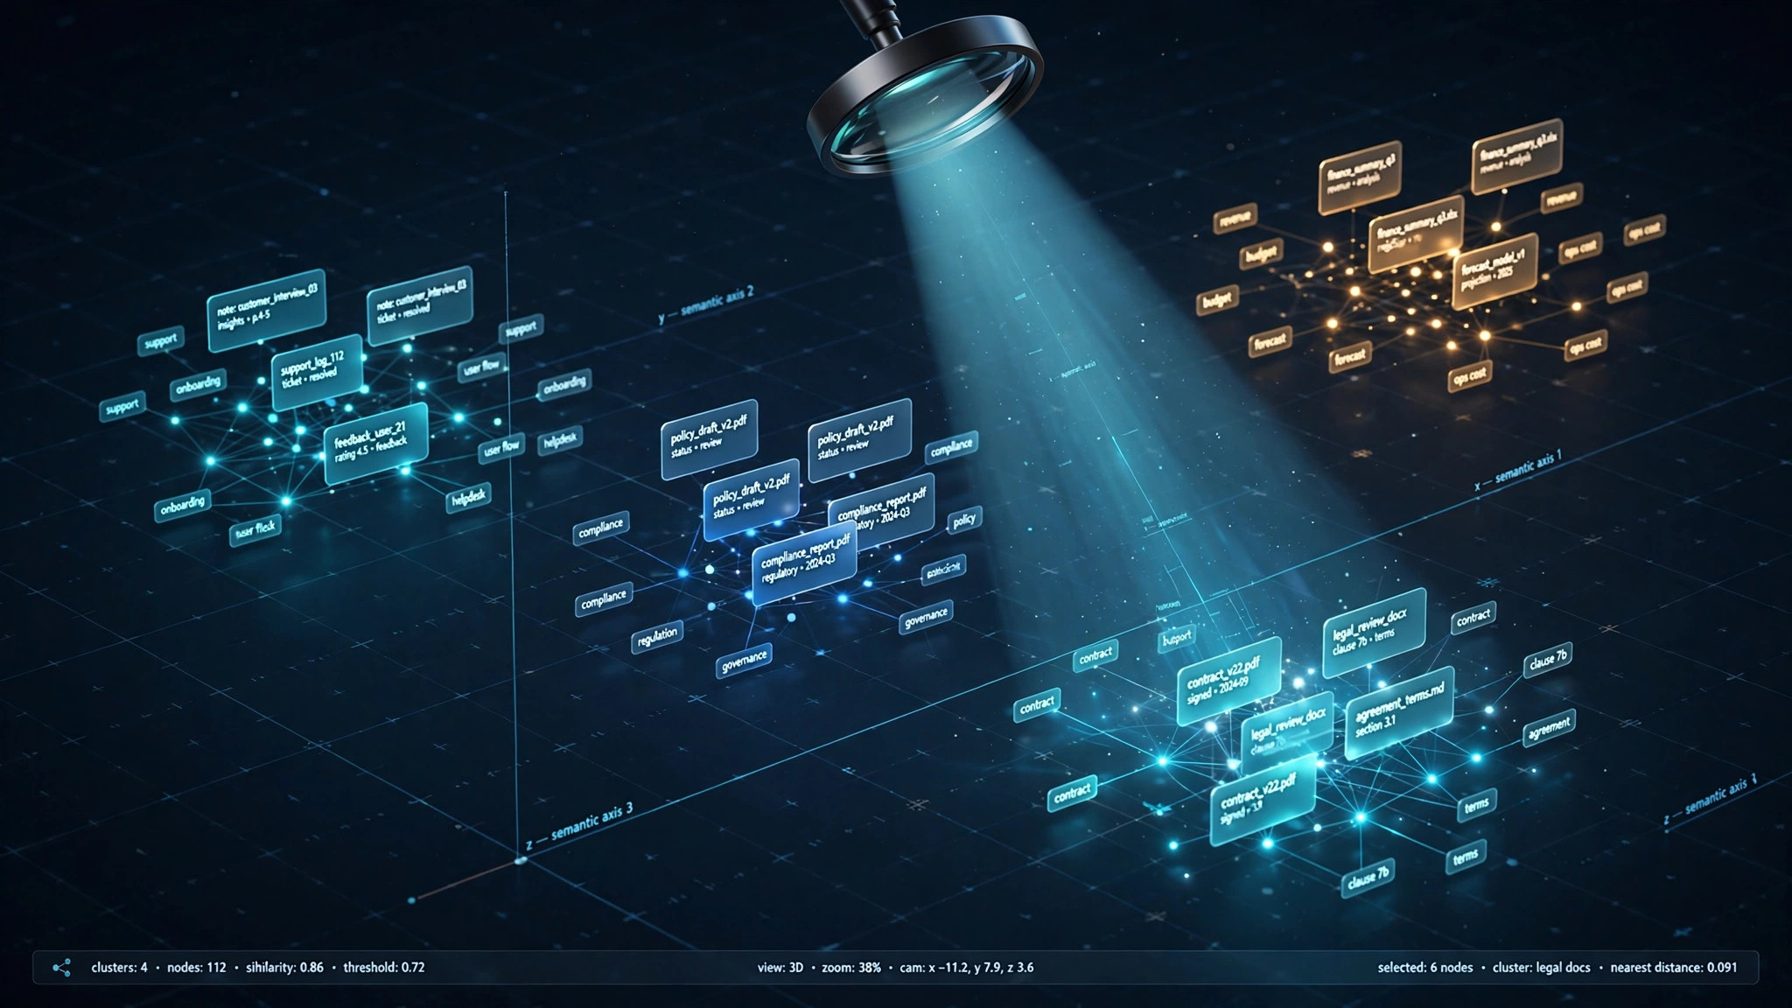
向量嵌入是什么?文字变成坐标后机器如何理解语义
AI百科 AI导航 17 次阅读
FLUX 3 Image 正式发布:局部编辑只动指定区域,4K 输出与十张参考图到位
AI资讯 AI导航 28 次阅读