Liquid AI 在 2026 年 10 月 5 日通过官方博客发布 d1,这是它的首款决策模型,现已同时支持文本和图像输入,可在 Liquid AI 控制台和 d1 Playground 中试用。d1 要抢的不是聊天市场,而是一类被聊天式大模型高价低速干着的活:给一个情境,回答一个判断问题,然后结束。
一次前向计算,不生成任何 token
决策模型的输入是非结构化数据加一个或多个问题,可以是文字、图片或两者都有;模型读一遍就直接返回每个答案的概率,不再逐字生成回答。问题分三种形态:是否类问题给出 0 到 1 之间的概率,多选类问题给每个标签一个概率,量表类问题按等级加权给分。官方称一次文本判断耗时 200 到 300 毫秒,计费也只按输入 token 算,价格为每百万输入 token 0.04 美元,图片按同样费率折算。
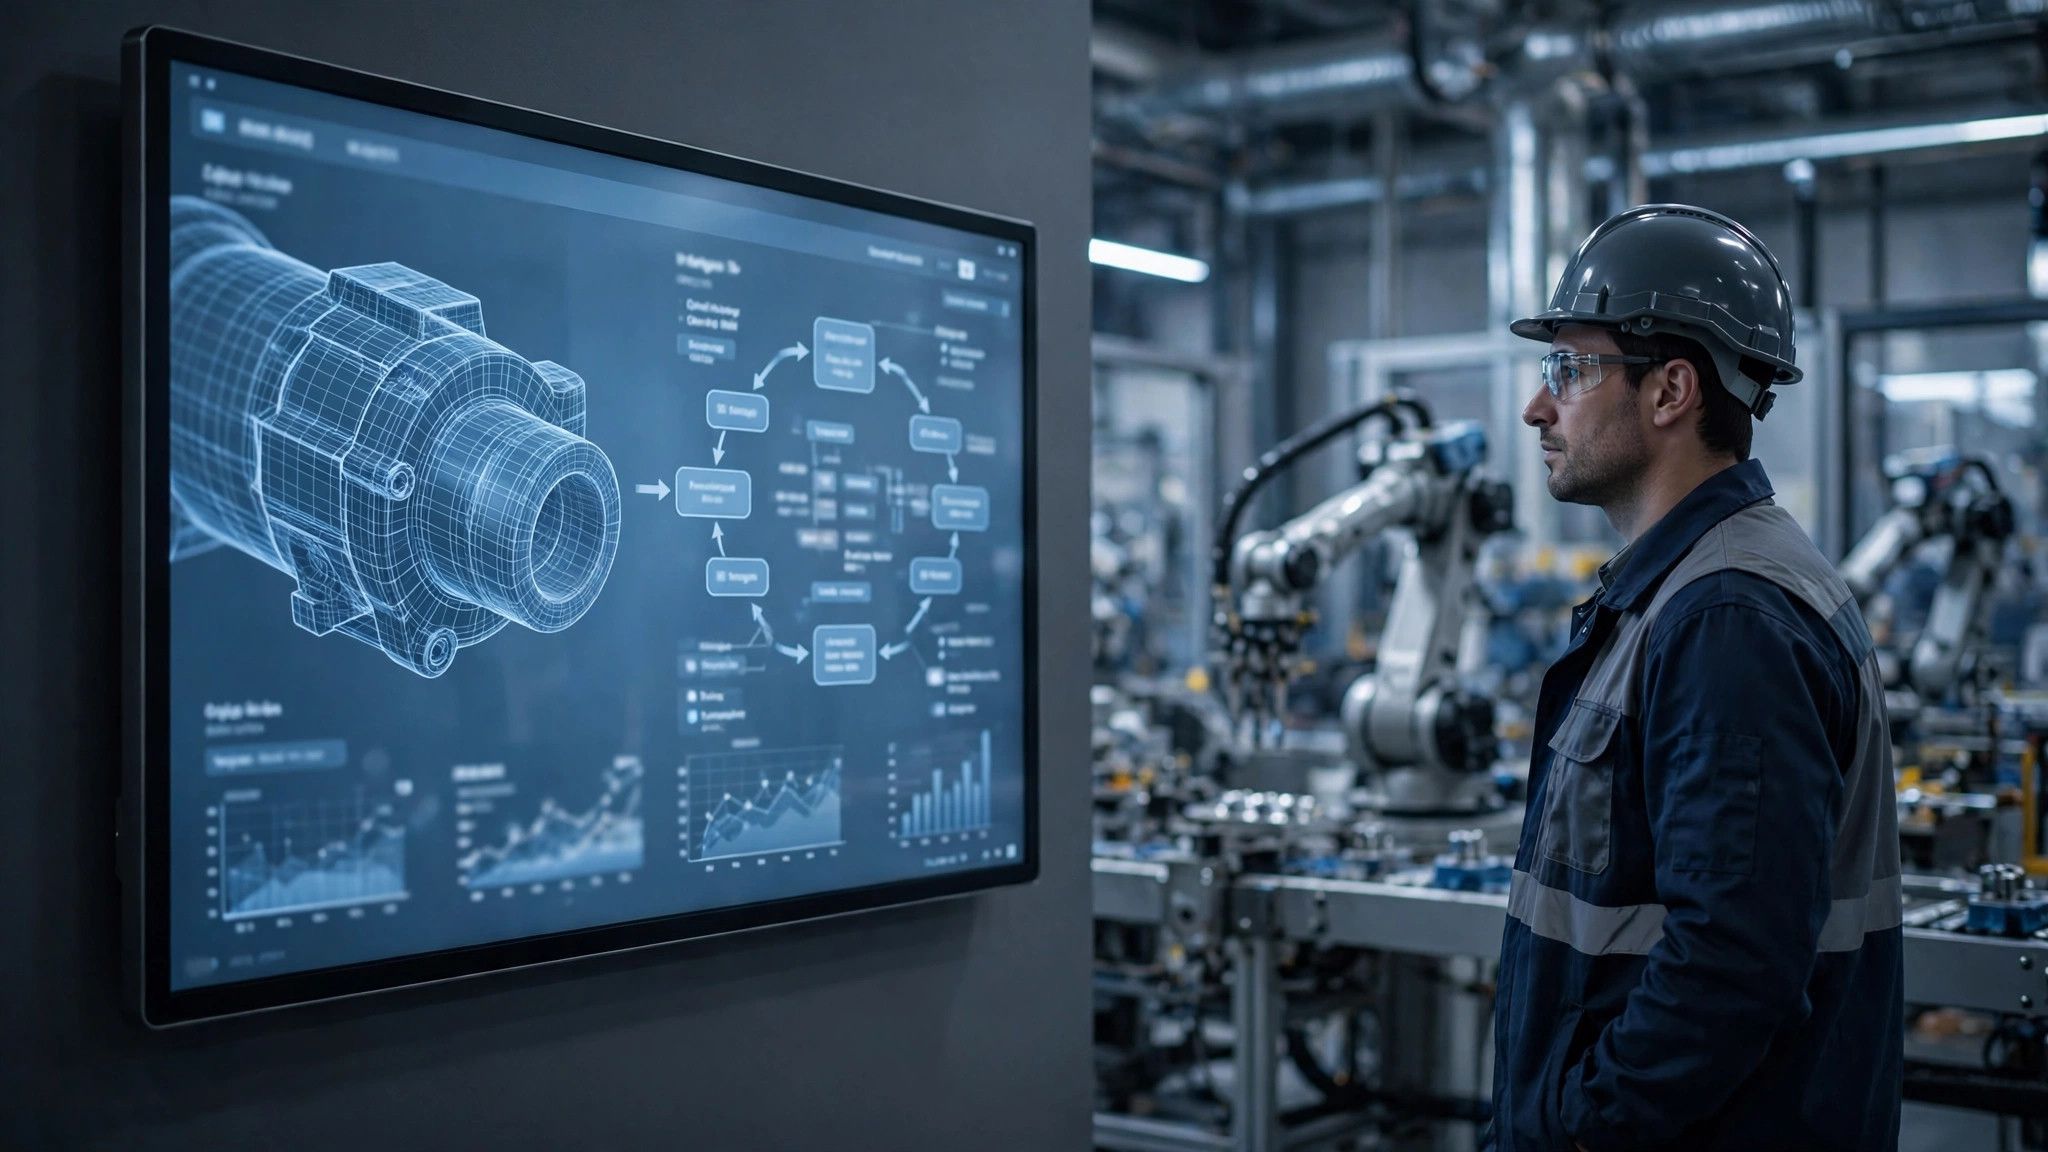
质检是它最直观的演示
官方演示里,d1 看着产线摄像头的画面区分电路板、蜡烛、腰果和口香糖的好坏,准确率在 85% 到 97% 之间,而且它从未针对这个任务训练过,靠的是一句任务说明带来的泛化能力。文本侧的演示包括在 SQL 查询里筛选客服工单、逐层翻代码仓库找函数,以及替编程智能体判断哪些工具输出该保留、哪些可以丢弃,后者演示中砍掉了 52% 的 token 还没漏掉任务需要的内容。
便宜 19 到 200 倍,先按厂商口径看
Liquid AI 给出的对比是:在六个真实应用任务上,d1 在其中四个上追平或超过 GPT-6.1 Sol,成本低 19 到 200 倍且每个任务都更快。但这组数字需要打折看:它是厂商自己在 2026 年 10 月 5 日用对比脚本每个任务只跑一轮得出的,对照模型按标价计算,未计提示缓存折扣。d1 的边界也很清楚,它只做判断,不生成解释、不写方案,需要理由链的场合仍得靠大模型。它目前还可通过 Vercel 和 OpenRouter 使用,但暂时只有文本,视觉随后跟上;官方称后续模型计划在 Hugging Face 放出开放权重。手上有大量筛选、分类、打分类调用的团队,值得先拿自己的样本做一轮对照实测再决定。