基座模型(Foundation Model,也常叫基础模型)是在大规模通用数据上预训练出来的通用模型:它先学会语言、图像或声音里可迁移的通用规律,而不是只学会某一个任务的做法。训练完成后,它本身还不是一个可以直接上线的产品,而是一块“底座”——后续可以微调、对齐、接工具或配检索,变成聊天助手、编程工具、客服系统或行业模型。看懂这个定位,就能分清很多名字相近的概念。
这个词来自斯坦福大学 2021 年的一篇研究报告,研究者用它概括一类新现象:同一个大规模预训练模型,经过不同适配后能支撑成百上千个下游应用。重点不在某个具体架构,而在“通用底座 + 多种适配”的分工。Transformer 是常见的架构,预训练是做出底座的训练阶段,基座模型则是对这块底座的角色命名。
它描述的是角色,不是训练阶段
同样一个模型,在不同语境下名字会变:刚预训练完,它是预训练模型;拿它当底座去做产品,它就是基座模型;经过指令训练上线后,用户面对的是指令模型。名字变了,参数底子可能没变,变的是训练阶段和用途。
| 叫法 | 它指什么 | 如何区分 |
|---|---|---|
| 预训练后的模型 | 只完成预训练、还没学过按指令回答的模型 | 会续写,不一定会好好回答 |
| 基座模型 | 上面这类通用模型作为可复用底座时的角色 | 强调“能被改造成很多产品” |
| 指令模型 | 经过监督微调和对齐、学会按指令回答的模型 | 日常对话用的大多是它 |
| 推理模型 | 专门为多步推理训练、回答前先长思考的模型 | 难题更强,也更慢更贵 |
| 专用模型 | 只为某个任务或领域训练、优化的模型 | 范围窄,边界内可能更划算 |
中文里“基础模型”和“基座模型”也常混用,读到时先看上下文:说的是底座角色,还是仅指完成预训练的原始模型。两个意思都出现过,靠上下文分辨比争名字更重要。
靠什么做到“一底多用”
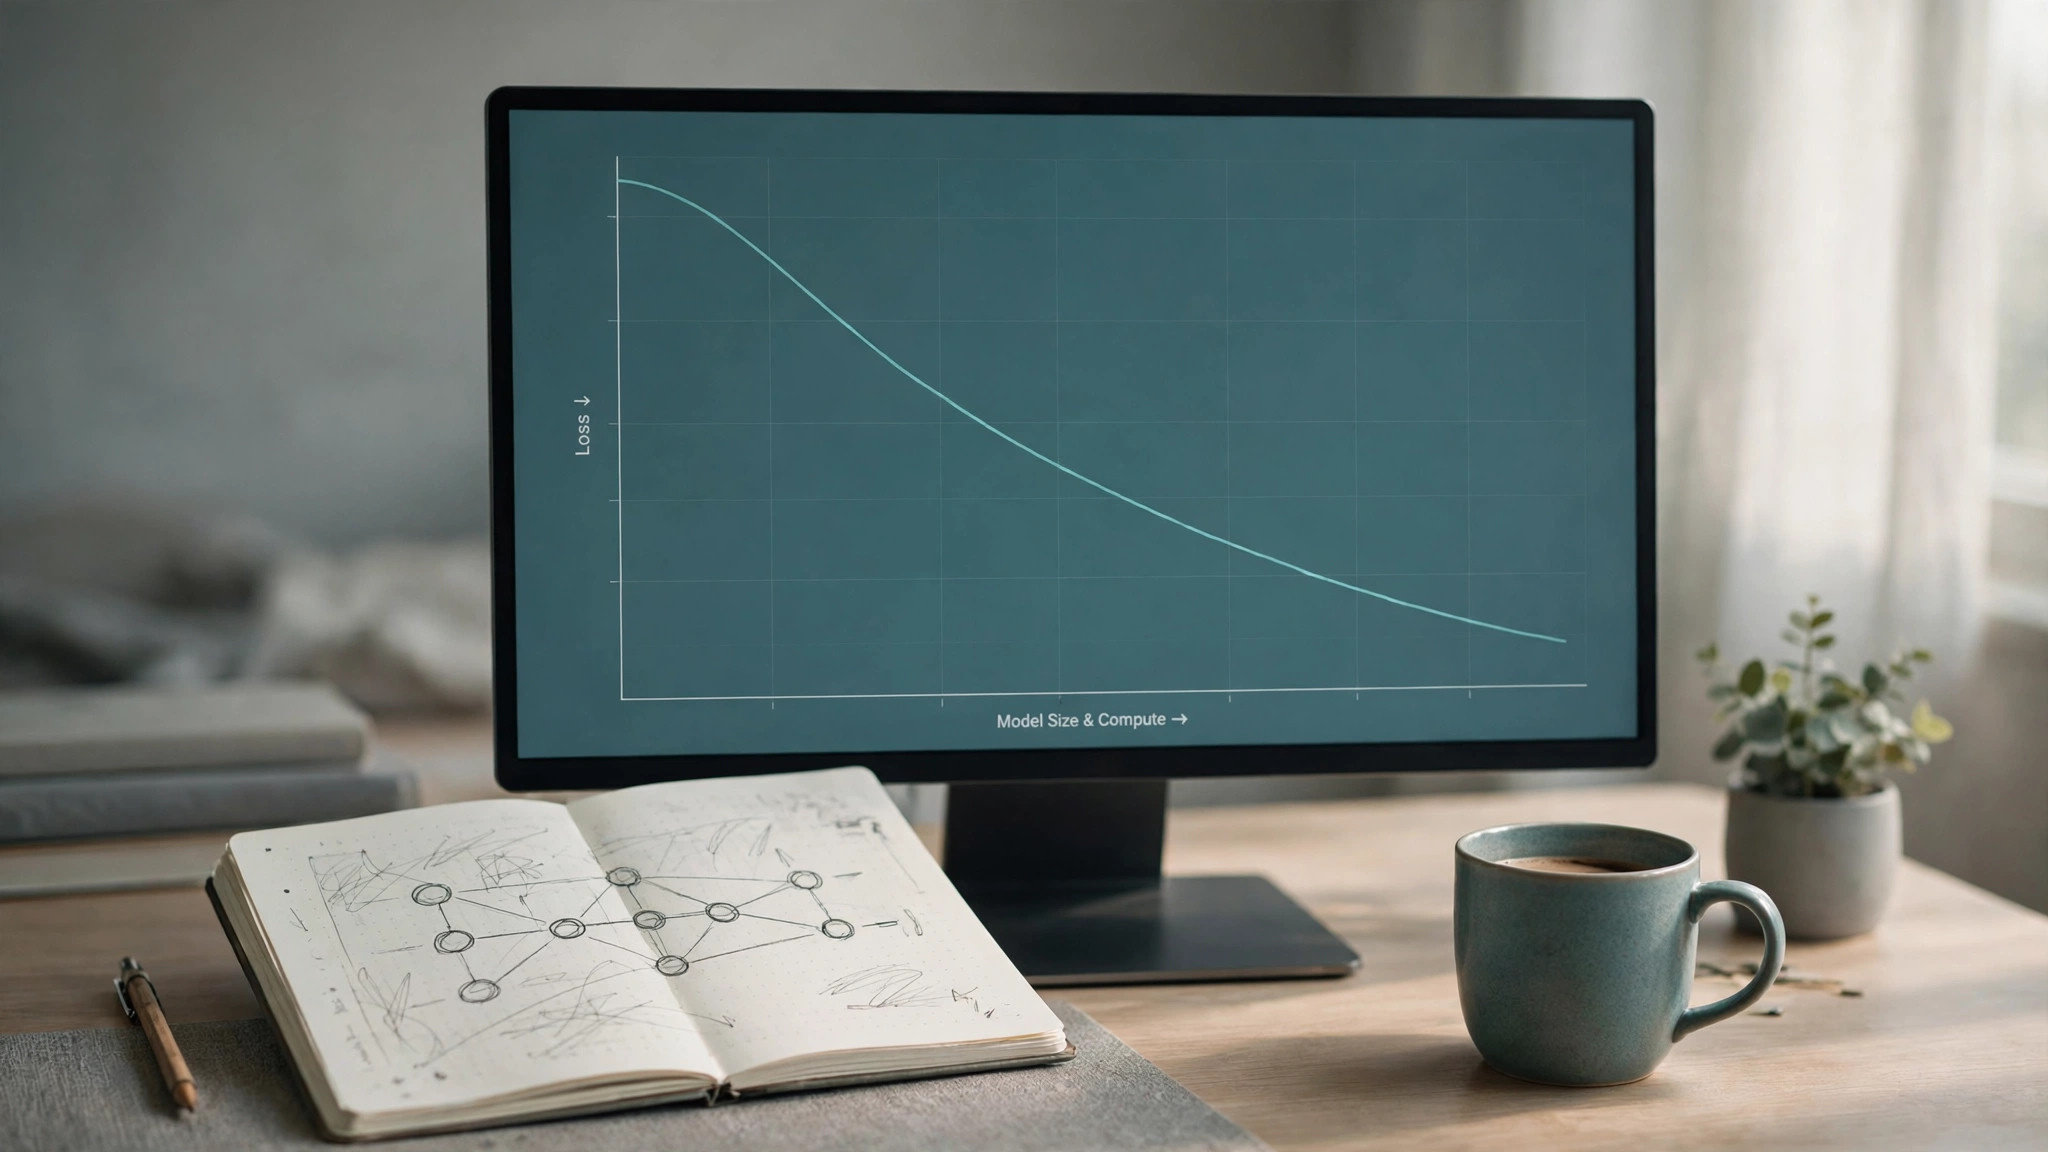
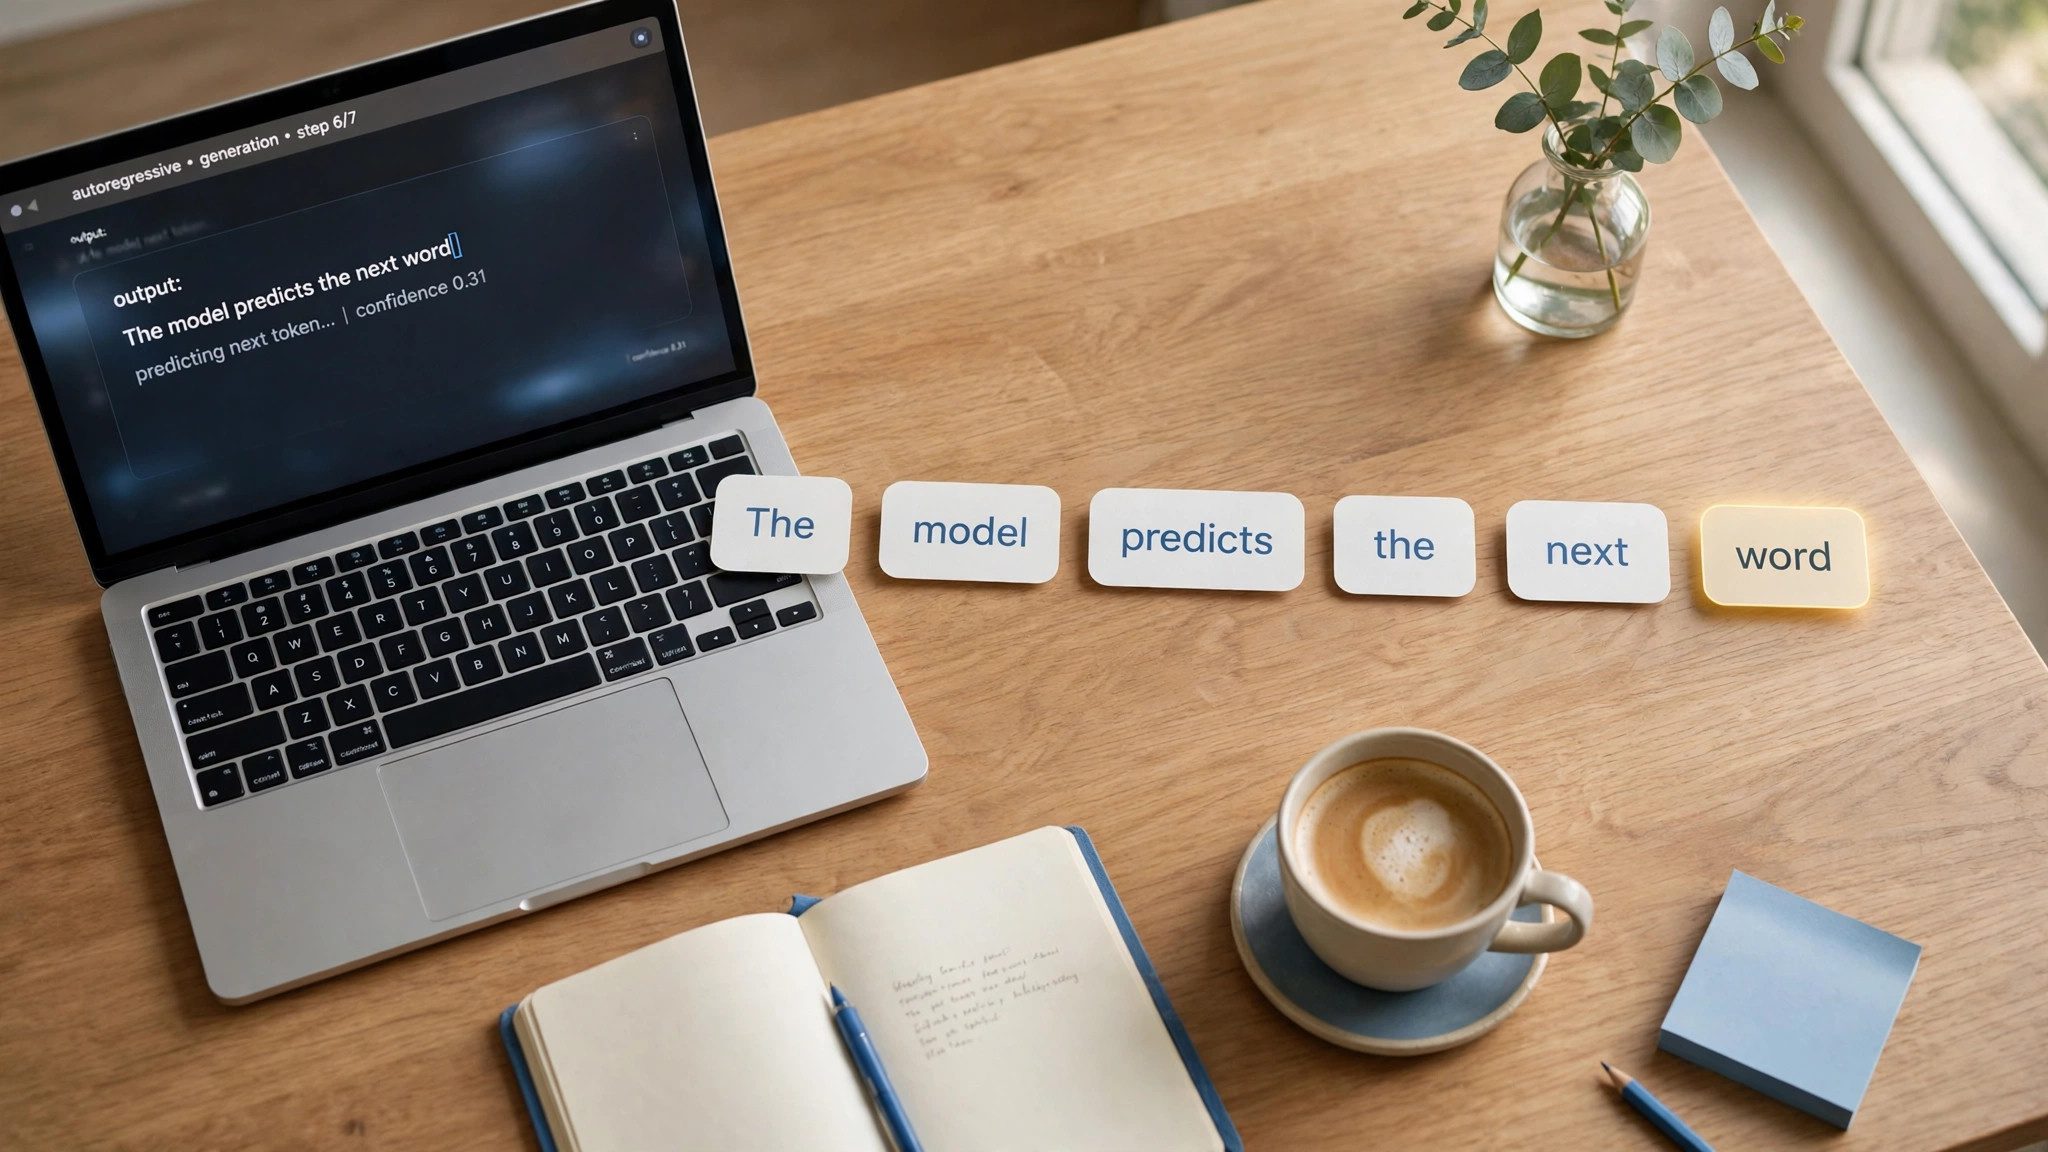
底座的通用性主要来自三点。第一是数据广:训练数据覆盖文本、代码、图像等多种来源,模型学到的是通用模式,而不是某个任务的固定答案。第二是规模:参数、数据和算力一起上去后,模型能记住更多模式、处理更长的依赖,这是规模定律描述的经验规律。第三是训练目标通用:预测下一个词、还原被遮住的内容这类自监督目标,不需要人工为每个任务逐条标注,模型可以从海量数据里自己提炼规律。
这种通用性是“可能性”,不是保证。底座知道很多事的表面形态,但不等于它在你的领域里答得准、守得住规则。预训练数据有截止时间,专业知识、内部数据、私有流程都不在里面;直接拿底座当客服或问诊助手,等于把没上岗培训的人直接派去一线。适配的意义,就是把通用能力收窄、校准到具体任务上。
同一个语言底座,配上医疗问答数据微调可以变成问诊辅助,配上代码数据可以变成编程助手,配上检索可以回答公司内部文档。底座相同,产品表现可以差很远,差别主要在适配数据、评测和产品约束上。
从底座到产品,还差哪几步
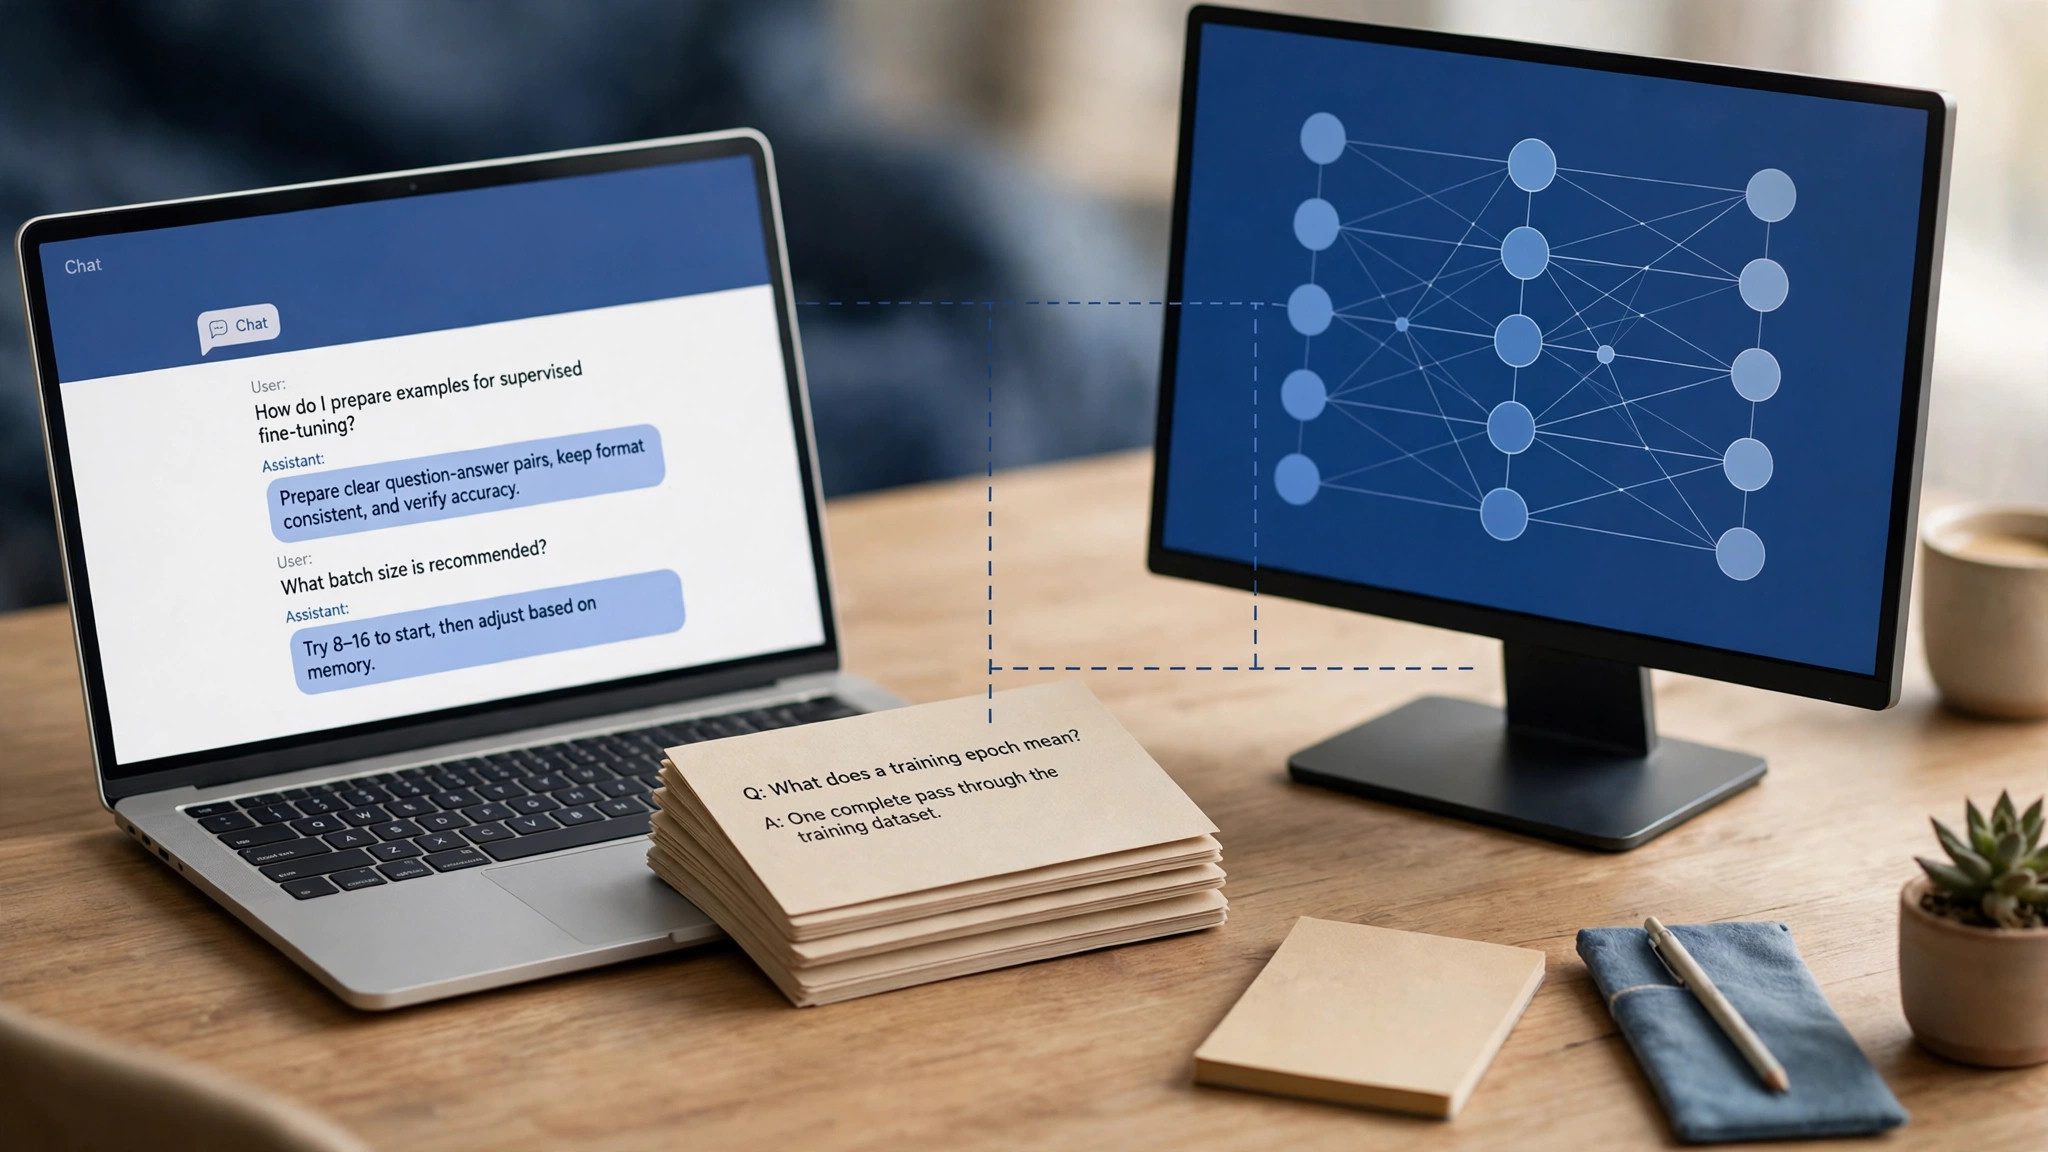
- **监督微调:**用“问题应该这样答”的示例教会它按指令回答、按格式输出。
- **对齐:**用人类反馈或偏好数据让它拒绝有害请求、减少胡编、说话方式符合预期。
- **工具与检索:**接搜索、数据库和外部工具,让它查最新信息、办事,而不是只凭记忆回答。
- **评测与护栏:**用真实任务、边界用例和安全测试验一遍,设定它不该做的事,留出人工复核口。
不是每个团队都要自己训底座。训一块通用底座成本极高,需要海量数据和算力,大多数团队的合理选择是:用现成底座或模型接口,再把精力花在数据、评测和业务流程上。只有数据极特殊、合规要求极严,或现有底座在关键任务上系统性不够用时,才值得考虑从底座开始自己训或深度改造。
三个常见误解
**误解一:基座模型就是聊天机器人。**底座更像没装方向盘的发动机,有动力,没法直接开上路。聊天机器人是底座经过指令训练、对齐、产品封装后的样子,中间每一步都会改变它的行为。
**误解二:参数越大,基座一定越好。**规模有帮助,但数据质量、数据配比、训练方法和评测同样决定上限;只看参数量选型会踩坑。更大也意味着更贵、更慢、更难部署,小底座配上好适配,在具体任务上常常更划算。
**误解三:权重公开就等于随便用、天然安全。**开放权重不等于放弃许可限制,商用、再分发、改名发布都要看许可证;公开的底座也不会自动过滤有害内容,安全责任在使用者一方的适配和护栏里。
什么时候需要关心它,什么时候不用
日常使用聊天、写作、绘图产品时,不必追问底座叫什么。看产品在你的任务上是否稳定、是否注明知识时效、出错时有没有核对路径,更实在。
做选型的团队则要多问三个问题:任务是否需要私有数据?是否必须本地部署?现有接口模型在评测里差在哪里?答清了,才知道该用接口、微调、检索增强,还是换一块底座。
基座模型的价值不在名字响亮,而在它把一次昂贵训练的成果变成可复用的起点。分清底座、指令模型和专用模型,就能在听到新模型发布时多问一句:它是哪块底座、经过了哪些适配、在什么任务上验过——这三个问题,比参数量更能帮你判断一个模型值不值得用。