推理模型是一类在输出最终答案之前,先进行较长内部"思考"的大模型:它会把复杂问题拆成多个步骤,逐一推导、反复检查,再给出结论。和普通大模型"拿到问题就直接回答"不同,推理模型追求的是"先想对,再说对"。它适合数学证明、代码调试、多步规划这类"错一步就全错"的任务;代价是回答更慢、消耗的 token 更多。如果你只是写文案、翻译、闲聊,普通模型通常更快也更便宜。
和普通大模型比,推理模型多做了什么
普通大模型的回答流程很直接:拿到问题,直接生成答案。推理模型在中间多加了一道工序——在给出最终答案之前,先生成一段很长的内部思考过程(thinking / reasoning trace)。在这段思考里,它会拆解问题、尝试不同的解法、发现错误后回溯、交叉验证,最后才输出结论。
这段内部思考通常比最终答案长得多,可能是几倍甚至几十倍。你在使用这类产品时看到的"思考中…",本质上就是模型在烧 token 做推导。
打个比方:普通大模型像即兴演讲,拿到话题就开始讲;推理模型像先在草稿纸上演算、验算几遍,确认无误再交卷。前者胜在快,后者胜在准——前提是问题真的需要"演算"。
它是靠什么学会"思考"的
推理能力不是凭空出现的,主要靠三件事:
第一,思维链训练数据。把"问题 + 完整推理步骤 + 答案"这样的样本大量喂给模型,让它学会先写步骤再给结论,而不是跳步。
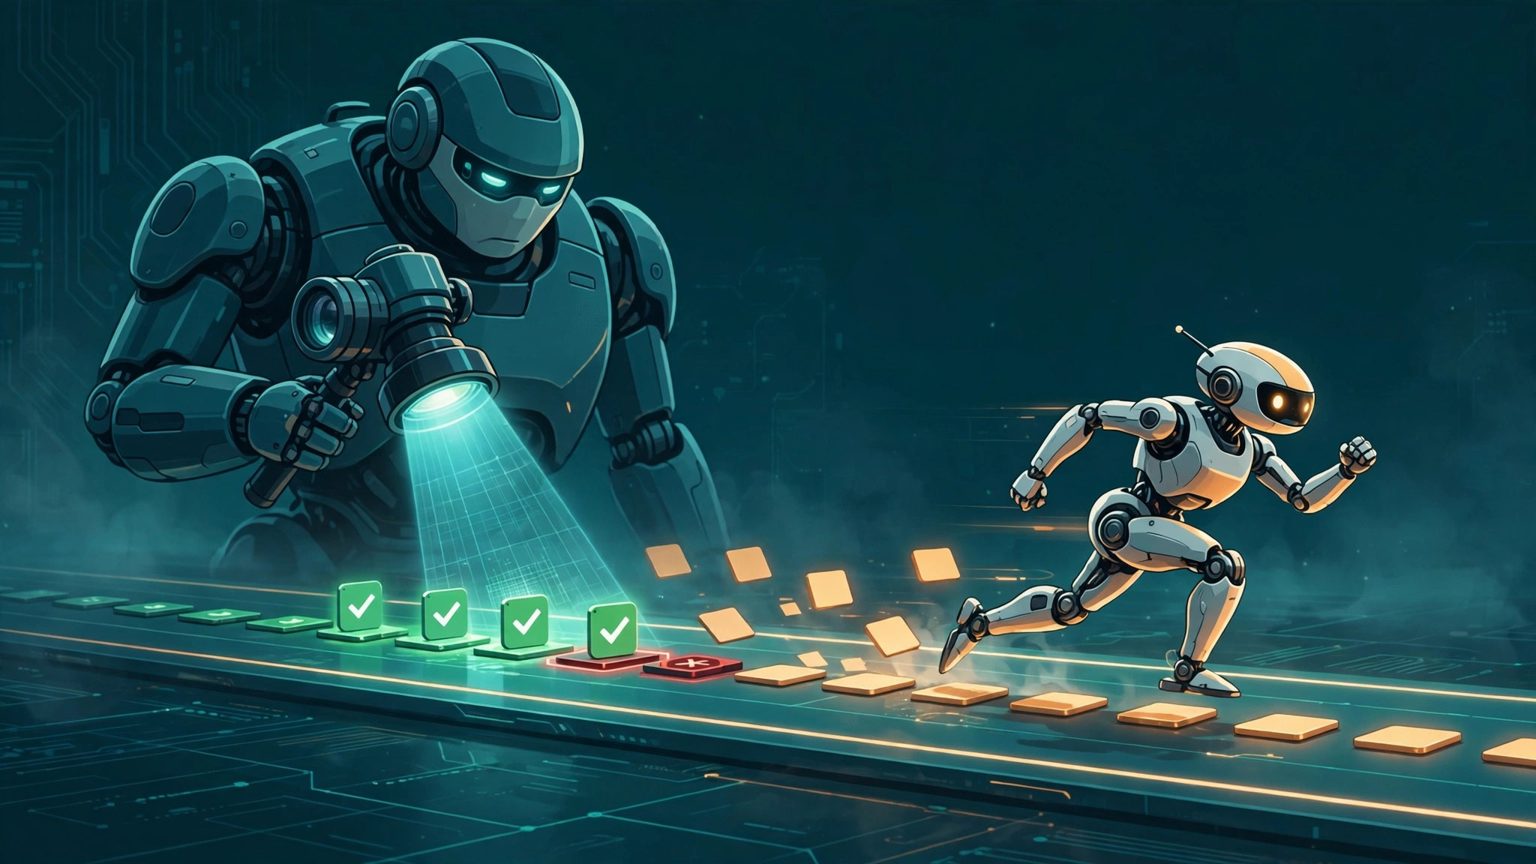
第二,强化学习。推理模型的标志性训练方法,是在数学、代码、逻辑题这类有客观对错的任务上,用强化学习训练它。答对了给奖励,答错了不给,模型在成千上万次试错里学会:在长推理链上自我检查、发现走偏了就回溯重来。OpenAI o1、DeepSeek-R1 都是这条路线的代表。
第三,蒸馏。大推理模型的思考过程可以作为训练数据,去训练更小的模型,让小模型也获得一部分推理能力——这就是模型蒸馏在推理模型上的应用。
有一个关键前提:强化学习需要"可验证的奖励信号"。数学题有标准答案,代码能跑通测试,所以训得好;开放式写作没有标准答案,强化学习就很难定义"写得好"的奖励。这也是推理模型在理科题上突飞猛进、在开放创作上优势不明显的原因之一。
推理模型 ≠ 思维链,别把两个概念混用
这是最容易混淆的一对概念:
- 思维链(CoT)是一种技术:通过提示词或生成方式,让模型把中间步骤写出来再给结论。你在普通模型前加一句"一步一步想",触发的就是思维链。
- 推理模型是一类模型:它在训练阶段就被专门优化成"默认先想再答",不需要你额外提示。
关系可以这样记:推理模型内部天然在使用思维链,但思维链不等于推理模型。就像"打草稿"是一种习惯,而推理模型是把"打草稿"练成了肌肉记忆的选手——它想得更久、更系统,也更擅长在思考中纠错。
关于推理模型的四个常见误解
误解一:推理模型不会犯错、不产生幻觉。错。推理过程本身也可能走错方向,只是"想得更久",不是"想得全对"。长推理链里第一步走偏,后面会越走越偏。事实性问题上,它照样可能一本正经地编造引用和数据。
误解二:跑分越高,就越适合我。数学、代码榜单测的是特定题型的解题能力,高分说明它在这些题上强,不代表它写文案、做客服、搞创意更强。选模型先看你的任务类型,再看分数。
误解三:所有问题都值得让模型多想一会儿。错。简单问题用推理模型,等于让博士生去算一加一:又慢又贵,答案还不一定更好。思考深度要和问题难度匹配。
误解四:思考过程展示出来,就等于可审计。多数产品展示的"思考过程"是加工过的摘要,不是完整的内部推导。它能帮你理解大致思路,但不能当作严格的审计依据。
什么时候用推理模型,什么时候不用
适合用的场景:数学证明与竞赛题、复杂代码的调试与算法设计、逻辑推理题、多步规划(比如行程、项目拆解)、需要自我验证的分析报告。
不适合的场景:文案写作、翻译、闲聊、简单问答、实时性要求高的对话。推理模型的首 token 延迟明显更长,等它"想完"可能要几十秒,不适合需要即时反馈的场合。
一个实用的判断方法:这个问题如果交给人类来做,也需要在草稿纸上演算几步,那就值得用推理模型;如果人类能脱口而出,普通模型就够了。
它的代价和限制
第一,慢。内部思考消耗大量 token,复杂问题的回答时间可能是普通模型的数倍到数十倍。
第二,贵。思考过程的 token 同样计费,长推理链的成本显著更高。按量付费的 API 场景下,选错模型类型会直接推高账单。
第三,过度思考。简单问题上,推理模型可能"想太多",给出绕弯子、过度复杂的答案,反而不如直接回答干净利落。
第四,事实性短板依旧。推理强的是"推导",不是"知识"。它不知道的事实,照样会编;它没见过的领域,推理链再长也推不出真东西。检索增强(RAG)解决的是知识问题,推理模型解决的是推导问题,两者互补,不互相替代。
第五,推理能力有边界。开放式、主观性强、缺乏客观评判标准的问题,强化学习难以给出有效奖励,推理模型的优势就发挥不出来。
Q:推理模型回答这么慢,能调快吗?
A:多数产品提供"思考深度"或"推理强度"档位,调低档位能明显提速,但复杂题的正确率会下降。如果任务简单,直接换普通模型更快更便宜。
Q:普通模型加"一步一步想"提示词,能代替推理模型吗?
A:能替代一部分。中等难度问题上,提示词触发的思维链效果不错;但高难度的数学、代码题上,专门训练的推理模型优势明显——它的"思考"是训练出来的能力,不是临时装出来的。