过拟合是指模型在训练数据上表现很好,一换到没见过的新数据就明显变差的现象。判断的关键不是训练分数本身,而是训练表现和新数据表现之间的落差:落差越大,模型越可能只是记住了训练内容,而不是学会了背后的规律。一份漂亮的训练成绩单,未必值得信任。
拿考试打比方最直观。学生把整本练习册的答案背下来,练习册上的题全对,试卷换了新题、换了问法就答不出来——问题不是不够努力,而是记住的是答案,不是解题方法。模型也一样:训练时它不断调整参数去降低训练数据上的错误,调得越久,训练分数越好看;可它记住的若是训练数据里的偶然细节、标注错误,到了新数据上只会把判断带偏。
记住答案和学会规律,差在哪
学会规律的模型抓住的是比较稳定的联系:题型、措辞、数字换了,还能按同一种方法推出答案。记住答案的模型靠的是对训练样本的复现:输入和见过的样本越像,答得越好;稍一走样,就只能硬套最接近的那条记忆。大语言模型里也有这种情形:某些高频段落它能逐字复现,可遇到换了说法、换了组合的新问题就答错,这时复现就成了问题。泛化能力说的正是“上考场”的本事,训练的目标不是把训练分数刷到最高,而是在泛化能力最好的那个点停下来,这一点常常比最高分出现得更早。
为什么会过拟合
常见的原因有四个。第一是数据不够用:数据量太小、覆盖面太窄、同类例子反复出现,模型没有足够多的不同样本去分辨“规律”和“巧合”,最省事的做法就是背下来;数据里混进的标注错误和固定偏见,也会被一并学进去。第二是模型容量相对任务太大:参数多、记忆力强的模型,有足够容量把每个训练样本的细节都存下来,小任务上尤其容易如此。第三是练得太久、太多遍:训练初期模型先学通用规律,继续练下去,训练误差还在降,模型开始啃只在训练集里成立的细节,连噪声都拟合上了。第四是评判标准只盯训练集:每次调参、选模型都只看训练分数,训练分高的做法就会被不断选中,哪怕它在新数据上更差。
别只看训练分数:用没见过的数据检验
发现过拟合的办法,是给模型准备它没见过的数据,并且全程不让它偷看。标准做法是把数据分成三份:训练集调参数,验证集在训练中做判断、选配置,测试集留到最后只做一次最终评估。验证集和测试集都不能参与训练,否则测的就不是新数据上的表现。
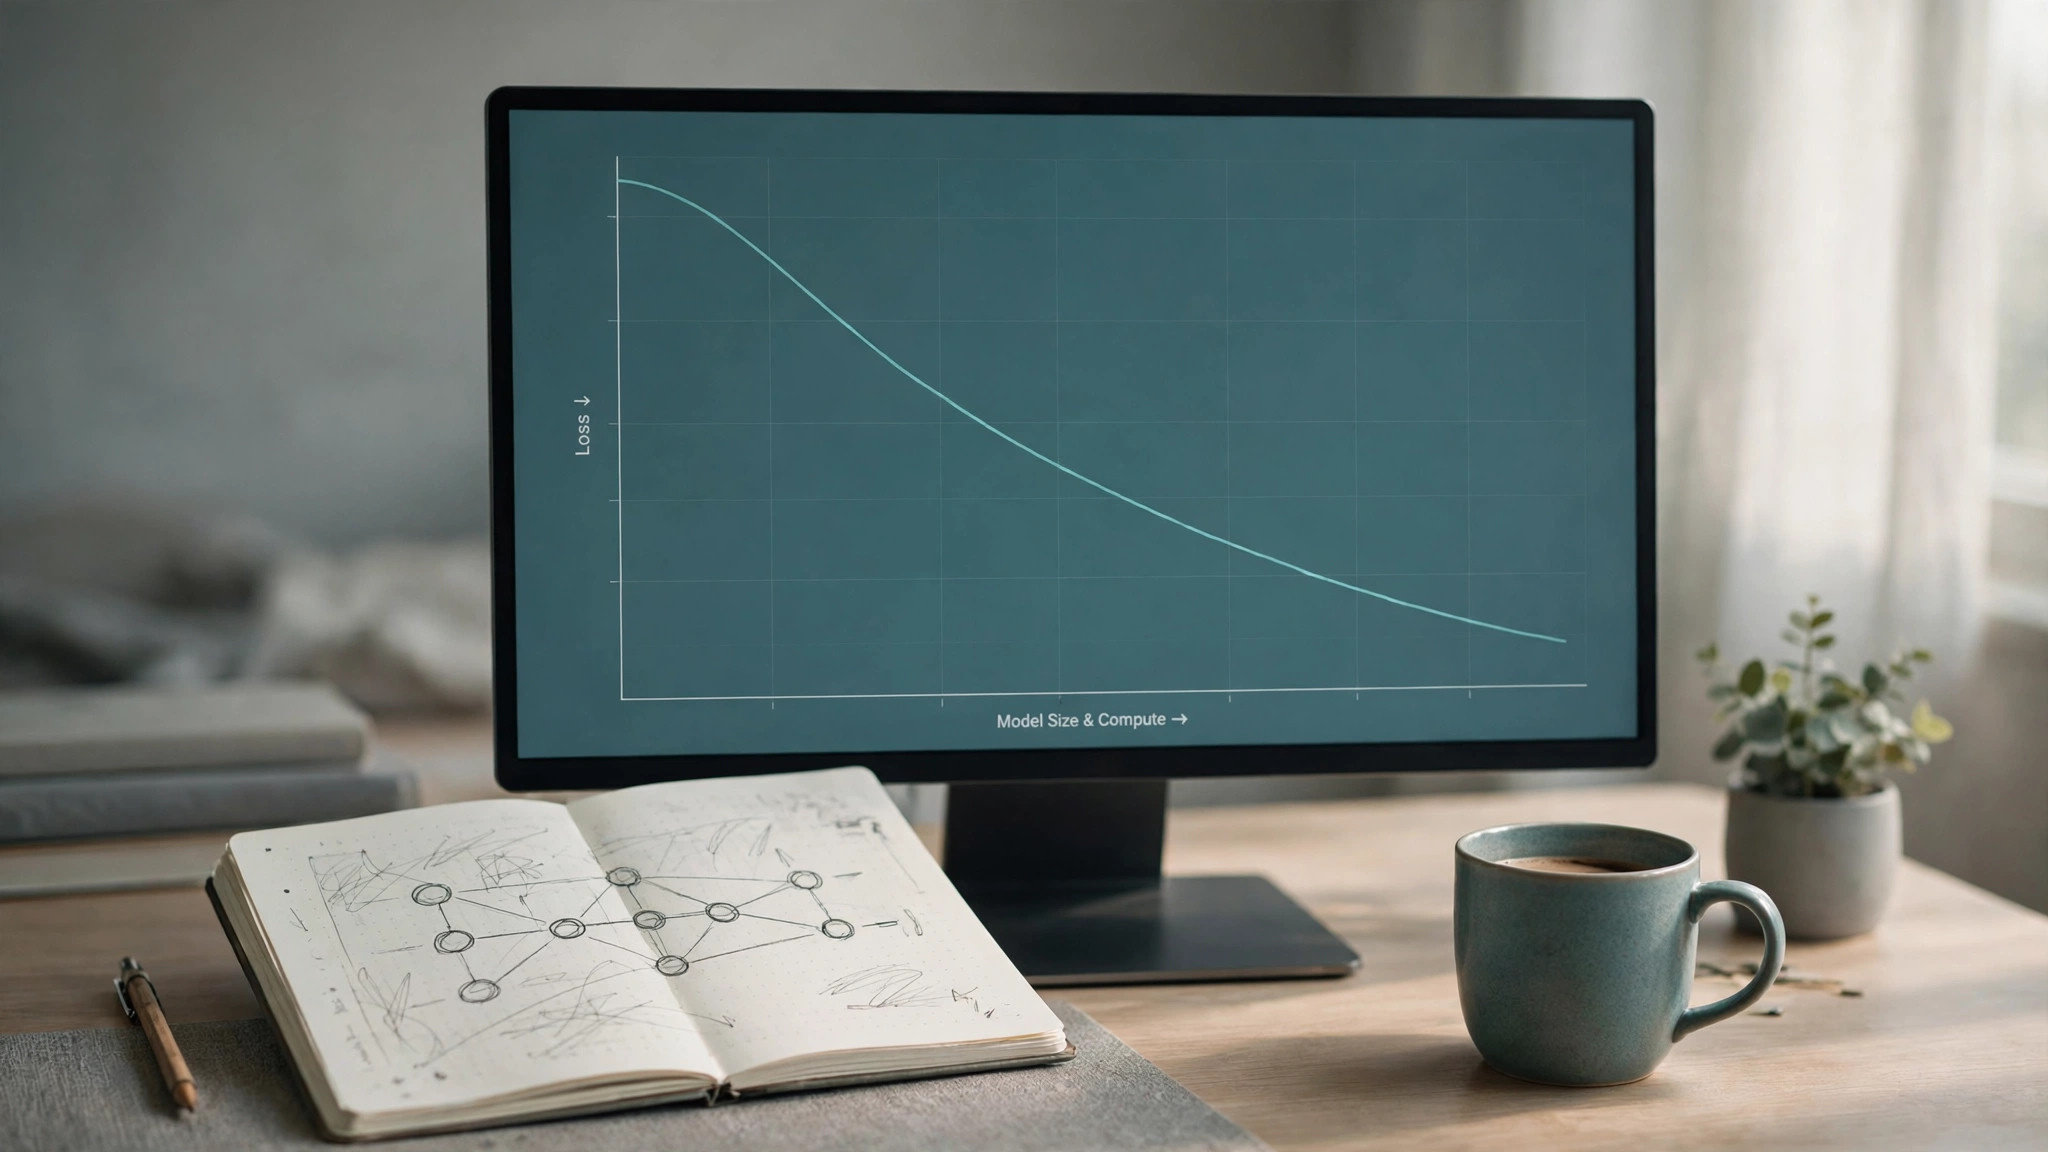
最直观的信号是训练表现和验证表现分叉:训练初期两条曲线一起变好,练到某个点之后,训练误差继续下降,验证误差却不再下降甚至回升,那个转折点附近往往就是泛化能力最好的位置。没有训练曲线可看时,也可以换种说法、换几个新例子反复检验:只在原题上答得漂亮、换个问法就走样,就是值得警惕的信号;但一两次抽查不能下结论,要看反复出现、方向一致的落差。
预训练和微调,风险并不相同
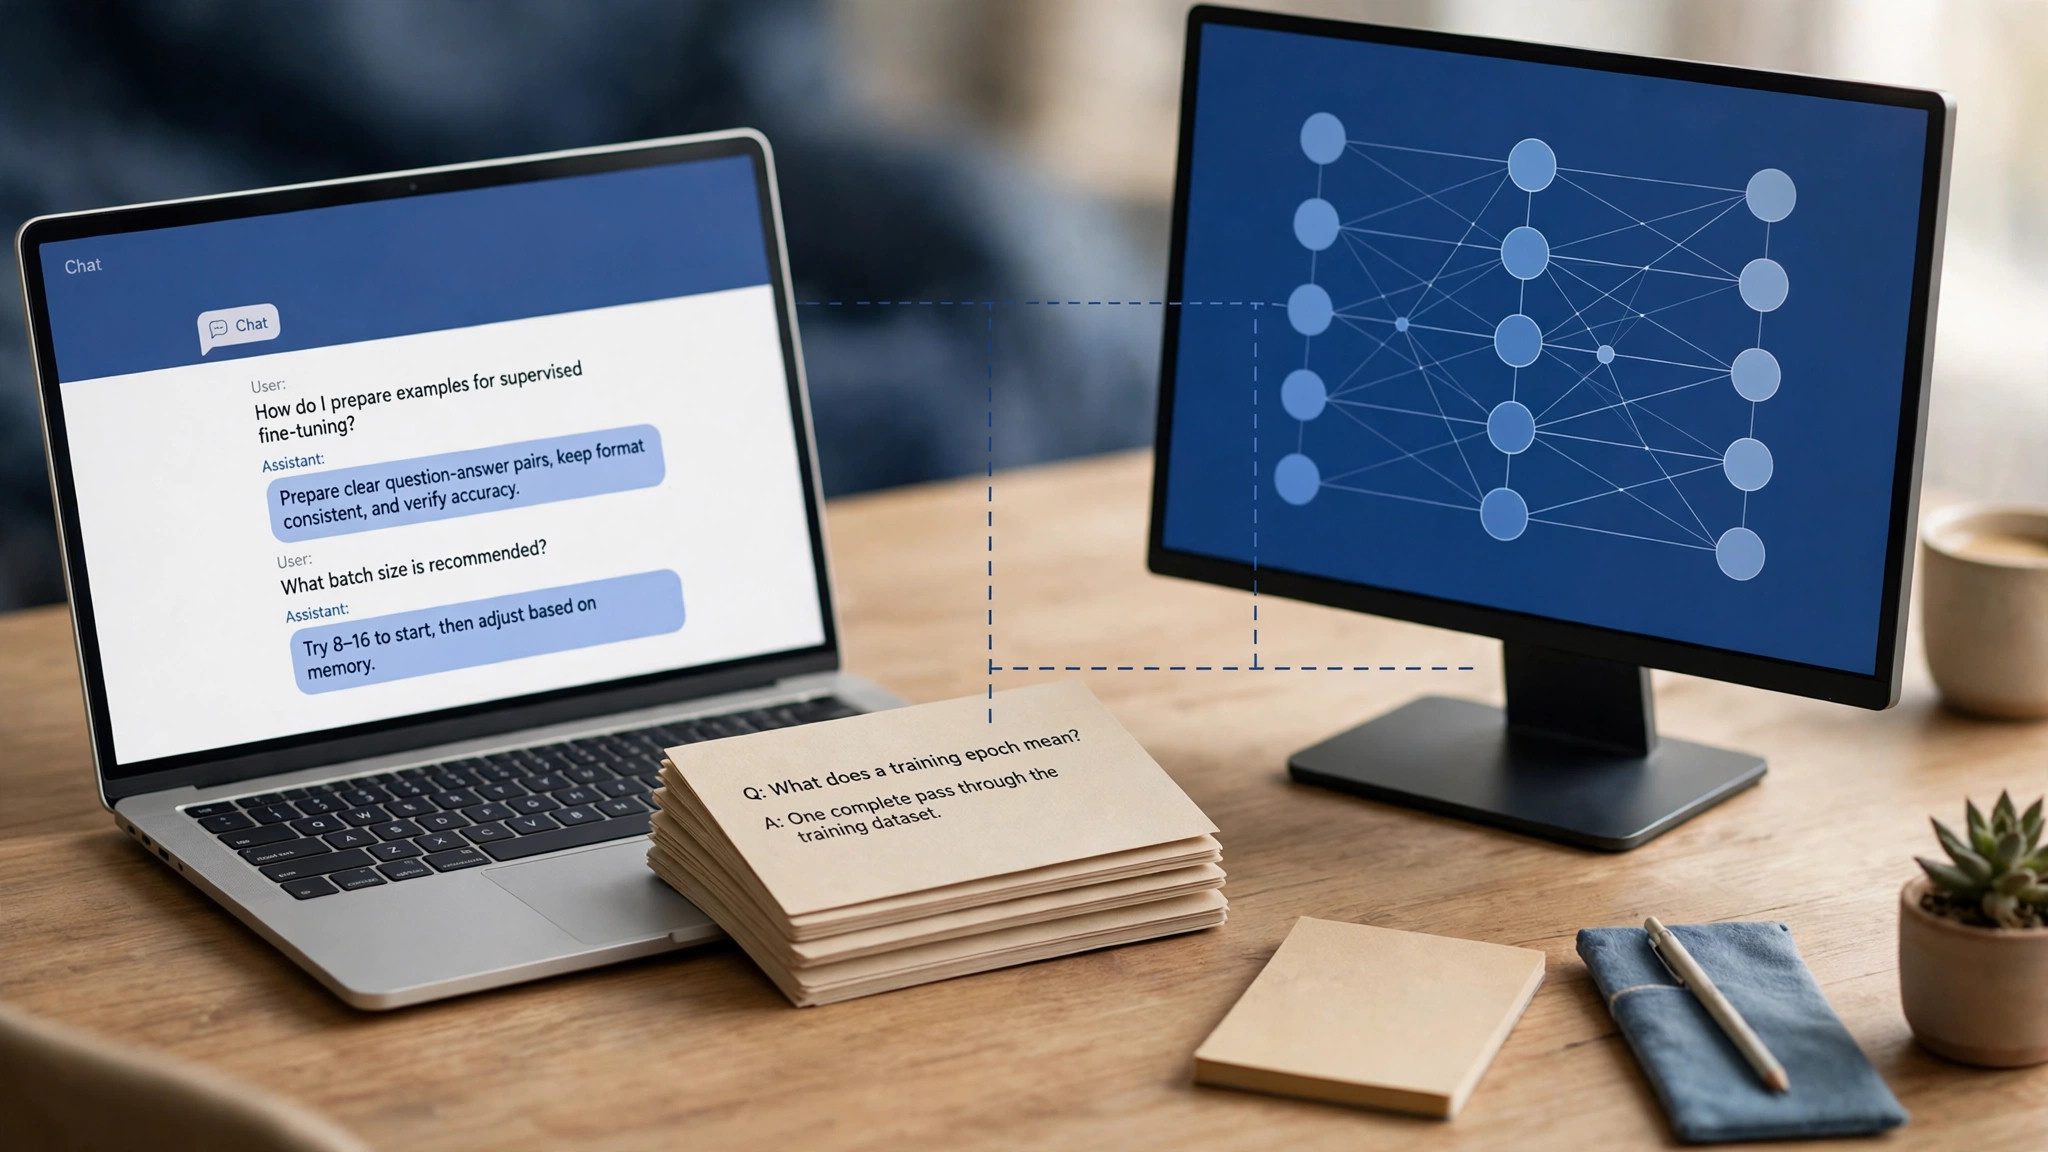
预训练用的是海量、多样、通常只过一遍的通用语料,模型很难把全部内容逐字背下来,经典意义上的过拟合不那么突出,更常见的是高频文本被过度记忆,或数据分布的偏见被放大。微调则处在另一个极端:数据往往只有几百到几千条,还要反复训练好几轮,模型很容易把样本背下来。监督微调里示例重复、风格高度统一时尤其明显:模型学会了示例的表面格式,却没学会背后的判断标准,换个领域就露馅。只训练一小部分参数的做法,例如低秩适配,会限制改动幅度,在一定程度上降低风险,但秩设得过大、轮数过多时同样会过拟合。
缓解办法都有代价
增加数据是最直接的路:更多、更多样、更干净的数据,让模型更难靠死记硬背蒙混过关;但重复、低质、分布单一的数据加再多,也补不上覆盖面的缺口。验证集加早停性价比很高:训练中定期在验证集上测一次,验证表现不再变好就停下,保留表现最好的那版参数;前提是验证集本身足够大、有代表性。正则化则是给模型加约束,让参数别调得太极端:权重衰减惩罚过大的参数,Dropout 在训练时随机“关掉”一部分神经元,逼模型不依赖某几个单元。约束太弱防不住,太强又会滑向学不好的另一个极端。简化模型、减少轮数、交叉验证也都是同一类权衡:拿容量、时长和计算成本,换更可靠的新数据表现,没有哪种办法能单独解决问题。
容易搞混的四个概念
欠拟合是过拟合的反面:模型连训练数据都没学好,训练和新数据表现都差,原因是容量太小或训练不足。幻觉是模型一本正经地编造事实和引用,它和过拟合可以同时出现,也可以各自独立,把幻觉都归咎于过拟合会找错办法。灾难性遗忘是微调的副作用:学会新任务的同时把原来会的东西忘了,它说的是旧能力丢了,过拟合说的是新数据上表现差。数据泄露则是评估毛病:测试数据混进训练集,模型“考前看过试卷”,分数虚高;分数好得不合常理时,先查数据有没有泄露,比先调模型更重要。
三个常见误解
一是训练分数高就等于模型好:没有验证集和测试集的对照,训练分数什么都说明不了。二是数据越多越不会过拟合:起作用的是多样性和质量,十万条重复样本的效果,可能还不如一万条分布均匀的样本。三是验证集调多了就不会过拟合:验证集用得太频繁、调得太细,调参过程也会“记住”验证集,验证分数跟着虚高;测试集要留到最后、只测一次,才守得住最后一道防线。
什么时候该担心
自己动手微调、数据只有几百上千条、任务很专的时候,防过拟合要当成默认动作:先分好验证集,再谈轮数和正则化。看厂商或论文的评测分数时,先问分数是在什么数据上测的、测试集有没有和训练集隔离,比纠结小数点后几位更有用。日常使用通用模型时,不必把每次答错都归为过拟合,先换个问法、给足上下文、核对关键事实,往往更能定位问题。归根结底,模型的好坏要在它没见过的数据上验证,养成这个习惯,训练分数和榜单排名都要先过“新数据上还成立吗”这一关,再决定信几分。