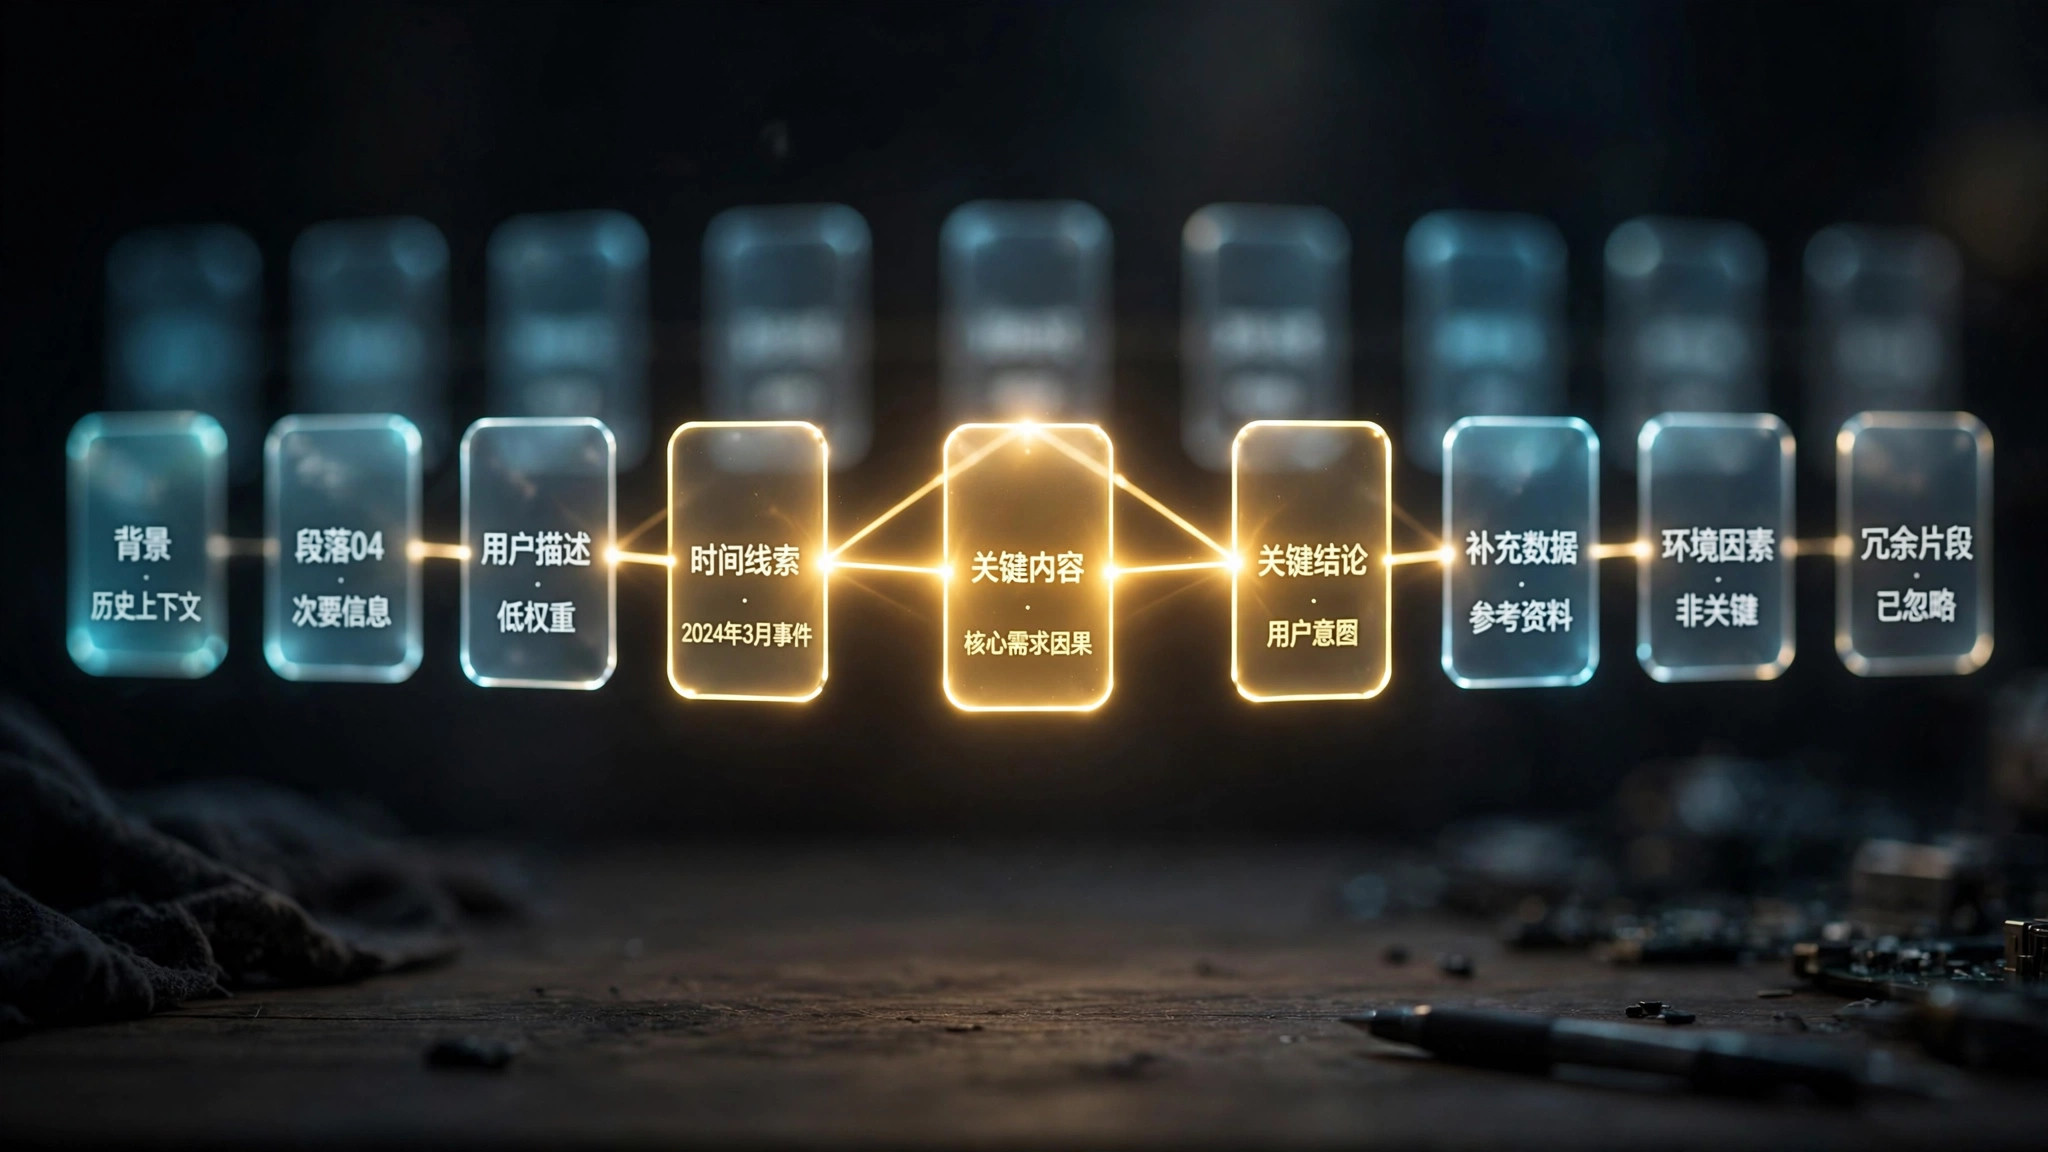
扩散模型是一种从纯噪声出发、经过多步逐步去噪来生成内容的模型:给它一句文字描述,它不会直接画出成品,而是先准备一张布满随机噪点的图,再一轮轮判断哪些噪点该去掉、画面该往哪个方向收紧,最后把噪声擦成一张符合描述的图片。Midjourney、Stable Diffusion、FLUX 等文生图工具,以及不少文生视频模型,底层用的都是这条路线。理解它,关键不在公式,而在它反直觉的顺序——先学会把好图弄脏,再学会把脏图擦干净。
训练时先学弄脏:加噪这一步在教什么
训练扩散模型时,研究者会拿一张真实图片,一步步往上加随机噪声:第一步只是轻微的颗粒感,几十步之后轮廓变糊,几百步之后整张图只剩下雪花一样的纯噪声。这个过程不需要模型参与,规则是固定的,难的是反过来那一步。
模型真正要学的是逆过程:在每一个噪声程度下,看着一张半脏不净的图,预测这一步加进去的噪声长什么样。只要能把噪声预测准,就能把它减掉,让图往清晰的方向退一步。训练数据里有海量图片,每张图都会在不同加噪程度下反复出现,模型就是在这种反复练习里,慢慢学会了什么样的像素组合像天空、像人脸、像一句提示词所描述的场景。它学的不是背下一张图,而是不同噪声水平下该往哪里擦。
这条思路最早在 2015 年被提出,2020 年的 DDPM 工作让它在图片质量上真正可用;2022 年的潜空间扩散把计算从原始像素搬到压缩后的潜空间里,成本大幅下降,Stable Diffusion 才得以在普通显卡上跑起来。
生成时在擦什么:几十步去噪如何听懂文字
生成阶段没有真实图片打底,起点就是一张随机噪声图。模型按训练时学会的本事,一步步预测并去掉噪声:早期几步先定下大轮廓和构图,中段逐渐长出物体和结构,后期才补纹理、光影和细节。步数越多,通常越精细,也越慢;步数太少,画面容易糊成一团。这就是文生图工具里步数、采样器这些设置存在的理由——它们控制的正是去噪走多少步、每一步怎么走。
文字是在每一步里同时起作用的。提示词会先被编码成向量,再在去噪时不断提醒模型:这一步该往有猫的方向擦,而不是往有狗的方向擦。实际系统还会同时跑一条不给文字的去噪路线,把两条路线的差异放大,这叫无分类器引导;引导强度调得越高,画面越贴提示词,但调得过头,颜色和结构也会变得生硬。随机种子则决定了起点的那团噪声长什么样,所以同一句提示词换个种子,出来的构图就会完全不同。
和逐词生成、GAN 相比,差在哪
扩散最容易和另外两条生成路线混在一起,分开看边界就清楚了:
| 对比项 | 大语言模型 | 扩散模型 | GAN |
|---|---|---|---|
| 生成方式 | 一个词接一个词往后写 | 从噪声图整幅逐步去噪 | 生成器一次画出整图 |
| 主要产物 | 文字、代码 | 图片、视频、音频 | 图片为主 |
| 出错时的样子 | 事实或逻辑说错 | 手指、文字、结构画错 | 容易模式单一、训练不稳 |
大语言模型是顺序生成,前面的词决定后面的词;扩散是整幅并行修改,每一步所有像素一起变。GAN 则是生成器和判别器互相较劲、一次成图,速度快,但训练容易失衡。扩散用多步换稳定和多样:它不靠对抗,而是每一步只做把图擦干净一点点这种小任务,所以更不容易崩,代价就是慢。在视频生成里,这个逻辑被沿用到连续帧上,模型还要同时保证前后帧连得上,计算量也随之再涨一截,相关能力可以对照多模态模型那篇一起看。
三个流传很广的误解
第一个误解是以为模型心里先有一张成品图,再故意把它打码展示。不是这样。生成时没有藏着的原图,画面是在去噪过程中逐步长出来的,中途改一句提示词,后面的走向就会变。
第二个误解是步数越多,图就一定越好。步数增加到一定程度后,收益会迅速变小,只剩等待变长;真正决定上限的是模型本身和提示词是否清楚。把步数从 20 拉到 100,通常不会把一张构图错误的图救回来。
第三个误解是扩散模型能完全照着文字精确执行。它擅长的是氛围、风格和大致内容,对精确计数、指定文字内容、复杂空间关系这类要求经常翻车:海报上的字拼错、要求五个人却画出六个,都是这条路线的常见短板,而不是某个产品没做好。
什么时候适合用,什么时候要留个心眼
需要高质量图片、插画、概念图,或者要做图生图、局部重绘、扩图时,扩散是目前最稳妥的主力:它对风格迁移和细节质感尤其擅长,图生图本质上就是拿一张已有图片加一部分噪声再去噪,所以能在保留大结构的同时换风格、换局部。
但有三类任务要提前降低预期。一是带文字的图:标题、商标字、表格这类内容,尽量留给后期排版软件补,不要指望一次生成就准确。二是要求严格一致的连续创作:同一个角色在多张图里保持同一张脸,单靠提示词很难锁定,需要额外的参考图或控制方法。三是对速度敏感的实时场景:多步去噪天然比一次成图慢,实时交互往往要靠减少步数、蒸馏加速或更小的模型来换速度,质量也会跟着打折。
下次再打开一个文生图工具,可以把进度条想象成擦玻璃的过程:起点什么都看不见,每擦一步,轮廓多清楚一点,文字则一直在旁边提醒该擦出什么。扩散模型是什么,说到底就是一种靠学会去噪来学会画画的方法——它不直接创造画面,它创造的是从混乱走向有序的那条路。