
大模型推理优化
从注意力架构、KV 缓存到量化与推测解码,追踪让大模型推理更快、显存更省的关键技术进展,帮你看懂每次提速背后的原理。
专题介绍
模型越来越大,推理成本成了真正的门槛。这个专题追踪注意力架构、KV 缓存优化、量化、推测解码、推理框架与部署调优等方向的实质进展:每次提速是怎么做到的、省了多少显存、代价是什么。适合关心模型落地成本与响应速度的开发者和产品团队。
MiniMax M3.1 Flash发布:推理快近三倍,智能体任务成本降70%
AI资讯 AI导航 19 次阅读
投机解码是什么?小模型先猜词,大模型一次验算为何更快
AI百科 AI导航 12 次阅读
Claude Opus 5.5快速模式正式可用:提速2.5倍,等待名单取消
AI资讯 AI导航 19 次阅读
Modal年化收入破10亿美元:完成7.5亿美元D轮,估值157.5亿
AI资讯 AI导航 13 次阅读
英特尔GPU D270正式发布:480GB大内存推理卡开始送样
AI资讯 AI导航 31 次阅读
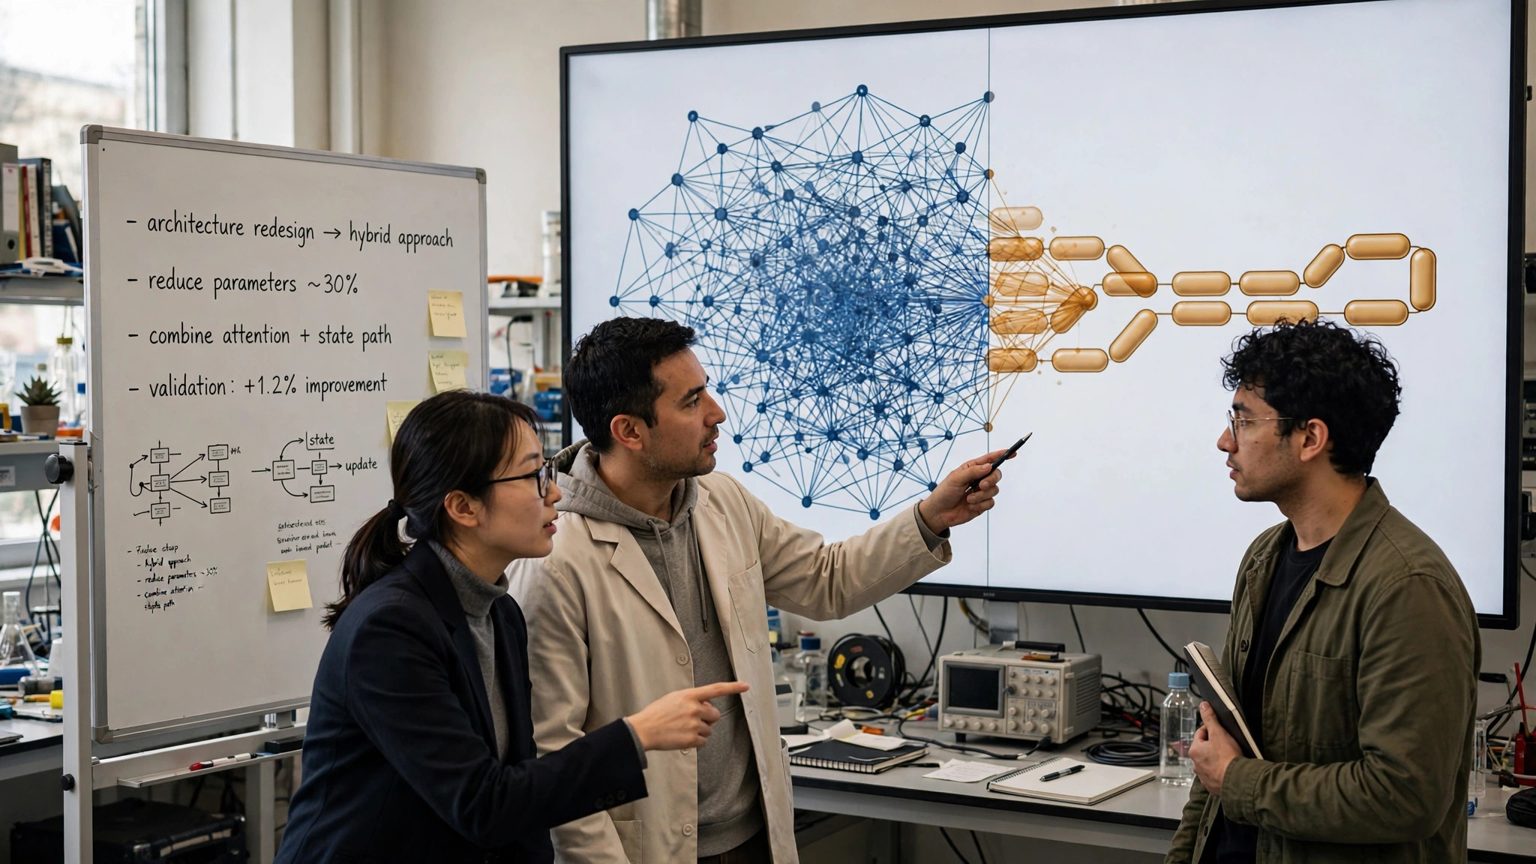
AWS提出Priming方法:旧Transformer改混合架构,成本降99%
AI资讯 AI导航 15 次阅读
微软Maia 300发布:每兆瓦token多40%,2027年成主力推理系统
AI资讯 AI导航 15 次阅读
无问芯穹完成23亿元C轮融资:累计43亿元创AI基础设施赛道纪录
AI资讯 AI导航 18 次阅读