少样本学习是一种让大模型快速适应新任务的方法:不重新训练、不修改任何参数,只在提问里附上少量示例——通常是几个到几十个「输入配上期望输出」的配对——模型看完这些示例,就能推断出任务的规则和输出格式,再照着处理没见过的新输入。很多人第一次给 AI 准备几个范例、发现它立刻学乖了,用的就是这一招;它要回答的核心问题是:既然不训练,几个例子凭什么能教会一个模型?
零个、一个、几个:先把数量这条线划清
少样本学习有一组按示例数量命名的亲戚。不给任何示例、只用一句话交代任务,叫零样本;只给一个示例,叫单样本;给几个到几十个,就是少样本。这套说法被广泛采用,源头是 OpenAI 在 2020 年发表的 GPT-3 论文《Language Models are Few-Shot Learners》:研究者把 1750 亿参数的模型放在这三种条件下测同一批任务,发现示例从无到有、从少到多,成绩通常随之上升,一些任务上甚至追平了专门微调过的模型,而整个过程没有做一次梯度更新。论文里少样本一般指塞进上下文的几十个示例;日常使用中大家没那么严格,给三五个范例也普遍叫少样本,关键不在具体数字,而在「靠示例而不是靠训练来教」。
示例写进上下文,模型到底学到了什么
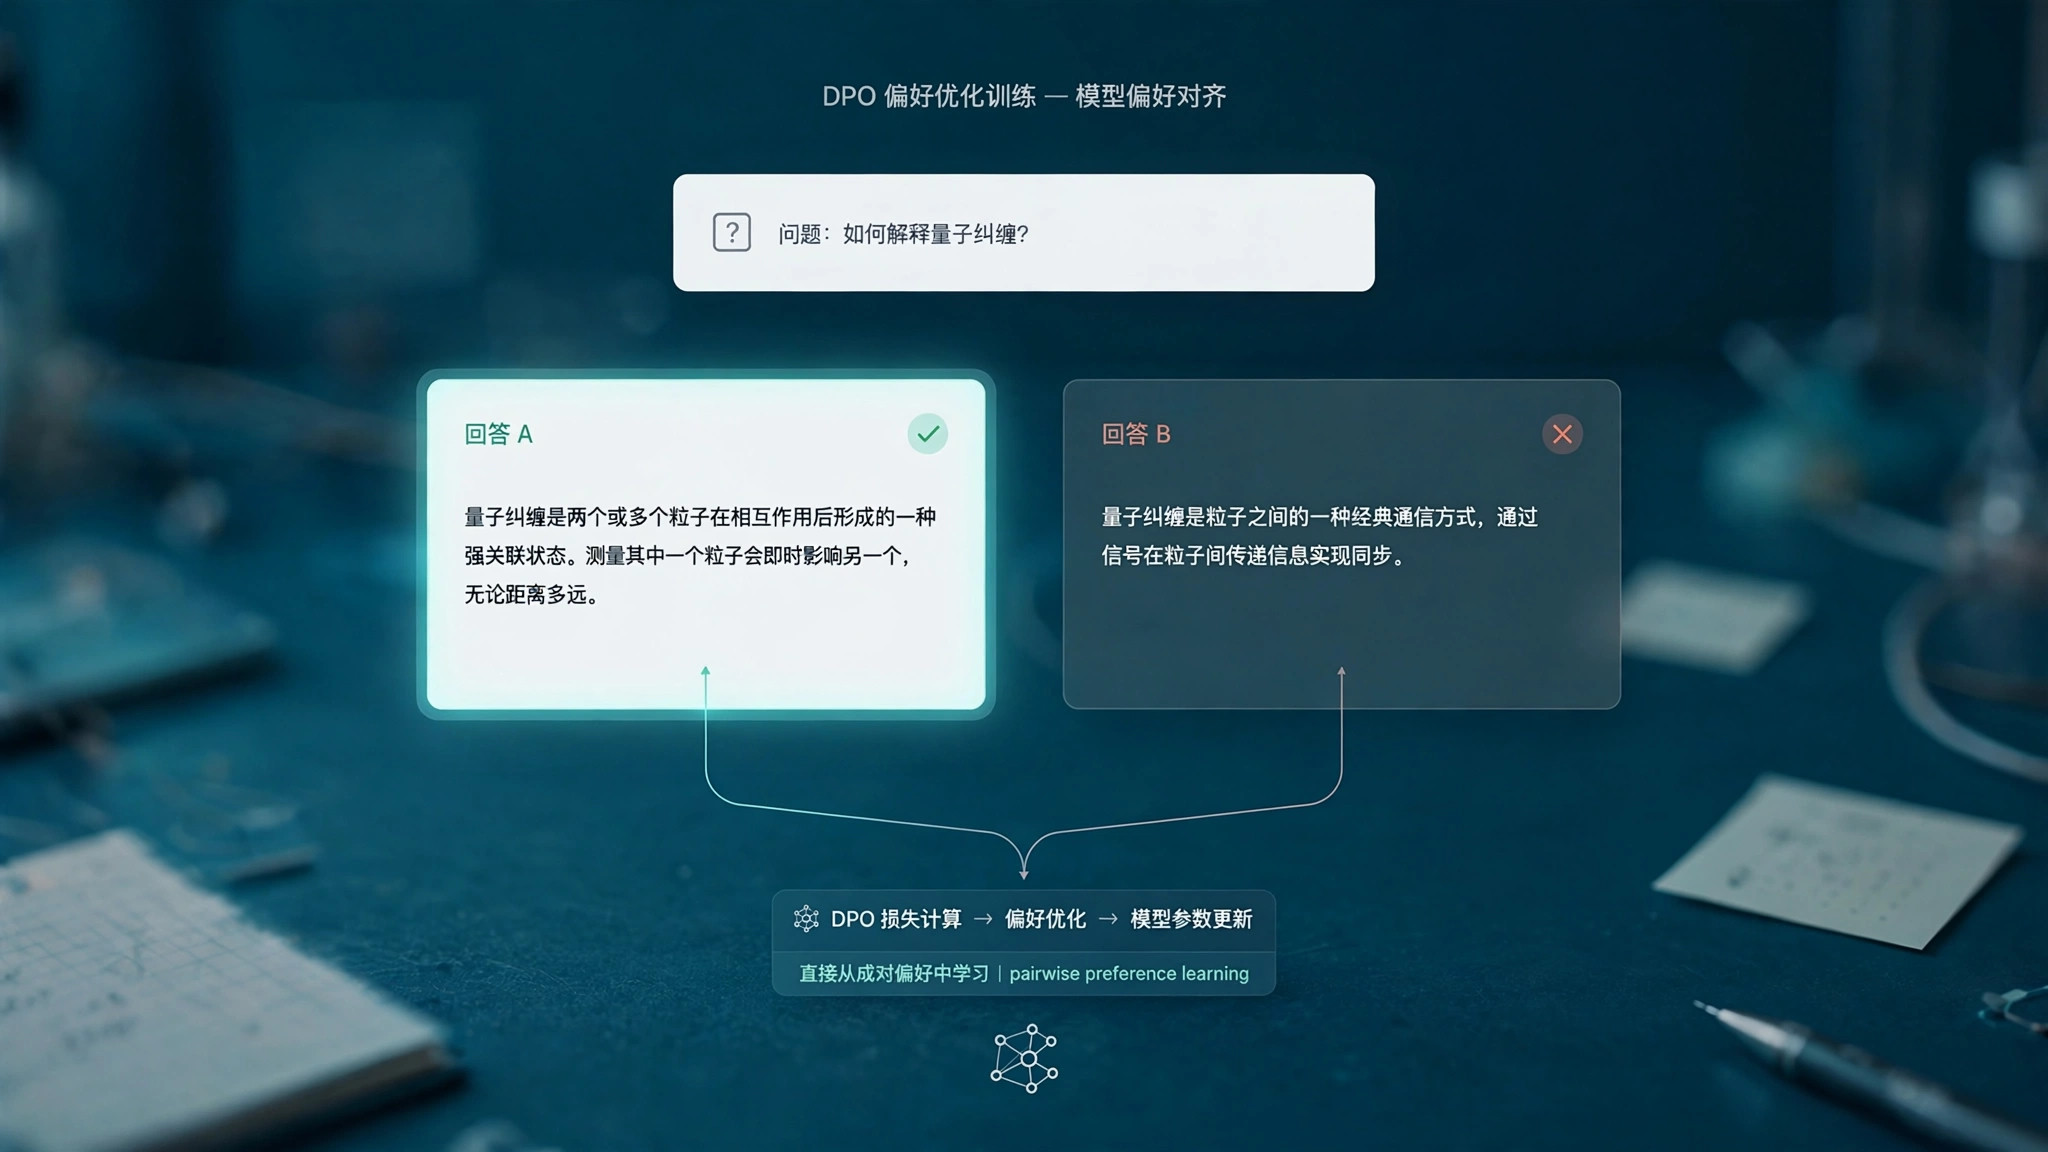
示例不是被存进了模型的长期记忆,而是作为当前这次输入的一部分,摆在问题前面。模型生成回答时,会把前面的文字全部纳入参考:它从示例里同时读出好几层信息——输出应该长什么格式、答案只能在哪个范围里选、判断的口径松紧如何、语气和详略该怎么拿捏。这正是它背后的机制「上下文学习」:预训练阶段见过海量文本的模型,本就擅长从一段文字里找规律、续写出符合规律的下文,示例等于把任务说明书换成了做好的样卷。打个比方,这像给新同事看三份已批好的同类文件:不用重新培训,他翻完就知道这类文件该怎么写、批到什么程度,接下来那份自然照着来——他的能力没变,变的是手边多了可参照的成例。
和零样本、微调摆在一起看,差别一目了然
三种教法动的东西完全不同。零样本只动嘴:把要求说清楚就行,成本最低,但格式和口径全靠模型猜,稳定性最差。少样本动的是输入:把示例写进提问,不碰参数,换个任务改掉示例就能立刻切换,代价是每次提问都要带着这些示例,占用上下文、也增加一点调用成本。微调动的则是模型本身:用成百上千条标注数据继续训练,权重真的被改掉,效果通常最稳、最持久,但要准备数据、花训练成本,换任务还得再来一遍。粗略地说,零样本适合随口一问,少样本适合「要求有点讲究、又不值得专门训练」的中间地带,微调适合长期高频、必须稳定达标的生产任务。
示例选得好不好,比放得多不多更重要
少样本效果飘忽,多半出在示例本身。第一,示例要覆盖真实分布:做评论分类,只给正面示例,模型会倾向于把拿不准的都判成正面,各类别的数量最好大致均衡,边界情况——比如带反讽的好评——值得专门放一两个。第二,格式必须从头到尾一致:分隔符、标签写法、输出长度都统一,模型照着抄格式时最怕示例自己先乱了套。第三,顺序也会影响结果:研究中反复观察到,把某个示例挪到最后、或让某一类示例扎堆出现在末尾,答案都会跟着偏,所以关键示例别都堆在一头,重要任务可以换两种顺序各跑一次再定。第四,别迷信数量:示例从零个加到五个往往提升明显,再往上边际收益快速变小,还挤占留给真实材料的上下文,塞进低质量示例更是直接带偏。与其凑数,不如把每个示例都当成会被逐字模仿的样卷来挑。
三个最常见的误解
第一个误解是以为模型被这几个示例「训练」了、以后会记得。不会。对话一结束,示例就随上下文一起消失,参数没有丝毫变化;下次打开新会话,它又回到只靠预训练知识的状态。第二个误解是把论文里的少样本和传统机器学习里的少样本混为一谈:后者是另一个研究方向,研究的是怎样只用每类几个标注样本去真正训练或适配一个模型,参数是会更新的。看到「少样本」三个字,先确认语境说的是给大模型看示例,还是拿少量数据做训练,两者别混。第三个误解是以为示例能教给模型它原本不知道的知识。示例教的是规则、格式和判断口径,不是事实:让模型按示例的格式整理它没学过的内部数据,它照样会一本正经地编。缺的是知识时该补资料或接检索,缺的是规矩时才轮到示例上场。
什么任务适合先试它,什么时候别硬撑
适合先试少样本的,是输出样式讲究、规则说得清却写不全的活儿:按固定口径给工单打标签、把杂乱文本抽成统一字段、按公司文风改写句子、先给几个判例再让它处理同类审核。这类任务共同点是「看例子比听描述学得快」,三五个好示例经常胜过一大段抽象要求。不适合硬撑的也有三类:规则复杂到示例举不完、错一次代价又高的生产环节,老老实实微调或加程序校验更稳妥;任务本身缺的是最新或内部知识,示例再多也变不出事实;输入材料本身就很长,上下文已经被占满,再塞几十个示例只会互相挤压。判断顺序不复杂:先零样本试一把,不稳就加几个精选示例,还不稳,再考虑微调这条重路——少样本的价值,本来就在于它是三者之中最便宜的那次尝试。